
Hive简单编程实践-词频统计
一、使用MapReduce的方式进行词频统计
(1)在HDFS用户目录下创建input文件夹
hdfs dfs -mkdir input
注意:林子雨老师的博客(http://dblab.xmu.edu.cn/blog/1080-2/)中是在hadoop目录下创建input文件,而MapReduce读取的是HDFS目录中的文件,因此笔者认为该博客存在错误。
(2)在hadopp根目录中创建两个测试文件file1.txt和file2.txt,并将他们拷贝到HDFS中的input目录下
echo "hello world" > file1.txt

echo "hello hadoop" > file2.txt
hdfs dfs -put file1.txt file2.txt input/
知识点延伸:
echo " hello world"  >  file1.txt    # 表示创建file1.txt

echo "nihao"   >> file1.txt     # 表示往file1.txt里追加内容

echo "" > file1.txt  # 表示清空file1.txt里的内容,但是文件中还存在空字符串

echo -n > file1.txt  # 清除文件的所有内容,包括空字符串
参考:https://linux.cn/article-8024-1.html
(3)调用MapReduce程序对input文件夹中的文件进行词频统计
cd  /usr/local/hadoop  #切换到hadoop目录下
hadoop jar share/hadoop/mapreduce/hadoop-mapreduce-examples-2.7.6.jar wordcount input output
注意:虽然输入目录是在hadoop目录下,但是自动生成的输出目录是在HDFS目录下的,如果HDFS目录下已存在output文件夹,就需要先删除,否则会出现下图所示的错误:

(4)执行结果

二、使用Hive完成词频统计(7行代码搞定)
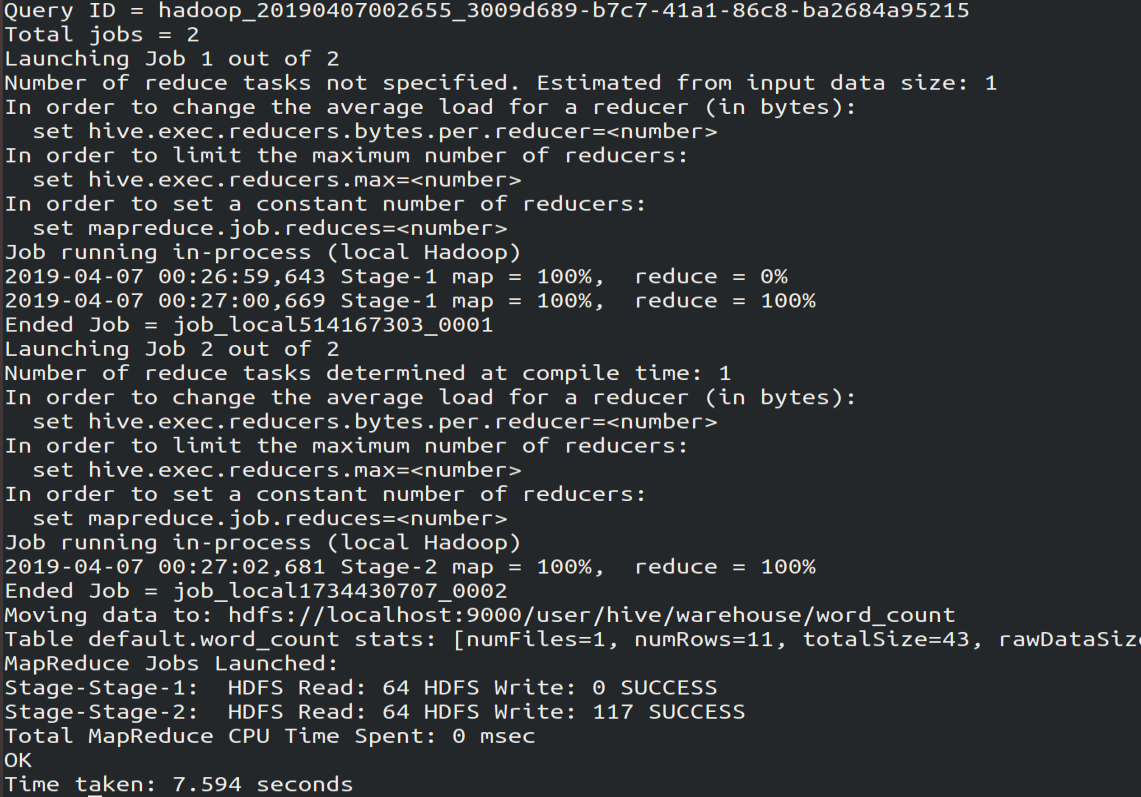
1.编写Hql代码
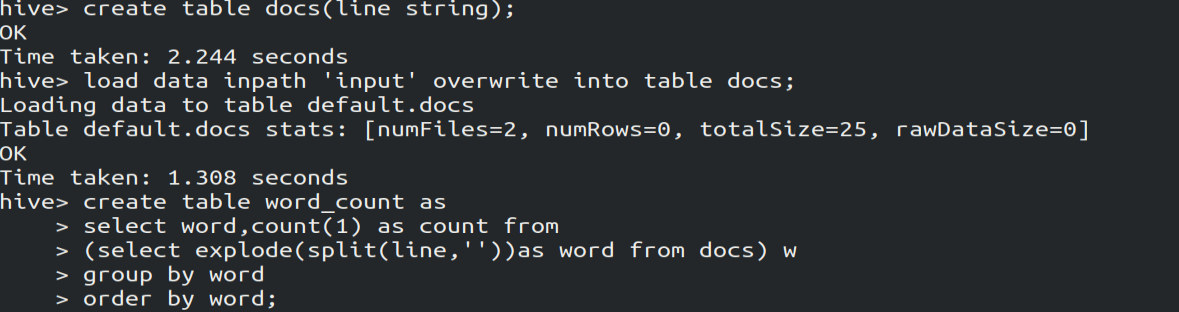
create table docs(line string); # 创建docs表并注明表里的数据类型是String

load data inpath 'input' overwrite into table docs;  # 向表中装载数据

create table word_count as  # 创建word_count表,将数据保存到该表

select word, count() as count from

(select explode(split(line,' '))as word from docs) w

group by word

order by word;
2.查询执行结果
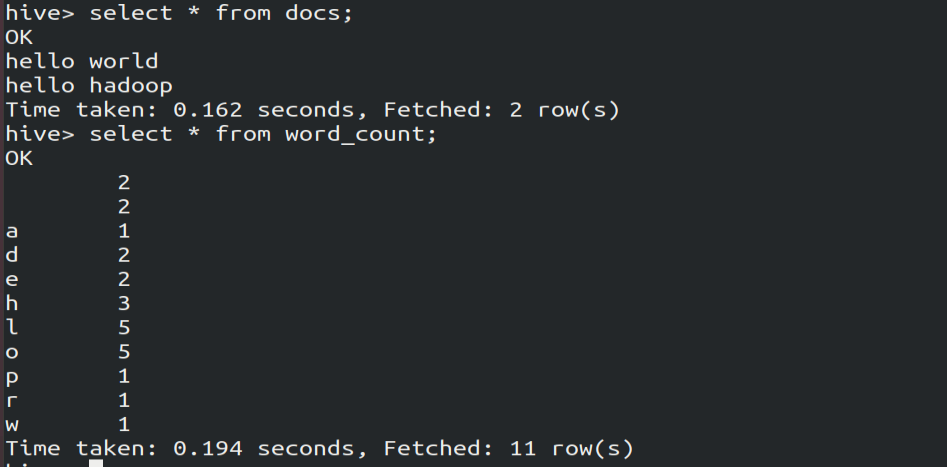
select * from word_count
Hive简单编程实践-词频统计的更多相关文章
- MapReduce编程:词频统计
首先在项目的src文件中需要加入以下文件,log4j的内容为: log4j.rootLogger=INFO, stdout log4j.appender.stdout=org.apache.log4j ...
- java - Socket简单编程实践
1.简介: 1)SOCKET是应用程序和网络之间的一个接口.SOCKET创建设置好以后,应用程序可以: 通过网络把数据发送到socket . 通过网络从socket接收数据.(通信的前提是应用程序知道 ...
- Hadoop上的中文分词与词频统计实践 (有待学习 http://www.cnblogs.com/jiejue/archive/2012/12/16/2820788.html)
解决问题的方案 Hadoop上的中文分词与词频统计实践 首先来推荐相关材料:http://xiaoxia.org/2011/12/18/map-reduce-program-of-rmm-word-c ...
- hive进行词频统计
统计文件信息: $ /opt/cdh-5.3.6/hadoop-2.5.0/bin/hdfs dfs -text /user/hadoop/wordcount/input/wc.input hadoo ...
- sqoop进行将Hive 词频统计的结果数据传输到Mysql中
使用sqoop进行将Hive 词频统计的结果数据传输到Mysql中. mysql准备接受数据的数据库与表 hive准备待传输的数据 sqoop进行数据传输 mysql查看传输结果 二:电子书 ...
- [Java 并发] Java并发编程实践 思维导图 - 第一章 简单介绍
阅读<Java并发编程实践>一书后整理的思维导图.
- hive学习01词频统计
词频统计 #创建表,只有一列,列名line create table word_count ( line string) row format delimited fields terminated ...
- 利用python实现简单词频统计、构建词云
1.利用jieba分词,排除停用词stopword之后,对文章中的词进行词频统计,并用matplotlib进行直方图展示 # coding: utf-8 import codecs import ma ...
- Storm实时计算:流操作入门编程实践
转自:http://shiyanjun.cn/archives/977.html Storm实时计算:流操作入门编程实践 Storm是一个分布式是实时计算系统,它设计了一种对流和计算的抽象,概念比 ...
随机推荐
- IIS 部署问题 404
在部署IIS环境中,偶尔会遇到 404 错误,就算以前遇到过,也因为时间久了导致大概知道是什么错了,具体解决方案觉忘了,所以留下一个记录,留给自己,也是给大家一点提醒.(注:错误信息也懒得截图了,希望 ...
- C++借助curses库实现俄罗斯方块
主要要实现如下几个功能:方块的移动控制.方块变形.判定方块是否接触边界和进行方块堆积.对方块进行消除. 1.方块的移动控制上下左右四个方向上-->变形,下-->加速下落,左-->向左 ...
- MY Views on Doctor-patient relationship 英语医患关系议论文
MY Views on Doctor-patient relationship Author:Pleiades_Antares(www.cnblogs.com/irischen) 1. In rece ...
- Git无法提交,报错
Failed at the ant-design-pro@2.2.1 lint-staged script. npm ERR! This is probably not a problem with ...
- vue-router 管理视图详解
什么是路由 在web开发中,路由是指根据url分配到对应的处理程序,当访问不同的url就会切换到对应的处理程序 在vue中一个url对应的就是一个组件,当访问不同的url,对应的组件就会呈现到页面中 ...
- chrome-performance页面性能分析使用教程
运行时性能表现(runtime performance)指的是当你的页面在浏览器运行时的性能表现,而不是在下载页面的时候的表现.这篇指南将会告诉你怎么用Chrome DevTools Performa ...
- BZOJ4327:[JSOI2012]玄武密码(SAM)
Description 在美丽的玄武湖畔,鸡鸣寺边,鸡笼山前,有一块富饶而秀美的土地,人们唤作进香河.相传一日,一缕紫气从天而至,只一瞬间便消失在了进香河中.老人们说,这是玄武神灵将天书藏匿在此. ...
- pytorch .detach() .detach_() 和 .data用于切断反向传播
参考:https://pytorch-cn.readthedocs.io/zh/latest/package_references/torch-autograd/#detachsource 当我们再训 ...
- solidity learning (1)
学习文档笔记:http://solidity-cn.readthedocs.io/zh/develop/layout-of-source-files.html 1.pragma solidity ^0 ...
- Java多线程(六)——线程让步
一.yield()介绍 yield()的作用是让步.它能让当前线程由“运行状态”进入到“就绪状态”,从而让其它具有相同优先级的等待线程获取执行权:但是,并不能保证在当前线程调用yield()之后,其它 ...