
Spark学习笔记3:键值对操作
键值对RDD通常用来进行聚合计算,Spark为包含键值对类型的RDD提供了一些专有的操作。这些RDD被称为pair RDD。pair RDD提供了并行操作各个键或跨节点重新进行数据分组的操作接口。
Spark中创建pair RDD的方法:存储键值对的数据格式会在读取时直接返回由其键值对数据组成的pair RDD,还可以使用map()函数将一个普通的RDD转为pair RDD。
- Pair RDD的转化操作
- reduceByKey() 与reduce类似 ,接收一个函数,并使用该函数对值进行合并,为每个数据集中的每个键进行并行的归约操作。返回一个由各键和对应键归约出来的结果值组成的新的RDD。例如 :上一章中单词计数的例子:val counts = words.map(word => (word,1)).reduceByKey{ case (x,y) => x + y}
- foldByKey()与fold()类似,都使用一个与RDD和合并函数中的数据类型相同的零值最为初始值。val counts = words.map(word => (word,1)).foldByKey{ case (x,y) => x + y}
- combineByKey()是最为常用的基于键进行聚合的函数,可以返回与输入类型不同的返回值。
理解combineByKey处理数据流程,首先需要知道combineByKey的createCombiner()函数用来创建那个键对应的累加器的初始值,mergeValue()方法将该键的累加器对应的当前值与这个新的值进行合并。mergeCombiners()方法将各个分区的结果进行合并。
使用combineByKey进行单词计数的例子:
import org.apache.spark.{SparkConf, SparkContext}

object word {
  def main(args: Array[String]): Unit = {
    val conf = new SparkConf().setMaster("local").setAppName("word")
    val sc = new SparkContext(conf)
    val input = sc.parallelize(List(("coffee",1),("coffee",2),("panda",3),("coffee",9)))
    val counts = input.combineByKey(
      (v) => (v,1),
      (acc:(Int,Int) ,v) => (acc._1 + v,acc._2+1),
      (acc1:(Int,Int),acc2:(Int,Int)) => (acc1._1 + acc2._1,acc1._2 + acc2._2)
    )
    counts.foreach(println)
  }
}
输出结果:
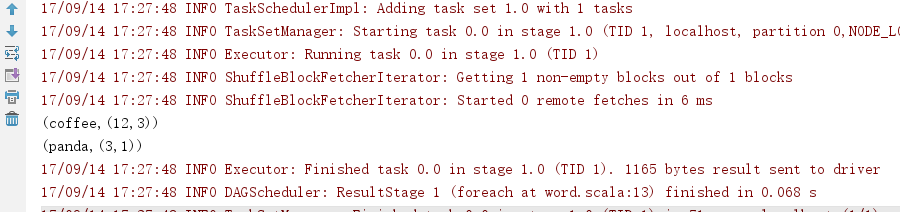
这个例子中的数据流示意图如下:
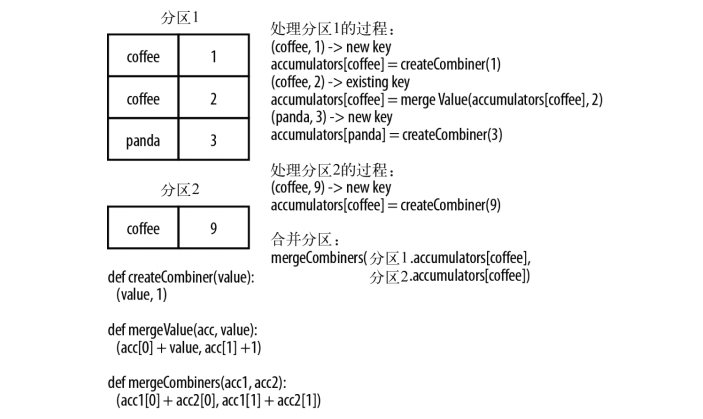
简单说过程就是,将输入键值对数据进行分区,每个分区先根据键计算相应的值以及键出现的次数。然后对不同分区进行合并得出最后的结果。
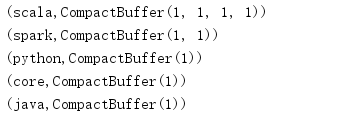
4.groupByKey()使用RDD中的键来对数据进行分组,对于一个由类型K的键和类型V的值组成的RDD,所得到的结果RDD类型会是[K, Iterable[V] ]
例如:
import org.apache.spark.{SparkConf, SparkContext}

object word {

  def main(args: Array[String]): Unit = {

    val conf = new SparkConf().setMaster("local").setAppName("word")

    val sc = new SparkContext(conf)

    val input = sc.parallelize(List("scala spark scala core scala python java spark scala"))

    val words = input.flatMap(line => line.split(" ")).map(word => (word,1))

    val counts = words.groupByKey()

    counts.foreach(println)

  }

}
输出:
5、cogroup函数对多个共享同一个键的RDD进行分组,对两个键类型均为K而值类型分别为V和W的RDD进行cogroup时,得到的结果RDD类型为[(K,(Iterable[V],Iterable[W]))]
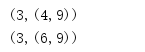
6、join(other)这样的连接是内连接,只有在两个pair RDD中都存在的键才输出。若一个输入对应的键有多个值时,生成的pair RDD会包括来自两个输入RDD的每一组相对应的记录。理解这句话看下面的例子:
val rdd = sc.parallelize(List((1,2),(3,4),(3,6)))

val other = sc.parallelize(List((3,9)))

val joins = rdd.join(other)
输出结果:
7、leftOuterJoin(other)左外连接和rightOuterJoin(other)右外连接都会根据键连接两个RDD,但是允许结果中存在其中的一个pair RDD所缺失的键。
val rdd = sc.parallelize(List((1,2),(3,4),(3,6)))

val other = sc.parallelize(List((3,9)))

val join1 = rdd.rightOuterJoin(other)
输出结果:
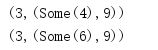
val rdd = sc.parallelize(List((1,2),(3,4),(3,6)))

val other = sc.parallelize(List((3,9)))

val join2 = rdd.leftOuterJoin(other)
输出结果:
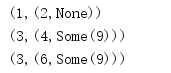
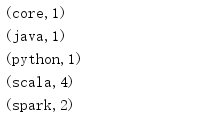
8、sortByKey()函数接收一个叫做ascending的参数,表示想要让结果升序排序还是降序排序。
val input = sc.parallelize(List("scala spark scala core scala python java spark scala"))

    val words = input.flatMap(line => line.split(" ")).map(word => (word,1)).reduceByKey((x,y)=>x+y)

    val counts = words.sortByKey()
输出结果:
- Pair RDD的行动操作
- countByKey() 对每个键对应的元素分别计数。
- collectAsMap()将结果以映射表的形式返回,注意后面的value会覆盖前面的。
val num = sc.parallelize(List((1,2),(3,4),(3,6)))

println(num.collectAsMap().mkString(" "))
输出结果:
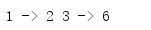
- lookup(key)返回给定键对应的所有值。
- 数据分区
Spark程序可以通过控制RDD分区方式来减少通信开销。
运行下面这段代码,用来查看用户查阅了自己订阅的主题的页面的数量,结果返回3:
val list1 =List(Tuple2("Mike",List("sports","math")),Tuple2("Jack",List("travel","book")))//UserID用户ID,UserInfo用户订阅的主题
val list2= List(Tuple2("Mike","sports"),Tuple2("Mike","stock"),Tuple2("Jack","travel"),Tuple2("Jack","book"))//UserID,LinkInfo用户访问情况
val userData = sc.parallelize(list1)
val events = sc.parallelize(list2)
userData.persist()
val joined = userData.join(events)
val results = joined.filter({
  case (id, (info, link)) =>
    info.contains(link)
}
).count()
println(results)
上面这段代码中,用到了join操作,会将两个数据集中的所有键的哈希值都求出来,将该哈希值相同的记录通过网络传到同一台机器上,然后在那台机器上对所有键相同的记录进行连接操作。
假如userdata表很大很大,而且几乎是不怎么变化的,那么每次都对userdata表进行哈希值计算和跨节点的数据混洗,就会产生很多的额外开销。
如下:
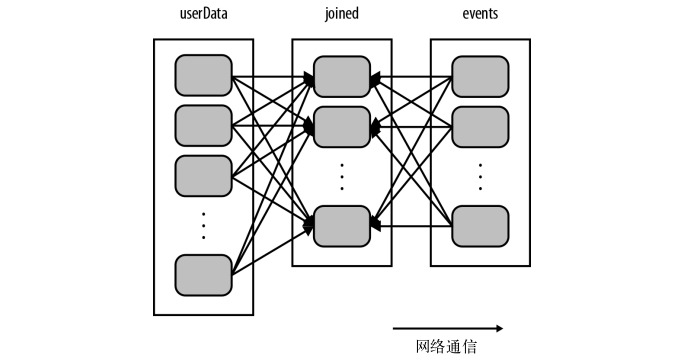
解决这一产生额外开销的方法就是,对userdata表使用partitionBy()转化操作,将这张表转为哈希分区。修改后的代码如下:
    val list1 =List(Tuple2("Mike",List("sports","math")),Tuple2("Jack",List("travel","book")))//UserID用户ID,UserInfo用户订阅的主题

    val list2= List(Tuple2("Mike","sports"),Tuple2("Mike","stock"),Tuple2("Jack","travel"),Tuple2("Jack","book"))//UserID,LinkInfo用户访问情况

    val userData = sc.parallelize(list1)

    val events = sc.parallelize(list2)

    userData.partitionBy(new DomainNamePartitioner(10)).persist()

    val joined = userData.join(events)

    val results = joined.filter({

      case (id, (info, link)) =>

        info.contains(link)

    }

    ).count()

    println(results)
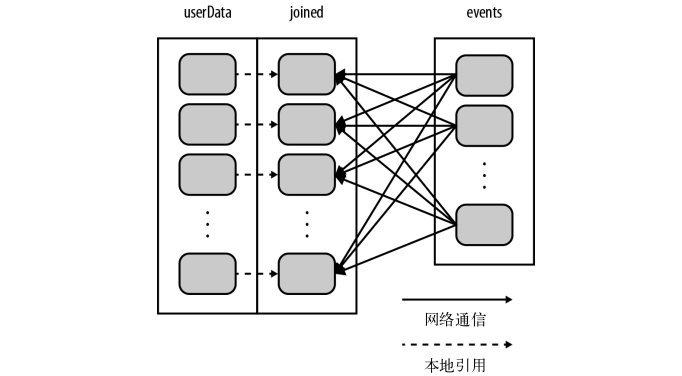
构建userData时调用了partitionBy(),在调用join()时,Spark只会对events进行数据混洗操作,将events中特定UserID的记录发送到userData的对应分区所在的那台机器上。这样,通过网络传输的数据就大大减少,程序运行速度也可以显著提升。partitionBy()是一个转化操作,因此它的返回值是一个新的RDD。
新的数据处理过程如下:
scala可以使用RDD的partitioner属性来获取RDD的分区方式,它会返回一个scala.Option对象。
可以从数据分区中获益的操作有cogroup() , groupWith() , join() , leftOuterJoin() , rightOuterJoin() , groupByKey() , reduceByKey() , combineByKey()以及lookup()。
实现自定义分区器,需要继承org.apache.spark.Partitioner类并实现下面的三个方法:
- numPartitions: Int :返回创建出来的分区数
- getPartition(key: Any):Int : 返回给定键的分区编号(0 到 numPartitions - 1)
- equals() : Java判断相等的方法,Spark用这个方法来检查分区器对象是否和其他分区器实例相同,这样Spark才可以判断两个RDD的分区方式是否相同。
Spark学习笔记3:键值对操作的更多相关文章
- 【原】Learning Spark (Python版) 学习笔记(二)----键值对、数据读取与保存、共享特性
本来应该上周更新的,结果碰上五一,懒癌发作,就推迟了 = =.以后还是要按时完成任务.废话不多说,第四章-第六章主要讲了三个内容:键值对.数据读取与保存与Spark的两个共享特性(累加器和广播变量). ...
- Spark学习之键值对操作总结
键值对 RDD 是 Spark 中许多操作所需要的常见数据类型.键值对 RDD 通常用来进行聚合计算.我们一般要先通过一些初始 ETL(抽取.转化.装载)操作来将数据转化为键值对形式.键值对 RDD ...
- Spark中的键值对操作-scala
1.PairRDD介绍 Spark为包含键值对类型的RDD提供了一些专有的操作.这些RDD被称为PairRDD.PairRDD提供了并行操作各个键或跨节点重新进行数据分组的操作接口.例如,Pa ...
- Spark中的键值对操作
1.PairRDD介绍 Spark为包含键值对类型的RDD提供了一些专有的操作.这些RDD被称为PairRDD.PairRDD提供了并行操作各个键或跨节点重新进行数据分组的操作接口.例如,Pa ...
- Spark学习笔记之SparkRDD
Spark学习笔记之SparkRDD 一. 基本概念 RDD(resilient distributed datasets)弹性分布式数据集. 来自于两方面 ① 内存集合和外部存储系统 ② ...
- Spark学习笔记3——RDD(下)
目录 Spark学习笔记3--RDD(下) 向Spark传递函数 通过匿名内部类 通过具名类传递 通过带参数的 Java 函数类传递 通过 lambda 表达式传递(仅限于 Java 8 及以上) 常 ...
- Spark学习笔记1——第一个Spark程序:单词数统计
Spark学习笔记1--第一个Spark程序:单词数统计 笔记摘抄自 [美] Holden Karau 等著的<Spark快速大数据分析> 添加依赖 通过 Maven 添加 Spark-c ...
- spark学习笔记总结-spark入门资料精化
Spark学习笔记 Spark简介 spark 可以很容易和yarn结合,直接调用HDFS.Hbase上面的数据,和hadoop结合.配置很容易. spark发展迅猛,框架比hadoop更加灵活实用. ...
- X-Cart 学习笔记(四)常见操作
目录 X-Cart 学习笔记(一)了解和安装X-Cart X-Cart 学习笔记(二)X-Cart框架1 X-Cart 学习笔记(三)X-Cart框架2 X-Cart 学习笔记(四)常见操作 五.常见 ...
- Spark学习笔记2——RDD(上)
目录 Spark学习笔记2--RDD(上) RDD是什么? 例子 创建 RDD 并行化方式 读取外部数据集方式 RDD 操作 转化操作 行动操作 惰性求值 Spark学习笔记2--RDD(上) 笔记摘 ...
随机推荐
- ios数据持久化(转)
文件系统 归档和序列化 数据库 1.文件系统 不管是Mac OS X 还是iOS的文件系统都是建立在UNIX文件系统基础之上的. 1.1 沙盒模型 在iOS中,一个App的读写权限只局限于自己的沙盒目 ...
- Linux更改中国时区
执行tzselect命令-->选择Asia-->选择China-->选择east China - Beijing, ->然后输入1 再执行 ln -sf /usr/share/ ...
- VC++实现解析快捷方式
VC++实现解析快捷方式: http://blog.csdn.net/mydreamremindme/article/details/9826745
- Shader的基本用法和语法结构
Shader的基本用法和语法结构 本文提供全流程,中文翻译.Chinar坚持将简单的生活方式,带给世人!(拥有更好的阅读体验 -- 高分辨率用户请根据需求调整网页缩放比例) 1 Introductio ...
- Windows10 解决 “/”应用程序中的服务器错误
部署 ASP.NET MVC5程序时,访问网站出现 未能加载文件或程序集“698_BLL”或它的某一个依赖项.试图加载格式不正确的程序. ================= 解决办法: 1.打开IIS ...
- 《DSP using MATLAB》Problem 4.15
只会做前两个, 代码: %% ---------------------------------------------------------------------------- %% Outpu ...
- Array.prototype.slice.call(arguments)探究
Array.prototype.slice.call(arguments)能将具有length属性的对象转成数组 首先,slice有两个用法,一个是String.slice,一个是Array.slic ...
- MySQL Transaction--RR事务隔离级别下加锁测试
============================================================================== 按照非索引列更新 在可重复读的事务隔离级别 ...
- ASP.NET vNext:微软下一代云环境Web开发框架
作者 郭蕾 发布于 2014年5月16日 在5月12日的TechED大会上,微软首次向外界介绍了下一代ASP.NET框架——ASP.NET vNext.ASP.NET vNext专门针对云环境和服 ...
- nodejs 使用express开发获取其他网站引用本站点js文件的参数
nodejs进行站点的开发其性能是很好的,在js 大行其道的天下,使用js基本上可以干好多只要我们能想到的东西,我们可以使用js文件进行用户验证等等. 这次我们就使用express 进行获取其他站点引 ...