
tesnorflow实现N个epoch训练数据读取的办法
https://blog.csdn.net/lujiandong1/article/details/53991373
方式一:不显示设置读取N个epoch的数据,而是使用循环,每次从训练的文件中随机读取一个batch_size的数据,直至最后读取的数据量达到N个epoch。说明,这个方式来实现epoch的输入是不合理。不是说每个样本都会被读取到的。
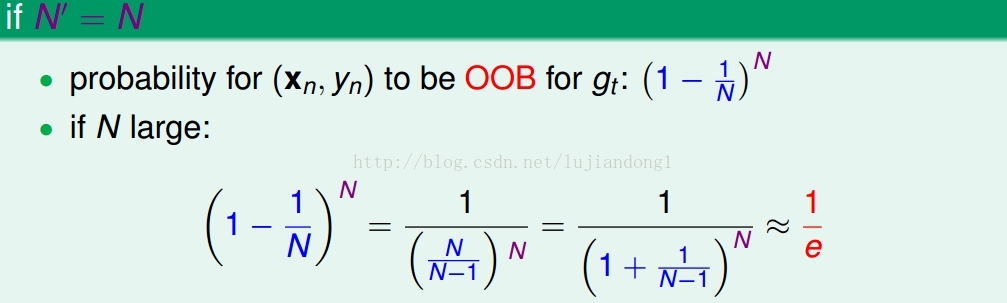
对于这个的解释,从数学上解释,比如说有放回的抽样,每次抽取一个样本,抽取N次,总样本数为N个。那么,这样抽取过一轮之后,该样本也是会有1/e的概率没有被抽取到。所以,如果使用这种方式去训练的话,理论上是没有用到全部的数据集去训练的,很可能会造成过拟合的现象。
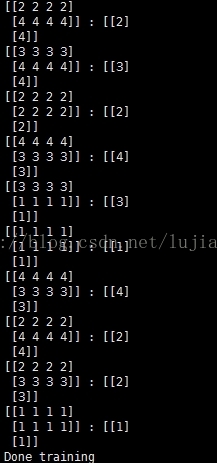
我做了个小实验验证:
- import tensorflow as tf
- import numpy as np
- import datetime,sys
- from tensorflow.contrib import learn
- from model import CCPM
- training_epochs = 5
- train_num = 4
- # 运行Graph
- with tf.Session() as sess:
- #定义模型
- BATCH_SIZE = 2
- # 构建训练数据输入的队列
- # 生成一个先入先出队列和一个QueueRunner,生成文件名队列
- filenames = ['a.csv']
- filename_queue = tf.train.string_input_producer(filenames, shuffle=True)
- # 定义Reader
- reader = tf.TextLineReader()
- key, value = reader.read(filename_queue)
- # 定义Decoder
- # 编码后的数据字段有24,其中22维是特征字段,2维是lable字段,label是二分类经过one-hot编码后的字段
- #更改了特征,使用不同的解析参数
- record_defaults = [[1]]*5
- col1,col2,col3,col4,col5 = tf.decode_csv(value,record_defaults=record_defaults)
- features = tf.pack([col1,col2,col3,col4])
- label = tf.pack([col5])
- example_batch, label_batch = tf.train.shuffle_batch([features,label], batch_size=BATCH_SIZE, capacity=20000, min_after_dequeue=4000, num_threads=2)
- sess.run(tf.initialize_all_variables())
- coord = tf.train.Coordinator()#创建一个协调器,管理线程
- threads = tf.train.start_queue_runners(coord=coord)#启动QueueRunner, 此时文件名队列已经进队。
- #开始一个epoch的训练
- for epoch in range(training_epochs):
- total_batch = int(train_num/BATCH_SIZE)
- #开始一个epoch的训练
- for i in range(total_batch):
- X,Y = sess.run([example_batch, label_batch])
- print X,':',Y
- coord.request_stop()
- coord.join(threads)
toy data a.csv:

说明:输出如下,可以看出并不是每个样本都被遍历5次,其实这样的话,对于DL的训练会产生很大的影响,并不是每个样本都被使用同样的次数。

方式二:显示设置epoch的数目
- #-*- coding:utf-8 -*-
- import tensorflow as tf
- import numpy as np
- import datetime,sys
- from tensorflow.contrib import learn
- from model import CCPM
- training_epochs = 5
- train_num = 4
- # 运行Graph
- with tf.Session() as sess:
- #定义模型
- BATCH_SIZE = 2
- # 构建训练数据输入的队列
- # 生成一个先入先出队列和一个QueueRunner,生成文件名队列
- filenames = ['a.csv']
- filename_queue = tf.train.string_input_producer(filenames, shuffle=True,num_epochs=training_epochs)
- # 定义Reader
- reader = tf.TextLineReader()
- key, value = reader.read(filename_queue)
- # 定义Decoder
- # 编码后的数据字段有24,其中22维是特征字段,2维是lable字段,label是二分类经过one-hot编码后的字段
- #更改了特征,使用不同的解析参数
- record_defaults = [[1]]*5
- col1,col2,col3,col4,col5 = tf.decode_csv(value,record_defaults=record_defaults)
- features = tf.pack([col1,col2,col3,col4])
- label = tf.pack([col5])
- example_batch, label_batch = tf.train.shuffle_batch([features,label], batch_size=BATCH_SIZE, capacity=20000, min_after_dequeue=4000, num_threads=2)
- sess.run(tf.initialize_local_variables())
- sess.run(tf.initialize_all_variables())
- coord = tf.train.Coordinator()#创建一个协调器,管理线程
- threads = tf.train.start_queue_runners(coord=coord)#启动QueueRunner, 此时文件名队列已经进队。
- try:
- #开始一个epoch的训练
- while not coord.should_stop():
- total_batch = int(train_num/BATCH_SIZE)
- #开始一个epoch的训练
- for i in range(total_batch):
- X,Y = sess.run([example_batch, label_batch])
- print X,':',Y
- except tf.errors.OutOfRangeError:
- print('Done training')
- finally:
- coord.request_stop()
- coord.join(threads)
说明:输出如下,可以看出每个样本都被访问5次,这才是合理的设置epoch数据的方式。
http://stats.stackexchange.com/questions/242004/why-do-neural-network-researchers-care-about-epochs
说明:这个博客也在探讨,为什么深度网络的训练中,要使用epoch,即要把训练样本全部过一遍.而不是随机有放回的从里面抽样batch_size个样本.在博客中,别人的实验结果是如果采用有放回抽样的这种方式来进行SGD的训练.其实网络见不到全部的数据集,推导过程如上所示.所以,网络的收敛速度比较慢.
tesnorflow实现N个epoch训练数据读取的办法的更多相关文章
- tensorflow读取训练数据方法
1. 预加载数据 Preloaded data # coding: utf-8 import tensorflow as tf # 设计Graph x1 = tf.constant([2, 3, 4] ...
- TensorFlow Distribution(分布式中的数据读取和训练)
本文目的 在介绍estimator分布式的时候,官方文档由于版本更新导致与接口不一致.具体是:在estimator分布式当中,使用dataset作为数据输入,在1.12版本中,数据训练只是datase ...
- TensorFlow实践笔记(一):数据读取
本文整理了TensorFlow中的数据读取方法,在TensorFlow中主要有三种方法读取数据: Feeding:由Python提供数据. Preloaded data:预加载数据. Reading ...
- 『TensorFlow』数据读取类_data.Dataset
一.资料 参考原文: TensorFlow全新的数据读取方式:Dataset API入门教程 API接口简介: TensorFlow的数据集 二.背景 注意,在TensorFlow 1.3中,Data ...
- tensorflow之数据读取探究(1)
Tensorflow中之前主要用的数据读取方式主要有: 建立placeholder,然后使用feed_dict将数据feed进placeholder进行使用.使用这种方法十分灵活,可以一下子将所有数据 ...
- TensorFlow数据读取方式:Dataset API
英文详细版参考:https://www.cnblogs.com/jins-note/p/10243716.html Dataset API是TensorFlow 1.3版本中引入的一个新的模块,主要服 ...
- tensoflow数据读取
数据读取 TensorFlow程序读取数据一共有3种方法: 供给数据(Feeding): 在TensorFlow程序运行的每一步, 让Python代码来供给数据. 从文件读取数据: 在TensorFl ...
- TF Boys (TensorFlow Boys ) 养成记(二): TensorFlow 数据读取
TensorFlow 的 How-Tos,讲解了这么几点: 1. 变量:创建,初始化,保存,加载,共享: 2. TensorFlow 的可视化学习,(r0.12版本后,加入了Embedding Vis ...
- 详解Tensorflow数据读取有三种方式(next_batch)
转自:https://blog.csdn.net/lujiandong1/article/details/53376802 Tensorflow数据读取有三种方式: Preloaded data: 预 ...
随机推荐
- npm 升级自身
用cue-cli 生成新项目 提示升级npm 解决方案: npm install -g npm 呵呵呵,简直太简单了 然而今天是2016.11.11
- 【转载】GetDeviceCaps()函数相关说明
CDC::GetDeviceCaps()物理长度与屏幕像素间的转换 作用:读取DC的一些打印区域信息,主要是像素和英寸方面的数据. 声明:GetDeviceCaps(int ) 使用例子://所有像素 ...
- ibatis的缓存机制
Cache 在特定硬件基础上(同时假设系统不存在设计上的缺漏和糟糕低效的SQL 语句)Cache往往是提升系统性能的最关键因素). 相对Hibernate 等封装较为严密的 ...
- 推荐13个.Net开源的网络爬虫
1:.Net开源的跨平台爬虫框架 DotnetSpider Star:430 DotnetSpider这是国人开源的一个跨平台.高性能.轻量级的爬虫软件,采用 C# 开发.目前是.Net开源爬虫最为优 ...
- C#后台调用LPT1端口实现小票机打印方法。
public class POSPrinter { const int OPEN_EXISTING = 3; string prnPort = "LPT1"; [DllImport ...
- UVA 303 Pipe
点击打开链接 题意: 求光线能达到的最大横坐标 注意光线可以和管道重合 也可以经过转折点 解法: 枚举每种光线是否能通过每个转折点的截面(线段)即可 //大白p263 #include <cma ...
- 在im4java中使用GraphicsMagick
1.定义操作和命令GMOperation op = new GMOperation();GraphicsMagickCmd cmd = new GraphicsMagickCmd("conv ...
- nginx网站攻击防护
1.上上个月架构全部迁移上云以后,总的来说比较稳定,业务量也上来,可爱的坏人也来了,7X24小时不停恶意攻击我的网站,第一次收到报警是网站流入流量1分钟以内连续3次超过1000000bps,换算下1M ...
- 法外之徒第一季/全集Braquo迅雷下载
英文译名 Braquo (第1-2季) (2012-01-05首播)法国.本季看点:<法外之徒>Eddy.Théo.Walter和Roxane私人本是巴黎上塞纳省地区的警察. 因为他们的好 ...
- 广告狂人第一至七季/全集Mad Men迅雷下载
广告狂人 第一季 Mad Men Season 1 (2007) 本季看点:你是谁?你想要什么?你爱乾什么?这些都不重要,重要的是你怎么把东西卖出去.凡是了解纽约的人都知道,今天,在麦迪逊大道(Mad ...