
【Python实战】Scrapy豌豆荚应用市场爬虫
对于给定的大量APP,如何爬取与之对应的(应用市场)分类、描述的信息?且看下面分解。
1. 页面分析
当我们在豌豆荚首页搜索框输入微信后,会跳转到搜索结果的页面,其url为http://www.wandoujia.com/search?key=%微信。搜索结果一般是按相关性排序的;所以,我们认为第一条搜索结果为所需要爬取的。紧接着,点进去后会跳转到页面http://www.wandoujia.com/apps/com.tencent.mm,我们会发现豌豆荚的APP的详情页,是www.wandoujia.com/apps/ + APP package组成。
让我们退回到搜索结果页面,分析页面元素,如图:

所有搜索结果在<ul>无序列表标签中,每一个搜索结果在<li>标签中。对应地,CSS选择器应为
'#j-search-list>li::attr(data-pn)'
接下来,我们来分析APP的详情页,APP的名称所对应的HTML元素如图:
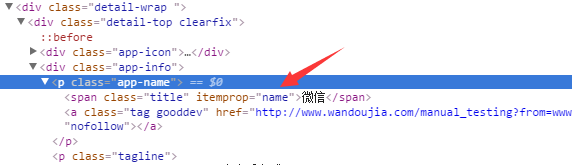
APP类别的如图:
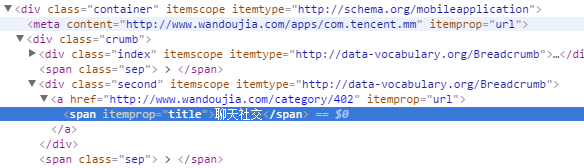
APP描述的如图:
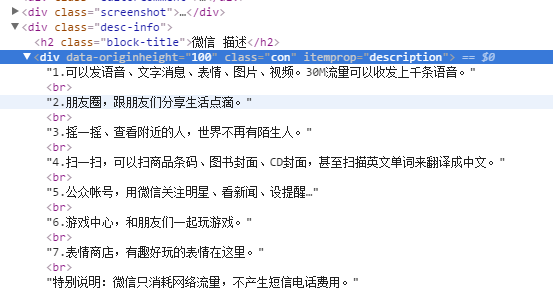
不难得到这三类元素所对应的CSS选择器
.app-name>span::text

.crumb>.second>a>span::text

.desc-info>.con::text
通过上面的分析,确定爬取策略如下:
- 逐行读取APP文件,拼接搜索页面URL;
- 分析搜索结果页面,跳转到第一条结果对应的详情页;
- 爬取详情页相关结果,写到输出文件
2. 爬虫实现
分析完页面,可以coding写爬虫了。但是,若裸写Python实现,则要处理下载间隔、请求、页面解析、爬取结果序列化。Scrapy提供一个轻量级、快速的web爬虫框架,并很好地解决了这些问题;中文doc有比较详尽的介绍。
数据清洗
APP文件中,可能有一些名称不规整,需要做清洗:
# -*- coding: utf-8 -*-

import re

def clean_app_name(app_name):

    space = u'\u00a0'

    app_name = app_name.replace(space, '')

    brackets = r'\(.*\)|\[.*\]|【.*】|(.*)'

    return re.sub(brackets, '', app_name)
URL处理
拿清洗后APP名称,拼接搜索结果页面URL。因为URL不识别中文等字符,需要用urllib.quote做URL编码:
# -*- coding: utf-8 -*-

from appMarket import clean

import urllib

def get_kw_url(kw):

    """concatenate the url for searching"""

    base_url = u"http://www.wandoujia.com/search?key=%s"

    kw = clean.clean_app_name(kw)

    return base_url % (urllib.quote(kw.encode("utf8")))

def get_pkg_url(pkg):

    """get the detail url according to pkg"""

    return 'http://www.wandoujia.com/apps/%s' % pkg
爬取
Scrapy的爬虫均继承与scrapy.Spider类,主要的属性及方法:
- name,爬虫的名称,
scrapy crawl命令后可直接跟爬虫的名称,即可启动该爬虫 - allowed_domains,允许爬取域名的列表
- start_requests(),开始爬取的方法,返回一个可迭代对象(iterable),一般为scrapy.Request对象
- parse(response),既可负责处理response并返回处理的数据,也可以跟进的URL(以做下一步处理)
items为保存爬取后数据的容器,类似于Python的dict,
import scrapy

class AppMarketItem(scrapy.Item):

    # define the fields for your item here like:

    kw = scrapy.Field()  # key word

    name = scrapy.Field()  # app name

    tag = scrapy.Field()  # app tag

    desc = scrapy.Field()  # app description
豌豆荚Spider代码:
# -*- coding: utf-8 -*-

# @Time    : 2016/6/23

# @Author  : rain

import scrapy

import codecs

from appMarket import util

from appMarket.util import wandoujia

from appMarket.items import AppMarketItem

class WandoujiaSpider(scrapy.Spider):

    name = "WandoujiaSpider"

    allowed_domains = ["www.wandoujia.com"]

    def __init__(self):

        self.apps_path = './input/apps.txt'

    def start_requests(self):

        with codecs.open(self.apps_path, 'r', 'utf-8') as f:

            for app_name in f:

                yield scrapy.Request(url=wandoujia.get_kw_url(app_name),

                                     callback=self.parse_search_result,

                                     meta={'kw': app_name.rstrip()})

    def parse(self, response):

        item = AppMarketItem()

        item['kw'] = response.meta['kw']

        item['name'] = response.css('.app-name>span::text').extract_first()

        item['tag'] = response.css('.crumb>.second>a>span::text').extract_first()

        desc = response.css('.desc-info>.con::text').extract()

        item['desc'] = util.parse_desc(desc)

        item['desc'] = u"" if not item["desc"] else item["desc"].strip()

        self.log(u'crawling the app %s' % item["name"])

        yield item

    def parse_search_result(self, response):

        pkg = response.css("#j-search-list>li::attr(data-pn)").extract_first()

        yield scrapy.Request(url=wandoujia.get_pkg_url(pkg), meta=response.meta)
APP文件里的应用名作为搜索词,也应被写在输出文件里。但是,在爬取时URL有跳转,如何在不同层级间的Request传递变量呢?Request中的meta (dict) 参数实现了这种传递。
APP描述.desc-info>.con::text,extract返回的是一个list,拼接成string如下:
def parse_desc(desc):

    return reduce(lambda a, b: a.strip()+b.strip(), desc, '')
结果处理
Scrapy推荐的序列化方式为Json。Json的好处显而易见:
- 跨语言;
- Schema明晰,较于'\t'分割的纯文本,读取不易出错
爬取结果有可能会有重复的、为空的(无搜索结果的);此外,Python2序列化Json时,对于中文字符,其编码为unicode。对于这些问题,可自定义Pipeline对结果进行处理:
class CheckPipeline(object):

    """check item, and drop the duplicate one"""

    def __init__(self):

        self.names_seen = set()

    def process_item(self, item, spider):

        if item['name']:

            if item['name'] in self.names_seen:

                raise DropItem("Duplicate item found: %s" % item)

            else:

                self.names_seen.add(item['name'])

                return item

        else:

            raise DropItem("Missing price in %s" % item)

class JsonWriterPipeline(object):

    def __init__(self):

        self.file = codecs.open('./output/output.json', 'wb', 'utf-8')

    def process_item(self, item, spider):

        line = json.dumps(dict(item), ensure_ascii=False) + "\n"

        self.file.write(line)

        return item
还需在settings.py中设置
ITEM_PIPELINES = {

    'appMarket.pipelines.CheckPipeline': 300,

    'appMarket.pipelines.JsonWriterPipeline': 800,

}
分配给每个类的整型值,确定了他们运行的顺序,按数字从低到高的顺序,通过pipeline,通常将这些数字定义在0-1000范围内。
【Python实战】Scrapy豌豆荚应用市场爬虫的更多相关文章
- python基于scrapy框架的反爬虫机制破解之User-Agent伪装
user agent是指用户代理,简称 UA. 作用:使服务器能够识别客户使用的操作系统及版本.CPU 类型.浏览器及版本.浏览器渲染引擎.浏览器语言.浏览器插件等. 网站常常通过判断 UA 来给不同 ...
- scrapy——7 scrapy-redis分布式爬虫,用药助手实战,Boss直聘实战,阿布云代理设置
scrapy——7 什么是scrapy-redis 怎么安装scrapy-redis scrapy-redis常用配置文件 scrapy-redis键名介绍 实战-利用scrapy-redis分布式爬 ...
- Python之Scrapy爬虫框架安装及简单使用
题记:早已听闻python爬虫框架的大名.近些天学习了下其中的Scrapy爬虫框架,将自己理解的跟大家分享.有表述不当之处,望大神们斧正. 一.初窥Scrapy Scrapy是一个为了爬取网站数据,提 ...
- dota玩家与英雄契合度的计算器,python语言scrapy爬虫的使用
首发:个人博客,更新&纠错&回复 演示地址在这里,代码在这里. 一个dota玩家与英雄契合度的计算器(查看效果),包括两部分代码: 1.python的scrapy爬虫,总体思路是pag ...
- Python实战:Python爬虫学习教程,获取电影排行榜
Python应用现在如火如荼,应用范围很广.因其效率高开发迅速的优势,快速进入编程语言排行榜前几名.本系列文章致力于可以全面系统的介绍Python语言开发知识和相关知识总结.希望大家能够快速入门并学习 ...
- 基于Python,scrapy,redis的分布式爬虫实现框架
原文 http://www.xgezhang.com/python_scrapy_redis_crawler.html 爬虫技术,无论是在学术领域,还是在工程领域,都扮演者非常重要的角色.相比于其他 ...
- python 全栈开发,Day137(爬虫系列之第4章-scrapy框架)
一.scrapy框架简介 1. 介绍 Scrapy一个开源和协作的框架,其最初是为了页面抓取 (更确切来说, 网络抓取 )所设计的,使用它可以以快速.简单.可扩展的方式从网站中提取所需的数据.但目前S ...
- 零基础入门Python实战:四周实现爬虫网站 Django项目视频教程
点击了解更多Python课程>>> 零基础入门Python实战:四周实现爬虫网站 Django项目视频教程 适用人群: 即将毕业的大学生,工资低工作重的白领,渴望崭露头角的职场新人, ...
- Python:Scrapy(二) 实例分析与总结、写一个爬虫的一般步骤
学习自:Scrapy爬虫框架教程(二)-- 爬取豆瓣电影TOP250 - 知乎 Python Scrapy 爬虫框架实例(一) - Blue·Sky - 博客园 1.声明Item 爬虫爬取的目标是从非 ...
随机推荐
- 判断是否为mac电脑 、还是windows操作系统
/** * 是否为mac系统(包含iphone手机) * */ var isMac = function() { return /macintosh|mac os x/i.test(navigator ...
- 今年第一季全球PC出貨量同比下降5.2%
市場調研公司Gartner上周發佈報告稱,隨著企業支出的下滑,今年第一季全球PC出貨量同比下降5.2%迪士尼美語評價.英特爾稱,第一季筆記本晶片出貨量同比增長3%,但是筆記本晶片的平均銷售價格下降了3 ...
- VS2013.3 & VS2014 任务资源管理器
Web 开发,特别是前端 Web 开发,正迅速变得像传统的后端开发一样复杂和精密.前端生成过程,可以囊括SASS 和LESS扩展.CSS/JS的压缩包.JSHint 或 JSLint的运行时 .或者更 ...
- 基于AngularJS的企业软件前端架构[转载]
这篇是我参加QCon北京2014的演讲内容: 提纲: 企业应用在软件行业中占有很大的比重,而这类软件多数现在也都采用B/S的模式开发,在这个日新月异的时代,它们的前端开发技术找到了什么改进点呢? B/ ...
- node基本理念(事件、多线程、进程)
关于node的几点理解: 1.所谓的node单线程,是指node的event loop,也就是我们的业务脚本是跑在一个单线程中的,可以理解为主线程: 2.若存在IO操作,例如文件.网络,是单独在线程里 ...
- [ASP.NET MVC 小牛之路]15 - Model Binding
Model Binding(模型绑定)是 MVC 框架根据 HTTP 请求数据创建 .NET 对象的一个过程.我们之前所有示例中传递给 Action 方法参数的对象都是在 Model Binding ...
- shell使用攻略
shell 是什么 ~ $ ls /bin/*sh /bin/bash /bin/csh /bin/ksh /bin/sh /bin/tcsh /bin/zsh 是什么 kernel shell 命令 ...
- xamarin 手机顶部状态栏
修改显示xamarin开发的App的手机顶部状态栏, 步骤一:在项目UWP上的“引用”里右键“添加引用”,选择->Universal Windows->Windows Mobile Ext ...
- struts1二:基本环境搭建
首先建立一个web项目 引入需要的jar包 建立包com.bjpowernode.struts创建LoginAction package com.bjpowernode.struts; import ...
- hibernate注解方法使用总结(转)
原博文地址:http://blog.sina.com.cn/s/blog_935ebb670101dnre.html 1.类级别注解 @Entity 映射实体类 @Table 映射数据库 ...