
Hadoop简述
Haddop是什么?
Hadoop是一个由Apache基金会所开发的分布式系统基础架构
主要解决,海量数据的存储和海量数据的分析计算问题。
Hadoop三大发行版本
Apache版本最原始(最基础)的版本,对于入门学习最好。
Cloudera在大型互联网企业中用的较多。
Hortonworks文档较好。
Hadoop的优势
1)高可靠性:因为Hadoop假设计算元素和存储会出现故障,因为它维护多个工作数据副本,在出现故障时可以对失败的节点重新分布处理。
2)高扩展性:在集群间分配任务数据,可方便的扩展数以千计的节点。
3) 高效性:在MapReduce的思想下,Hadoop是并行工作的,以加快任务处理速度。
4)高容错性:自动保存多份副本数据,并且能够自动将失败的任务重新分配。
Hadoop组成
1)Hadoop HDFS:一个高可靠、高吞吐量的分布式文件系统。
2)Hadoop MapReduce:一个分布式的离线并行计算框架。
3)Hadoop YARN:作业调度与集群资源管理的框架。
4)Hadoop Common:支持其他模块的工具模块。
HDFS架构概述
1)NameNode(nn):存储文件的元数据,如文件名,文件目录结构,文件属性(生成时间、副本数、文件权限),以及每个文件的块列表和块所在的DataNode等。
2)DataNode(dn):在本地文件系统存储文件块数据,以及块数据的校验和。
3)Secondary NameNode(2nn):用来监控HDFS状态的辅助后台程序,每隔一段时间获取HDFS元数据的快照。
YARN架构概述
1)ResourceManager(rm):处理客户端请求、启动/监控ApplicationMaster、监控NodeManager、资源分配与调度;
2)NodeManager(nm):单个节点上的资源管理、处理来自ResourceManager的命令、处理来自ApplicationMaster的命令;
3)ApplicationMaster:数据切分、为应用程序申请资源,并分配给内部任务、任务监控与容错。
4)Container:对任务运行环境的抽象,封装了CPU、内存等多维资源以及环境变量、启动命令等任务运行相关的信息。
MapReduce架构概述
MapReduce将计算过程分为两个阶段:Map和Reduce
1)Map阶段并行处理输入数据
2)Reduce阶段对Map结果进行汇总
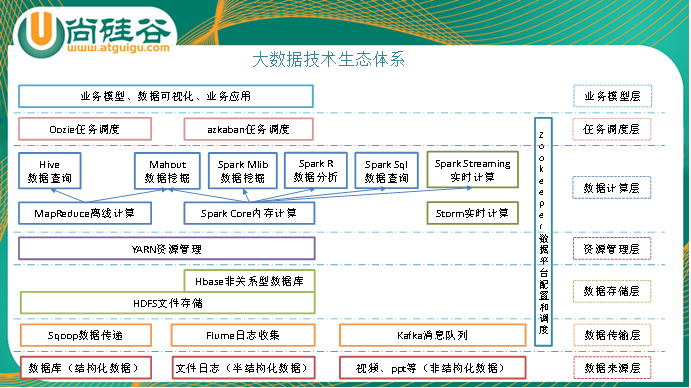
1)Sqoop:sqoop是一款开源的工具,主要用于在Hadoop(Hive)与传统的数据库(mysql)间进行数据的传递,可以将一个关系型数据库(例如 : MySQL ,Oracle 等)中的数据导进到Hadoop的HDFS中,也可以将HDFS的数据导进到关系型数据库中。
2)Flume:Flume是Cloudera提供的一个高可用的,高可靠的,分布式的海量日志采集、聚合和传输的系统,Flume支持在日志系统中定制各类数据发送方,用于收集数据;同时,Flume提供对数据进行简单处理,并写到各种数据接受方(可定制)的能力。
3)Kafka:Kafka是一种高吞吐量的分布式发布订阅消息系统,有如下特性:
(1)通过O(1)的磁盘数据结构提供消息的持久化,这种结构对于即使数以TB的消息存储也能够保持长时间的稳定性能。
(2)高吞吐量:即使是非常普通的硬件Kafka也可以支持每秒数百万的消息
(3)支持通过Kafka服务器和消费机集群来分区消息。
(4)支持Hadoop并行数据加载。
4)Storm:Storm为分布式实时计算提供了一组通用原语,可被用于“流处理”之中,实时处理消息并更新数据库。这是管理队列及工作者集群的另一种方式。 Storm也可被用于“连续计算”(continuous computation),对数据流做连续查询,在计算时就将结果以流的形式输出给用户。
5)Spark:Spark是当前最流行的开源大数据内存计算框架。可以基于Hadoop上存储的大数据进行计算。
6)Oozie:Oozie是一个管理Hdoop作业(job)的工作流程调度管理系统。Oozie协调作业就是通过时间(频率)和有效数据触发当前的Oozie工作流程。
7)Hbase:HBase是一个分布式的、面向列的开源数据库。HBase不同于一般的关系数据库,它是一个适合于非结构化数据存储的数据库。
8)Hive:hive是基于Hadoop的一个数据仓库工具,可以将结构化的数据文件映射为一张数据库表,并提供简单的sql查询功能,可以将sql语句转换为MapReduce任务进行运行。 其优点是学习成本低,可以通过类SQL语句快速实现简单的MapReduce统计,不必开发专门的MapReduce应用,十分适合数据仓库的统计分析。
10)R语言:R是用于统计分析、绘图的语言和操作环境。R是属于GNU系统的一个自由、免费、源代码开放的软件,它是一个用于统计计算和统计制图的优秀工具。
11)Mahout:
Apache Mahout是个可扩展的机器学习和数据挖掘库,当前Mahout支持主要的4个用例:
推荐挖掘:搜集用户动作并以此给用户推荐可能喜欢的事物。
聚集:收集文件并进行相关文件分组。
分类:从现有的分类文档中学习,寻找文档中的相似特征,并为无标签的文档进行正确的归类。
频繁项集挖掘:将一组项分组,并识别哪些个别项会经常一起出现。
12)ZooKeeper:Zookeeper是Google的Chubby一个开源的实现。它是一个针对大型分布式系统的可靠协调系统,提供的功能包括:配置维护、名字服务、 分布式同步、组服务等。ZooKeeper的目标就是封装好复杂易出错的关键服务,将简单易用的接口和性能高效、功能稳定的系统提供给用户。
Hadoop简述的更多相关文章
- Hadoop YARN学习之组件功能简述(3)
Hadoop YARN学习之组件功能简述(3) 1. YARN的三大组件功能简述: ResourceManager(RM)是集群的资源的仲裁者, 它有两部分:一个可插拔的调度器和一个Applicati ...
- Hadoop YARN学习之Hadoop框架演进历史简述
Hadoop YARN学习之Hadoop框架演进历史简述(1) 1. Hadoop在其发展的过程中经历了多个阶段: 阶段0:Ad Hoc集群时代 标志着Hadoop的起源,集群以Ad Hoc.单用户方 ...
- 简述hadoop安装步骤
简述hadoop安装步骤 安装步骤: 1.安装虚拟机系统,并进行准备工作(可安装- 一个然后克隆) 2.修改各个虚拟机的hostname和host 3.创建用户组和用户 4.配置虚拟机网络,使虚拟机系 ...
- [hadoop]mapreduce原理简述
1.用于map的输入,先将输入数据切分成相等的分片,为每一个分片创建一个map worker,这里的切片大小不是随意订的,一般是与HDFS块大小一致,默认是64MB,一个节点上存储输入数据切片的最大s ...
- hadoop 2.0安装及HA配置简述
一.单机模式 a.配置本机到本机的免密登录 b.解压hadoop压缩包,修改hadoop.env.sh中的JAVA_HOME c.修改core-site.xml <configuration&g ...
- Hadoop YARN 的工作流程简述
1.Client 向 YARN 提交应用程序,其中包括 ApplicationMaster 程序及启动 ApplicationMaster 命令2.ResourceManager 为该 Applica ...
- hadoop+tachyon+spark的zybo cluster集群综合配置
1.zybo cluster 架构简述: 1.1 zybo cluster 包含5块zybo 开发板组成一个集群,zybo的boot文件为digilent zybo reference design提 ...
- HADOOP安装指南-Ubuntu15.10和hadoop2.7.2
Ubuntu15.10中安装hadoop2.7.2安装手册 太初 目录 1. Hadoop单点模式... 2 1.1 安装步骤... 2 0.环境和版本... 2 1.在ubu ...
- Hadoop 之 MapReduce 框架演变详解
经典版的MapReduce 所谓的经典版本的MapReduce框架,也是Hadoop第一版成熟的商用框架,简单易用是它的特点,来看一幅图架构图: 上面的这幅图我们暂且可以称谓Hadoop的V1.0版本 ...
随机推荐
- OTA升级详解(一)
不积跬步,无以至千里: 不积小流,无以成江海. 出自荀子<劝学篇> 1.概念解释 OTA是何物? 英文解释为 Over The Air,既空中下载的意思,具体指远程无线方式,OTA 技术可 ...
- python之ORM(对象关系映射)
实现了数据模型与数据库的解耦,通过简单的配置就可以轻松更换数据库,而不需要更改代码.orm操作本质上会根据对接的数据库引擎,翻译成对应的sql语句.所有使用Django开发的项目无需关心程序底层使用的 ...
- SCOI2005 繁忙的都市 [Luogu P2330]
题目描述 城市C是一个非常繁忙的大都市,城市中的道路十分的拥挤,于是市长决定对其中的道路进行改造.城市C的道路是这样分布的:城市中有n个交叉路口,有些交叉路口之间有道路相连,两个交叉路口之间最多有一条 ...
- 基于node的前端项目代码包发布至nexus
目录 目录... 3 1. 前言... 1 2. 配置... 1 2.1. 配置angular.json文件... 1 2.2. 配置package.json文件... 1 2.3. 复制git地址. ...
- fastjson自由:controller上指定active profile,让你想序列化什么字段就序列化什么字段
一.前言 最近有个需求,其实这个需求以前就有,比如定义了一个vo,包含了10个字段, 在接口A里,要返回全部字段: 但是在接口B里呢,需要复用这个 vo, 但是只需要返回其中8个字段. 可能呢,有些同 ...
- windows下离线安装mysql8.0服务(支持多个安装,端口不同就可以)
1.官网下载 mysql文件.官网下载链接:https://dev.mysql.com/downloads/mysql/ 选择mysql下载的系统版本. 此处可以下载MSI安装包,图简单的朋友可以 ...
- map和set的使用及top K问题
1.map和set的应用和比较 map和set都是关联式容器,底层容器都是红黑树. map以键值对的形式进行存储,方便进行查找,关键词起到索引的作用,值则表示与索引相关联的数据,以红黑树的结构实现,插 ...
- Xshell6配置ssh免密码登录虚拟机
首先先说明一下有密码的,涉及到root登陆权限的问题: 1.用超级管理员身份登录,修改 vi /etc/ssh/sshd_config, 找到 把其中的permitRootLogin 修改成: # ...
- SpringBoot之ActiveMQ实现延迟消息
一.安装activeMQ 安装步骤参照网上教程,本文不做介绍 二.修改activeMQ配置文件 broker新增配置信息 schedulerSupport="true" & ...
- Python Socket学习之旅(二)
Socket函数 注解: Socket的close和shutdown--结束数据传输: close-----关闭本进程的socket id,但链接还是开着的,用这个socket id的其它进程还能用这 ...