
tensorflow实现基于LSTM的文本分类方法
tensorflow实现基于LSTM的文本分类方法
作者:u010223750
引言
学习一段时间的tensor flow之后,想找个项目试试手,然后想起了之前在看Theano教程中的一个文本分类的实例,这个星期就用tensorflow实现了一下,感觉和之前使用的theano还是有很大的区别,有必要总结mark一下
模型说明
这个分类的模型其实也是很简单,主要就是一个单层的LSTM模型,当然也可以实现多层的模型,多层的模型使用Tensorflow尤其简单,下面是这个模型的图 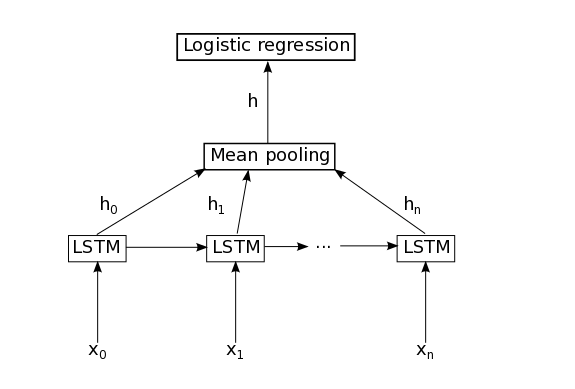
简单解释一下这个图,每个word经过embedding之后,进入LSTM层,这里LSTM是标准的LSTM,然后经过一个时间序列得到的t个隐藏LSTM神经单元的向量,这些向量经过mean pooling层之后,可以得到一个向量h,然后紧接着是一个简单的逻辑斯蒂回归层(或者一个softmax层)得到一个类别分布向量。
公式就不一一介绍了,因为这个实验是使用了Tensorflow重现了Theano的实现,因此具体的公式可以参看LSTM Networks for Sentiment Analysis这个链接。
tensorflow实现
鄙人接触tensor flow的时间不长,也是在慢慢摸索,但是因为有之前使用Theano的经验,对于符号化编程也不算陌生,因此上手Tensorflow倒也容易。但是感觉tensorflow还是和theano有着很多不一样的地方,这里也会提及一下。
代码的模型的主要如下:
import tensorflow as tf

import numpy as np

class RNN_Model(object):

    def __init__(self,config,is_training=True):

        self.keep_prob=config.keep_prob

        self.batch_size=tf.Variable(0,dtype=tf.int32,trainable=False)

        num_step=config.num_step

        self.input_data=tf.placeholder(tf.int32,[None,num_step])

        self.target = tf.placeholder(tf.int64,[None])

        self.mask_x = tf.placeholder(tf.float32,[num_step,None])

        class_num=config.class_num

        hidden_neural_size=config.hidden_neural_size

        vocabulary_size=config.vocabulary_size

        embed_dim=config.embed_dim

        hidden_layer_num=config.hidden_layer_num

        self.new_batch_size = tf.placeholder(tf.int32,shape=[],name="new_batch_size")

        self._batch_size_update = tf.assign(self.batch_size,self.new_batch_size)

        #build LSTM network

        lstm_cell = tf.nn.rnn_cell.BasicLSTMCell(hidden_neural_size,forget_bias=0.0,state_is_tuple=True)

        if self.keep_prob<1:

            lstm_cell =  tf.nn.rnn_cell.DropoutWrapper(

                lstm_cell,output_keep_prob=self.keep_prob

            )

        cell = tf.nn.rnn_cell.MultiRNNCell([lstm_cell]*hidden_layer_num,state_is_tuple=True)

        self._initial_state = cell.zero_state(self.batch_size,dtype=tf.float32)

        #embedding layer

        with tf.device("/cpu:0"),tf.name_scope("embedding_layer"):

            embedding = tf.get_variable("embedding",[vocabulary_size,embed_dim],dtype=tf.float32)

            inputs=tf.nn.embedding_lookup(embedding,self.input_data)

        if self.keep_prob<1:

            inputs = tf.nn.dropout(inputs,self.keep_prob)

        out_put=[]

        state=self._initial_state

        with tf.variable_scope("LSTM_layer"):

            for time_step in range(num_step):

                if time_step>0: tf.get_variable_scope().reuse_variables()

                (cell_output,state)=cell(inputs[:,time_step,:],state)

                out_put.append(cell_output)

        out_put=out_put*self.mask_x[:,:,None]

        with tf.name_scope("mean_pooling_layer"):

            out_put=tf.reduce_sum(out_put,0)/(tf.reduce_sum(self.mask_x,0)[:,None])

        with tf.name_scope("Softmax_layer_and_output"):

            softmax_w = tf.get_variable("softmax_w",[hidden_neural_size,class_num],dtype=tf.float32)

            softmax_b = tf.get_variable("softmax_b",[class_num],dtype=tf.float32)

            self.logits = tf.matmul(out_put,softmax_w)+softmax_b

        with tf.name_scope("loss"):

            self.loss = tf.nn.sparse_softmax_cross_entropy_with_logits(self.logits+1e-10,self.target)

            self.cost = tf.reduce_mean(self.loss)

        with tf.name_scope("accuracy"):

            self.prediction = tf.argmax(self.logits,1)

            correct_prediction = tf.equal(self.prediction,self.target)

            self.correct_num=tf.reduce_sum(tf.cast(correct_prediction,tf.float32))

            self.accuracy = tf.reduce_mean(tf.cast(correct_prediction,tf.float32),name="accuracy")

        #add summary

        loss_summary = tf.scalar_summary("loss",self.cost)

        #add summary

        accuracy_summary=tf.scalar_summary("accuracy_summary",self.accuracy)

        if not is_training:

            return

        self.globle_step = tf.Variable(0,name="globle_step",trainable=False)

        self.lr = tf.Variable(0.0,trainable=False)

        tvars = tf.trainable_variables()

        grads, _ = tf.clip_by_global_norm(tf.gradients(self.cost, tvars),

                                      config.max_grad_norm)

        # Keep track of gradient values and sparsity (optional)

        grad_summaries = []

        for g, v in zip(grads, tvars):

            if g is not None:

                grad_hist_summary = tf.histogram_summary("{}/grad/hist".format(v.name), g)

                sparsity_summary = tf.scalar_summary("{}/grad/sparsity".format(v.name), tf.nn.zero_fraction(g))

                grad_summaries.append(grad_hist_summary)

                grad_summaries.append(sparsity_summary)

        self.grad_summaries_merged = tf.merge_summary(grad_summaries)

        self.summary =tf.merge_summary([loss_summary,accuracy_summary,self.grad_summaries_merged])

        optimizer = tf.train.GradientDescentOptimizer(self.lr)

        optimizer.apply_gradients(zip(grads, tvars))

        self.train_op=optimizer.apply_gradients(zip(grads, tvars))

        self.new_lr = tf.placeholder(tf.float32,shape=[],name="new_learning_rate")

        self._lr_update = tf.assign(self.lr,self.new_lr)

    def assign_new_lr(self,session,lr_value):

        session.run(self._lr_update,feed_dict={self.new_lr:lr_value})

    def assign_new_batch_size(self,session,batch_size_value):

        session.run(self._batch_size_update,feed_dict={self.new_batch_size:batch_size_value})
模型不复杂,也就不一一解释了,在debug的时候,还是入了几个tensorflow的坑,因此想单独说一下这几个坑。
坑1:tensor flow的LSTM实现
tensorflow是已经写好了几个LSTM的实现类,可以很方便的使用,而且也可以选择多种类型的LSTM,包括Basic、Bi-Directional等等。
这个代码用的是BasicLSTM:
 #build LSTM network

        lstm_cell = tf.nn.rnn_cell.BasicLSTMCell(hidden_neural_size,forget_bias=0.0,state_is_tuple=True)

        if self.keep_prob<1:

            lstm_cell =  tf.nn.rnn_cell.DropoutWrapper(

                lstm_cell,output_keep_prob=self.keep_prob

            )

        cell = tf.nn.rnn_cell.MultiRNNCell([lstm_cell]*hidden_layer_num,state_is_tuple=True)

        self._initial_state = cell.zero_state(self.batch_size,dtype=tf.float32)

        out_put=[]

        state=self._initial_state

        with tf.variable_scope("LSTM_layer"):

            for time_step in range(num_step):

                if time_step>0: tf.get_variable_scope().reuse_variables()

                (cell_output,state)=cell(inputs[:,time_step,:],state)

                out_put.append(cell_output)
在这段代码里面,tf.nn.rnn_cell.BasicLSTMCell的初始化只需要制定LSTM神经元的隐含神经元的个数即可,然后需要初始化LSTM网络的参数:self._initial_state = cell.zero_state(self.batch_size,dtype=tf.float32),这句代码乍看一下很迷糊,开始并不知道是什么意义,在实验以及查阅源码之后,返现这句话返回的是两个维度是batch_size*hidden_neural_size的零向量元组,其实就是LSTM初始化的c0、h0向量,当然这里指的是对于单层的LSTM,对于多层的,返回的是多个元组。
坑2:这段代码中的zero_state和循环代数num_step都需要制定
这里比较蛋疼,这就意味着tensorflow中实现变长的情况是要padding的,而且需要全部一样的长度,但是因为数据集的原因,不可能每个batch的size都是一样的,这里就需要每次运行前,动态制定batch_size的大小,代码中体现这个的是assign_new_batch_size函数,但是对于num_step参数却不能动态指定(可能是因为笔者没找到,但是指定tf.Variable()方法确实不行),出于无奈只能将数据集全部padding成指定大小的size,当然既然使用了padding那就必须使用mask矩阵进行计算。
坑3:cost返回non
cost返回Non一般是因为在使用交叉熵时候,logits这一边出现了0值,因此stack overflow上推荐的一般是:sparse_softmax_cross_entropy_with_logits(self.logits+1e-10,self.target)这样写法
训练and结果
实验背景:
tensor flow: tensor flow 0.11
platform:mac OS
数据集:subject dataset,数据集都经过了预处理,拿到的是其在词表中的索引
得益于tensorboard各个参数训练过程都可以可视化,下面是实验训练结果:
训练集训练结果: 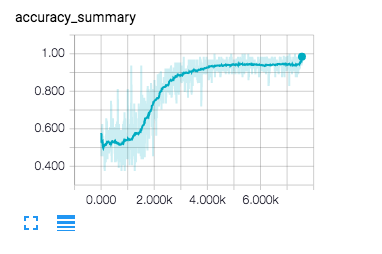
验证集训练结果 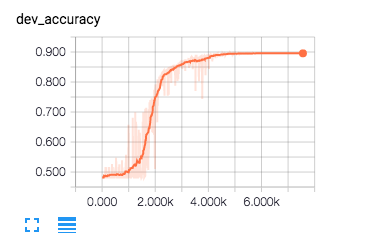
损失函数训练过程 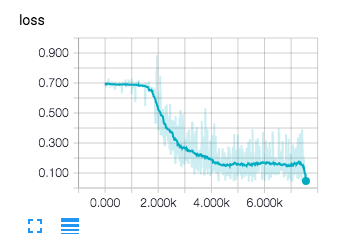
各个参数训练结果:
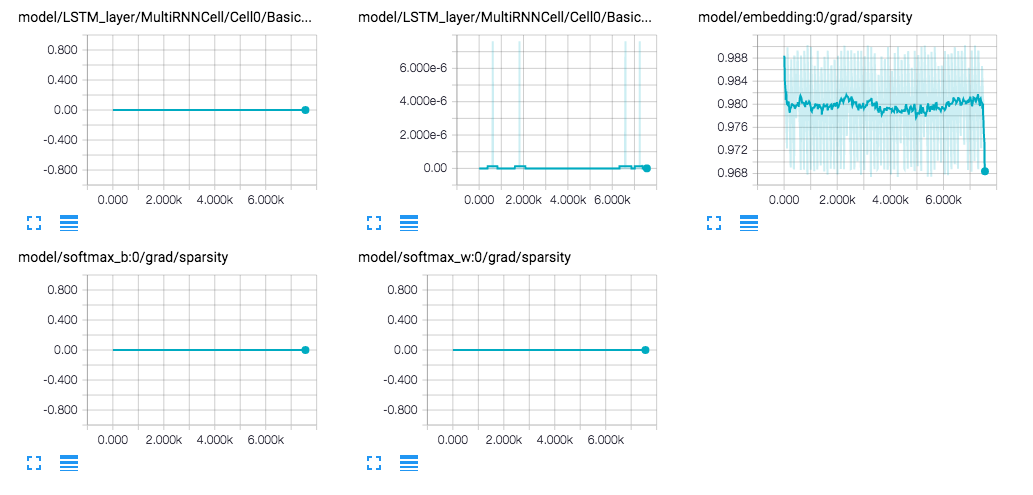
最终在测试集上,准确度约为85%,还不错。
比较tensorflow和thenao
tensor flow 和 theano 是最近比较流行的深度学习框架,两者非常相似但是两者又不一样,下面就我个人体验比较下两者的异同。
难易程度
就使用难度而言,tensorflow的便易性要远胜于theano,毕竟theano是一堆学者研究出来的,而tensorflow是Google研究出来的,比较面向工业化。tensor flow直接集成了学术界的很多方法,比如像RNN、LSTM等都已经被tensorflow集成了,还有比如参数更新方法如梯度下降、Adadelta等也已经被tensorflow写好了,但是对于theano这个就得自己写,当然难易程度不一样了。
灵活性
就灵活性而言,theano是要胜过tensor flow的,正是因为上一点theano的门槛稍高,却也使得theano有着更大的弹性,可以实现自己任意定义的网络结果,这里不是说tensorflow不行,tensorflow也能写,但是使用tensorflow久了之后,写一些自定义的结构能力就会生疏许多,比如修改LSTM内的一些结构。而Theano则没有这个约束。
- 容错性
我个人觉得theano的容错性是比tensor flow要高的,theano定义变量,只需要制定类型,比如imatrix、ivertor之类的而不用制定任何的维度,只要你输入的数据和你的网络结构图能够对的上的话,就没问题,而tensorflow择需要预先指定一些参数(如上面代码的num_step参数),相比而言,theano的容错能力多得多,当然这样也有坏处,那就是可能对导致代码调试起来比较费劲儿。
代码
本文的代码可以在这里获得,转载请注明出处。
tensorflow实现基于LSTM的文本分类方法的更多相关文章
- 一文详解如何用 TensorFlow 实现基于 LSTM 的文本分类(附源码)
雷锋网按:本文作者陆池,原文载于作者个人博客,雷锋网已获授权. 引言 学习一段时间的tensor flow之后,想找个项目试试手,然后想起了之前在看Theano教程中的一个文本分类的实例,这个星期就用 ...
- 在TensorFlow中基于lstm构建分词系统笔记
在TensorFlow中基于lstm构建分词系统笔记(一) https://www.jianshu.com/p/ccb805b9f014 前言 我打算基于lstm构建一个分词系统,通过这个例子来学习下 ...
- 基于weka的文本分类实现
weka介绍 参见 1)百度百科:http://baike.baidu.com/link?url=V9GKiFxiAoFkaUvPULJ7gK_xoEDnSfUNR1woed0YTmo20Wjo0wY ...
- 基于SVMLight的文本分类
支持向量机(Support Vector Machine)是Cortes和Vapnik于1995年首先提出的,它在解决小样本 .非线性及高维模式识别 中表现出许多特有的优势,并能够推广应用到函数拟合等 ...
- AI - TensorFlow - 示例02:影评文本分类
影评文本分类 文本分类(Text classification):https://www.tensorflow.org/tutorials/keras/basic_text_classificatio ...
- Python 基于 NLP 的文本分类
这是前一段时间在做的事情,有些python库需要python3.5以上,所以mac请先升级 brew安装以下就好,然后Preference(comm+',')->Project: Text-Cl ...
- NLP文本分类方法汇总
模型: FastText TextCNN TextRNN RCNN 分层注意网络(Hierarchical Attention Network) 具有注意的seq2seq模型(seq2seq with ...
- Tensorflow之基于LSTM神经网络写唐诗
最近看了不少关于写诗的博客,在前人的基础上做了一些小的改动,因比较喜欢一次输入很长的开头句,所以让机器人输出压缩为一个开头字生成两个诗句,写五言和七言诗,当然如果你想写更长的诗句是可以继续改动的. 在 ...
- NLP第9章 NLP 中用到的机器学习算法——基于统计学(文本分类和文本聚类)
随机推荐
- sql 查询所有子节点示例
每天学习一点点 编程PDF电子书.视频教程免费下载:http://www.shitanlife.com/code <!-- 查询机构的所有子机构 --> <select id=&qu ...
- js 常用的比较排序算法总结
每天学习一点点 编程PDF电子书.视频教程免费下载:http://www.shitanlife.com/code 一直很惧怕算法,总是感觉特别伤脑子,因此至今为止,几种基本的排序算法一直都不是很清楚, ...
- 【转】js中通过docment.cookie获取到的内容不完整! 在浏览器的application里的cookie里可以看到完整的cookie,个别字段无法通过document.cookie获取。 是否有其他办法可以获取到??
js中通过docment.cookie获取到的内容不完整!在浏览器的application里的cookie里可以看到完整的cookie,个别字段无法通过document.cookie获取.是否有其他办 ...
- Linux:Day9(下) 程序包管理
API:Application Programming Interface POSIX:Portable OS 程序源代码 --> 预处理 --> 编译 --> 汇编 --> ...
- 5、原生jdbc链接数据库实例-自动取款机
ATM自动取款机需求 一.登陆 1.界面要求:服务选择 1.老用户登陆:进入后输入卡号密码登陆 2.新用户开户:开户需要输入身份证号,记录姓名,开户时间.然后机器给出卡号,原始密码:111111. 卡 ...
- 吴恩达课后作业学习1-week4-homework-two-hidden-layer -1
参考:https://blog.csdn.net/u013733326/article/details/79767169 希望大家直接到上面的网址去查看代码,下面是本人的笔记 两层神经网络,和吴恩达课 ...
- hadoop学习笔记叁--简单应用
1.通过命令向HDFS传输文件 上传:./hadoop fs -put hdfs.cmd (本地文件名) hdfs://主机名称:9000/ hadoop fs -copyFromLoca ...
- luogu p1652 圆
题目部分 题目描述 给出N个圆,保证任意两个圆都相离,然后给出两个点(x1,y1).(x2,y2),保证均不在某个圆上,要从点(x1,y1)到(x2,y2)画条曲线,问这条曲线最少穿过多少次圆的边界? ...
- WPF在Canvas中绘图实现折线统计图
最近在WPF中做一个需要实现统计的功能,其中需要用到统计图,之前也没有接触过,度娘上大多都是各种收费或者免费的第三方控件,不想用第三方控件那就自己画一个吧. 在园子还找到一篇文章,思路来自这篇文章,文 ...
- JAVABEAN递归转MAP实现
之前想找这么一个方法,找到的都不是递归实现的,列表.MAP里面的都没转,就自己折腾了个.——YOYO public class ObjectToMap{ public static Map objec ...