
com.panie 项目开发随笔_爬虫初识(2017.2.7)
(一)
本章打算研究一下爬虫。我想用爬虫简单的爬取几篇文章,以及收集一下常用网站的信息。
(二)
以开源项目 JAVA爬虫 WebCollector 为源码研究。在此基础上改为适合自己项目的代码。
(三)
WebCollector致力于维护一个稳定、可扩的爬虫内核,便于开发者进行灵活的二次开发。内核具有很强的扩展性,用户可以在内核基础上开发自己想要的爬虫。源码中集成了Jsoup,可进行精准的网页解析。
内核构架图:
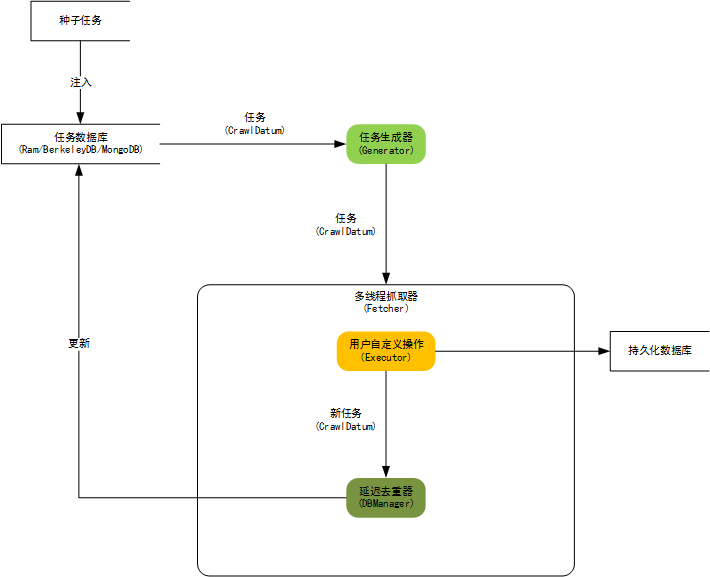
WebCollector的正文抽取API都被封装为ContentExtractor类的静态方法。 可以抽取结构化新闻,也可以只抽取网页的正文(或正文所在Element)。
标题抽取和日期抽取使用简单启发式算法,并没有像正文抽取算法一样在标准数据集上测试,算法仍在更新中。
WebCollector 2.x版本特性:
- 1)自定义遍历策略,可完成更为复杂的遍历业务,例如分页、AJAX
- 2)可以为每个URL设置附加信息(MetaData),利用附加信息可以完成很多复杂业务,例如深度获取、锚文本获取、引用页面获取、POST参数传递、增量更新等。
- 3)使用插件机制,WebCollector内置两套插件。
- 4)内置一套基于内存的插件(RamCrawler),不依赖文件系统或数据库,适合一次性爬取,例如实时爬取搜索引擎。
- 5)内置一套基于Berkeley DB(BreadthCrawler)的插件:适合处理长期和大量级的任务,并具有断点爬取功能,不会因为宕机、关闭导致数据丢失。
- 6)集成selenium,可以对javascript生成信息进行抽取
- 7)可轻松自定义http请求,并内置多代理随机切换功能。 可通过定义http请求实现模拟登录。
- 8)使用slf4j作为日志门面,可对接多种日志
(四)
该源码的使用方法仅需按照其示例 TutorialCrawler 写即可。比如,类似如下自定义方法:
package com.panie.modules.crawl.webcollector.example;

import org.jsoup.nodes.Document;

import com.panie.modules.crawl.webcollector.model.CrawlDatums;

import com.panie.modules.crawl.webcollector.model.Page;

import com.panie.modules.crawl.webcollector.plugin.berkeley.BreadthCrawler;

public class NewsCrawler extends BreadthCrawler

{

    public NewsCrawler(String crawlPath, boolean autoParse)

    {

        super(crawlPath, autoParse);

        /*start page*/

        this.addSeed("http://news.hfut.edu.cn/list-1-1.html");

        /*fetch url like http://news.hfut.edu.cn/show-xxxxxxhtml*/

        this.addRegex("http://news.hfut.edu.cn/show-.*html");

        /*do not fetch jpg|png|gif*/

        this.addRegex("-.*\\.(jpg|png|gif).*");

        /*do not fetch url contains #*/

        this.addRegex("-.*#.*");

    }

    @Override

    public void visit(Page page, CrawlDatums next)

    {

        String url = page.getUrl();

        /*if page is news page*/

        if (page.matchUrl("http://news.hfut.edu.cn/show-.*html")) {

            /*we use jsoup to parse page*/

            Document doc = page.getDoc();

            /*extract title and content of news by css selector*/

            String title = page.select("div[id=Article]>h2").first().text();

            String content = page.select("div#artibody", 0).text();

            System.out.println("URL:\n" + url);

            System.out.println("title:\n" + title);

            System.out.println("content:\n" + content);

            /*If you want to add urls to crawl,add them to nextLink*/

            /*WebCollector automatically filters links that have been fetched before*/

            /*If autoParse is true and the link you add to nextLinks does not match the regex rules,the link will also been filtered.*/

            //next.add("http://xxxxxx.com");

        }

    }

    public static void main(String[] args) throws Exception

    {

        NewsCrawler crawler = new NewsCrawler("crawl", true);

        //crawler.addSeed("http://news.hfut.edu.cn/.*");

        crawler.setThreads(50);

        crawler.setTopN(100);

        //crawler.setResumable(true);

        /*start crawl with depth of 4*/

        crawler.start(4);

    }

}
根据实际需要将 visit 方法 自定义相关内容
com.panie 项目开发随笔_爬虫初识(2017.2.7)的更多相关文章
- com.panie 项目开发随笔_数据字典(2017.2.24)
(一) 做一个网站,第一步需要考虑的是从哪个地方开始下手.首先,每一个功能肯定有最基本的增删改查功能,而此功能一般都分为两个页面. 1) 列表显示页面.用列表来展示数据库中的数据,多用于分页显示.该页 ...
- com.panie 项目开发随笔_功能任务设计(2016.12.28)
(一) 第一个菜单 做什么好呢? 1)上次 在研究的功能 是 爬虫,需要将定时爬虫的任务加进来 2)博客的页面,也需要重新布局出来 3)需要做一个,添加博客的页面 (二) 那就先做博客管理吧! 先添加 ...
- com.panie 项目开发随笔_前后端框架考虑(2016.12.8)
(一) 近日和一同学联系,说了我想要做一个网站的打算.她很感兴趣.于是我们协商了下,便觉得一起合作.她写前端,我写后台.因为我对于前端样式设计并不怎么熟悉. (二) 我们决定先做一个 个人博客. 网上 ...
- com.panie 项目开发随笔(NoF)_环境搭建(2016.12.29)
(一) 最近做的框架一直在 spring + springmvc + mybatis 的基础上,使用框架的好处自然是 简化了自己的开发工作,定义好大的结构体系后就在里面套用方法了! 可是框架的毛病同样 ...
- react_app 项目开发 (5)_前后端分离_后台管理系统_开始
项目描述 技术选型 react API 接口 接口文档,url,请求方式,参数类型, 根据文档描述的方法,进行 postman 测试,看是否能够得到理想的结果 collections - 创建文件取项 ...
- kotlin项目开发基础之gradle初识
在Android Studio推出之后默认的打包编译工具就变为gradle了,我想对于一名Android程序员而言没人不对它知晓,但是对于它里面的一些概念可能并不是每个人都了解,只知道这样配置就ok了 ...
- react_app 项目开发 (3)_单页面设计_react-router4
(web) 利用 react-router4 实现 单页面 开发 SPA 应用 ---- (Single Page Web Application) 整个应用只有 一个完整的页面 单击链接不会刷新页面 ...
- react_app 项目开发 (4)_ React UI 组件库 ant-design 的基本使用
最流行的开源 React UI 组件库 material-ui 国外流行(安卓手机的界面效果)文档 ant-design 国内流行 (蚂蚁金服 设计,一套 PC.一套移动端的____下拉菜单.分页.. ...
- react_app 项目开发 (6)_后台服务器端-node
后台服务器端 负责处理前台应用提交的请求,并向前台返回 json 数据 前台应用 负责 展现数据与用户交互 发 ajax 请求与后台应用交互 yarn add axios /src/api/ajax. ...
随机推荐
- 国内Docker下载镜像提速方法之一
众所周知,Docker Hub并没有在国内部署服务器或者使用国内的CDN服务,因此在国内特殊的网络环境下,镜像下载十分耗时.为了克服跨洋网络延迟,能够快速高效地下载Docker镜像,我采用了DaoCl ...
- django模型查询
概述 查询集表示从数据库获取的对象的集合 查询集可以有多个过滤器 过滤器就是一个函数,基于所给的参数限制查询集结果 从SQL角度来说,查询集和select语句等价,过滤器就像where条件 查询集 在 ...
- [转载]为何 Emacs 和 Vim 被称为两大神器
Emacs 是神的编辑器,而 Vim 是编辑器之神.二者为何会有如此美誉,且听本文向你一一道来. 目 录 0. 序章:神器的传说 1. 无敌的可扩展性 1.1 可扩展性给了软件强大的生命 1.2 Em ...
- jvm面试题
1.虚拟机的类加载机制 1.1.什么是虚拟机的类加载机制 在代码编译后,就会生成JVM(Java虚拟机)能够识别的二进制字节流文件(*.class).而JVM把Class文件中的类描述数据从文件加载 ...
- git的版本回退探索
简介 今天改完代码匆忙提交,上线发现有问题,那怎么办?废话,赶紧回滚,那怎么回滚,开始用git reset [--soft | --mixed | --hard 命令,但这命令真的能达到我预期的效果吗 ...
- RedHat 6 yum 使用网易源
. . . . . 刚装好了 RedHat 6 系统,但是使用 yum 的时候总是提示 nothing to do,并且什么都做不了.后来经过一番搜索才知道,红帽的 yum 在线更新是收费的,而且必须 ...
- Spring WebSocket初探1 (Spring WebSocket入门教程)<转>
See more: Spring WebSocket reference整个例子属于WiseMenuFrameWork的一部分,可以将整个项目Clone下来,如果朋友们有需求,我可以整理一个独立的de ...
- Android——简易计算器(转)
这是我的第一个andriod小程序,第一次写用了半个月,第二次修改用了一天,第三次修改用了两个小时,现在终于比较满意了.现在我就直接分享一下我的源代码,由于思路比较简单,注释加的不多.采用的是相对布局 ...
- 各种开源协议介绍 BSD、Apache Licence、GPL V2 、GPL V3 、LGPL、MIT_转
转自:各种开源协议介绍 BSD.Apache Licence.GPL V2 .GPL V3 .LGPL.MIT 现今存在的开源协议很多,而经过Open Source Initiative组织通过批准的 ...
- Sahi (1) —— 快速入门(101 Tutorial)
Sahi (1) -- 快速入门(101 Tutorial) jvm版本: 1.8.0_65 sahi版本: Sahi Pro 6.1.0 参考来源: Sahi官网 Sahi Quick Tutori ...