
学习进度05(billbill长评爬取02)
今天下雪了,是个看《白色相簿2》的好日子。
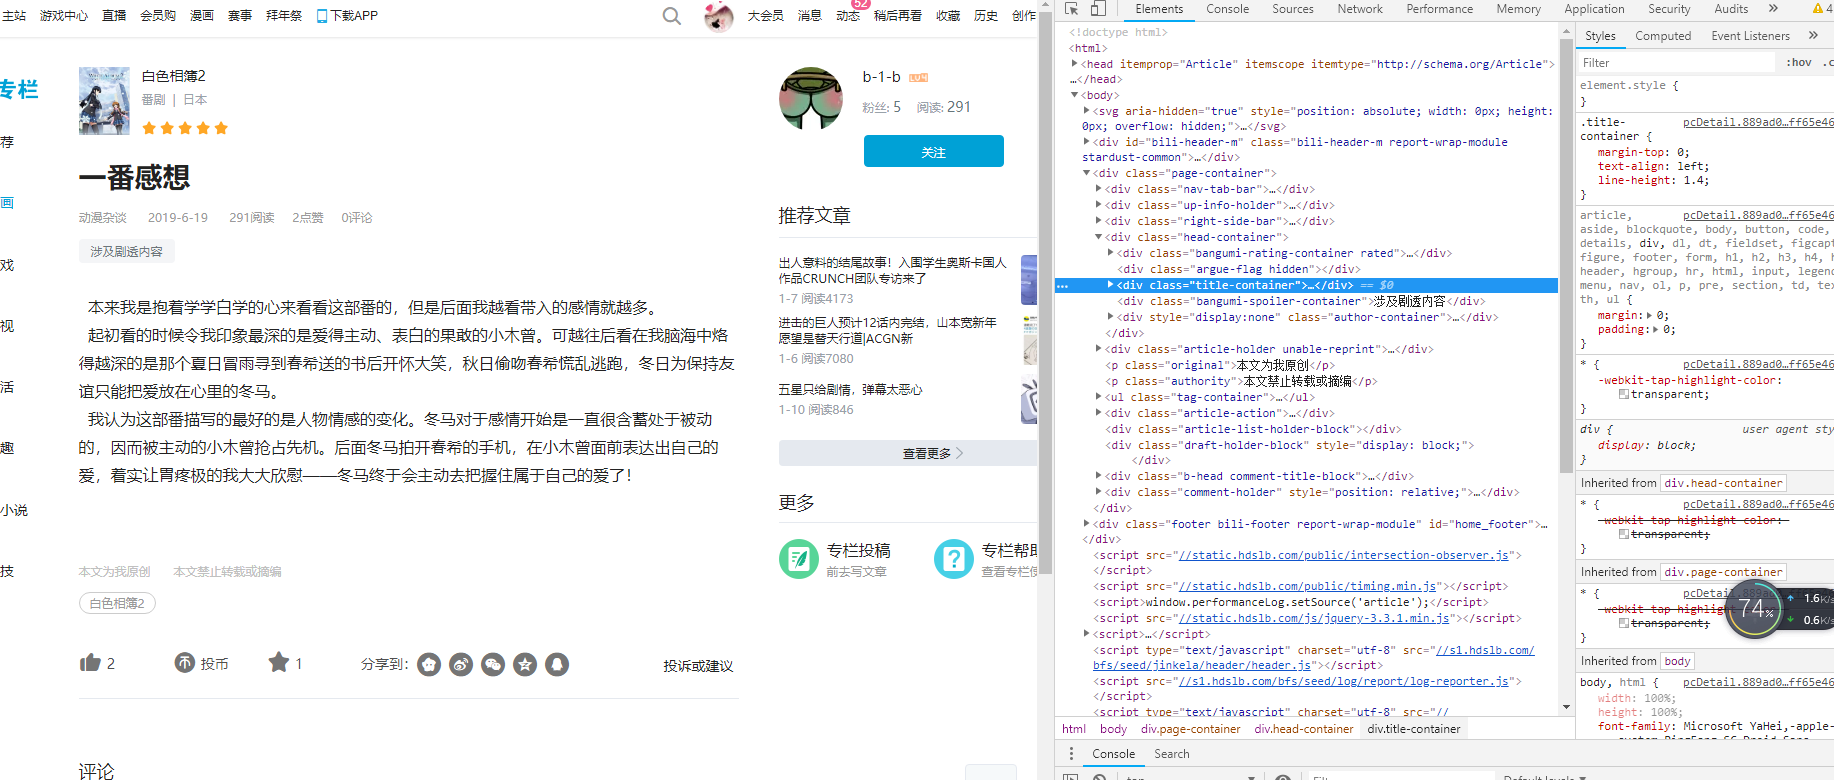
昨天我们获取所有长评url,今天要解析这些url获取更多的信息随便,点开一个,我们需要的数据有标题,时间,内容。点赞数和评论先不弄了。
解析json的时候用的正则表达式,这次就用xpath吧。
代码:
from lxml import html

import requests

import csv

# 请求头  可自己查看自己的 来更改

headers = {

    'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/70.0.3538.25 '

                  'Safari/537.36 Core/1.70.3741.400 QQBrowser/10.5.3863.400',

    'Referer': 'https://www.bilibili.com/bangumi/media/md3516/?spm_id_from=666.25.b_7265766965775f6d6f64756c65.1'

}

# csv文件的头

a = [

    'article', 'avatar', 'uname', 'str_url', 'title', 'content'

]

lists = []

lists_w = []

etree = html.etree

with open('a.csv', 'r', encoding='utf-8') as fp:

    reader = csv.reader(fp)

    # 把第一行消掉

    next(fp)

    for x in reader:

        lists.append(x)

x = 0

while x < len(lists):

    print(x)

    print(len(lists[x]))

    resp = requests.get(lists[x][3])

    html = etree.HTML(resp.text)

    p = html.xpath("//div[@class='article-holder']//p/text()")

    title = html.xpath("//h1[@class='title']/text()")

    if len(p) != 0 and len(title) != 0:

       list_w = [lists[x][0],  lists[x][1], lists[x][2], lists[x][3], title[0], p[0]]

       lists_w.append(list_w)

    else:

        pass

    x = x + 1

print(lists_w)

with open('b.csv', 'w', encoding='utf-8', newline='') as fp:

    writer = csv.writer(fp)

    # 写入表头信息

    writer.writerow(a)

    writer.writerows(lists_w)
结果截图:
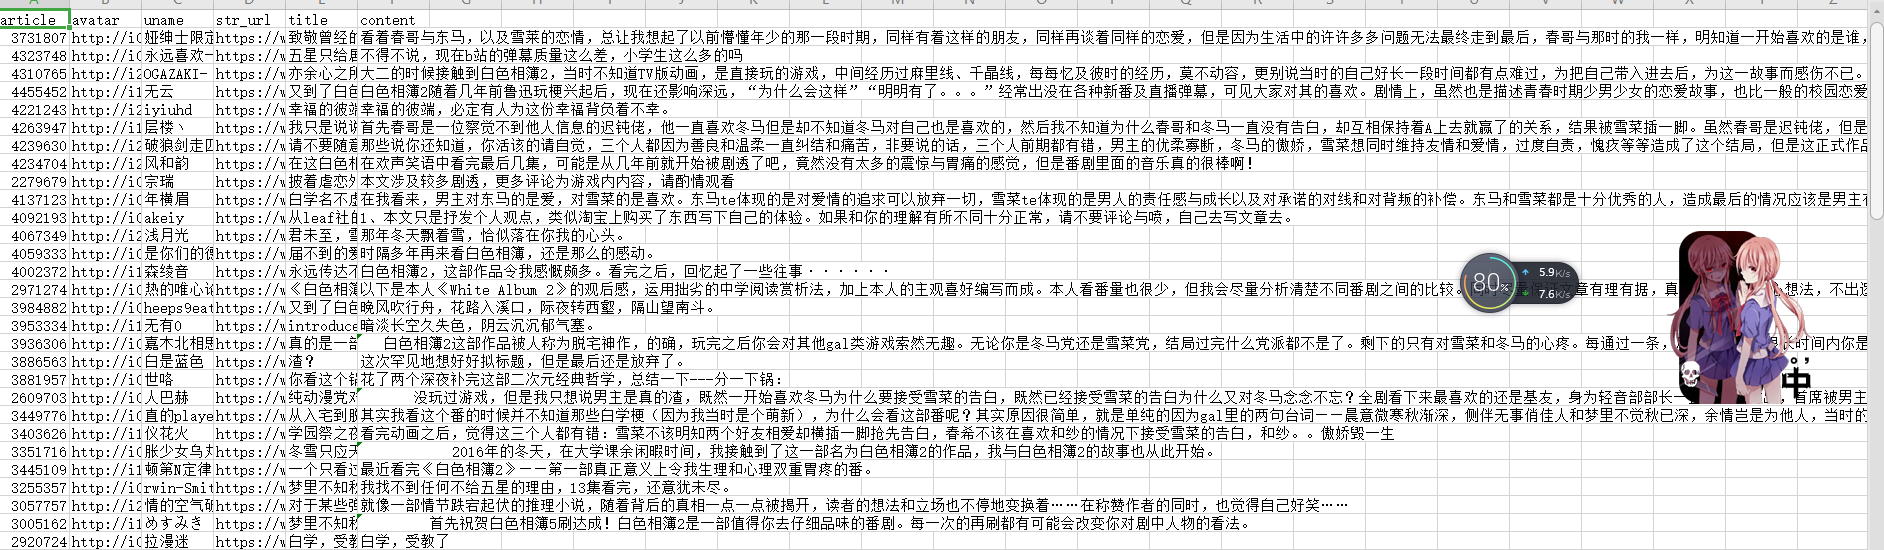
体会:遇到了几个问题,第一个是在谷歌的xpath helper软件里用xpth语言能够找到但是python就不行,后来我用python把整个网页下载下来,发现class属性是不一样的,然后就改了一下xpth语句就成功了,我们使用xpth语句就应对的是requests.get(url)返回的text,需要看text怎么写而不是看原网页的。第二个问题是我昨天爬的那个网页他今天没有了,因为数据就一百多条,我挨个看了一下那个长评的网页没有了,后来在代码加了限定就ok了。
学习进度05(billbill长评爬取02)的更多相关文章
- Java爬虫——网易云热评爬取
爬取目标网址 : http://music.163.com/#/song?id=409649818 需要爬取信息 : 网易云top13热评 使用之前的 HttpURLConnection 获取 ...
- 学习进度04(billbill长评数据提取01)
学习了python写入csv文件自己想了一个小实战,爬取billbill<白色相簿>番剧的长评 网页是动态变化的,往下拉他才会更新出长评,找出关键链接https://api.bilibil ...
- 2019-01-31 Python学习之BFS与DFS实现爬取邮箱
今天学习了python网络爬虫的简单知识 首先是一个爬取百度的按行读取和一次性爬取 逐行爬取 for line in urllib.request.urlopen("http://www.b ...
- python爬虫学习(三):使用re库爬取"淘宝商品",并把结果写进txt文件
第二个例子是使用requests库+re库爬取淘宝搜索商品页面的商品信息 (1)分析网页源码 打开淘宝,输入关键字“python”,然后搜索,显示如下搜索结果 从url连接中可以得到搜索商品的关键字是 ...
- 爬虫学习(四)——post请求爬取
百度翻译爬取数据 import urllib.requestimport urllib.parsepost_url = "https://fanyi.baidu.com/sug"h ...
- Python爬虫学习(5): 简单的爬取
学习了urllib,urlib2以及正则表达式之后就可以做一些简单的抓取以及处理工作.为了抓取方便,这里选择糗事百科的网页作为抓取对象. 1. 获取数据: In [293]: url = " ...
- JavaWeb学习总结-05 Servlet 与页面的交互(02)
一 模拟请求数据 为了测试方便,把请求 json,txt, xml,html格式的文件放到了公网上面,可以通过以下地址请求: http://wx.glab.cn/xpxiaowu4java/json/ ...
- 一起学爬虫——通过爬取豆瓣电影top250学习requests库的使用
学习一门技术最快的方式是做项目,在做项目的过程中对相关的技术查漏补缺. 本文通过爬取豆瓣top250电影学习python requests的使用. 1.准备工作 在pycharm中安装request库 ...
- [python爬虫] Selenium定向爬取虎扑篮球海量精美图片
前言: 作为一名从小就看篮球的球迷,会经常逛虎扑篮球及湿乎乎等论坛,在论坛里面会存在很多精美图片,包括NBA球队.CBA明星.花边新闻.球鞋美女等等,如果一张张右键另存为的话真是手都点疼了.作为程序员 ...
随机推荐
- C++获取驱动盘句柄
转载:https://www.cnblogs.com/sherlock-merlin/p/10792116.html https://univasity.iteye.com/blog/8052 ...
- 实用类-<字符串与基本类型的转换>
字符串与基本类型的转换 字符串->基本类型 int i5=Integer.parseInt("123"); System.out.println(i5); 基本类型-> ...
- CMake构建Qt5的VS2015项目 (Hello Qt5)
Qt5的编译 Windows下载编译Qt5 Gui CMakeLists.txt 源码 cmake_minimum_required(VERSION 2.8.11) project(HelloQt5) ...
- JS拖拽-面向对象拖拽-继承
//普通拖拽 /* * CSS */ #div1{ width:100px; height:100px; position:absolute; background:red; cursor:move; ...
- 如何在ubuntu14.04(64位)编译运行32位程序
sudo -i cd /etc/apt/sources.list.d echo "deb http://archive.ubuntu.com/ubuntu/ raring main rest ...
- 页面自动执行js的3种方法
1.最简单的调用方式,直接写到html的body标签里面: <html> <body onload="load();"> </body> & ...
- 对iOS开发的一些认识
从事iOS工作这么久了,我觉得对它的认识也越来越深刻.尤其是越发明白自己从事的工作属于“客户端开发”.“软件工程”分类中. 我更喜欢“客户端开发”这个词语,相对“前端开发”而言.因为前者更能充分说明面 ...
- 洛谷 P3320 [SDOI2015]寻宝游戏
因为寻宝路径是一个环,所以寻宝花费的最小时间与起点无关.宝应当按照所有宝藏所在位置的 dfs 序进行才能够使得花费的时间最短.设 \(dist_i\) 表示 \(i\) 到树根的最短距离,那么树上任意 ...
- Django(二十)下拉列表-省市联动实例:jquery的ajax处理前端
一.知识点 1.jquery的ajax请求写法 <script src="/static/js/jquery-1.12.4.min.js"></script> ...
- 这两天的pwn学习总结
总是一会儿切到那里,一会儿切到那里,要明确一条主线,就是buu的题,而不是按着什么视频教程还有linux和python教程去学习.那样效率比较低. 一切为了写wp为本,不胡乱点击就是提高效率的最好办法 ...