
python爬虫学习(三):使用re库爬取"淘宝商品",并把结果写进txt文件
第二个例子是使用requests库+re库爬取淘宝搜索商品页面的商品信息
(1)分析网页源码
打开淘宝,输入关键字“python”,然后搜索,显示如下搜索结果
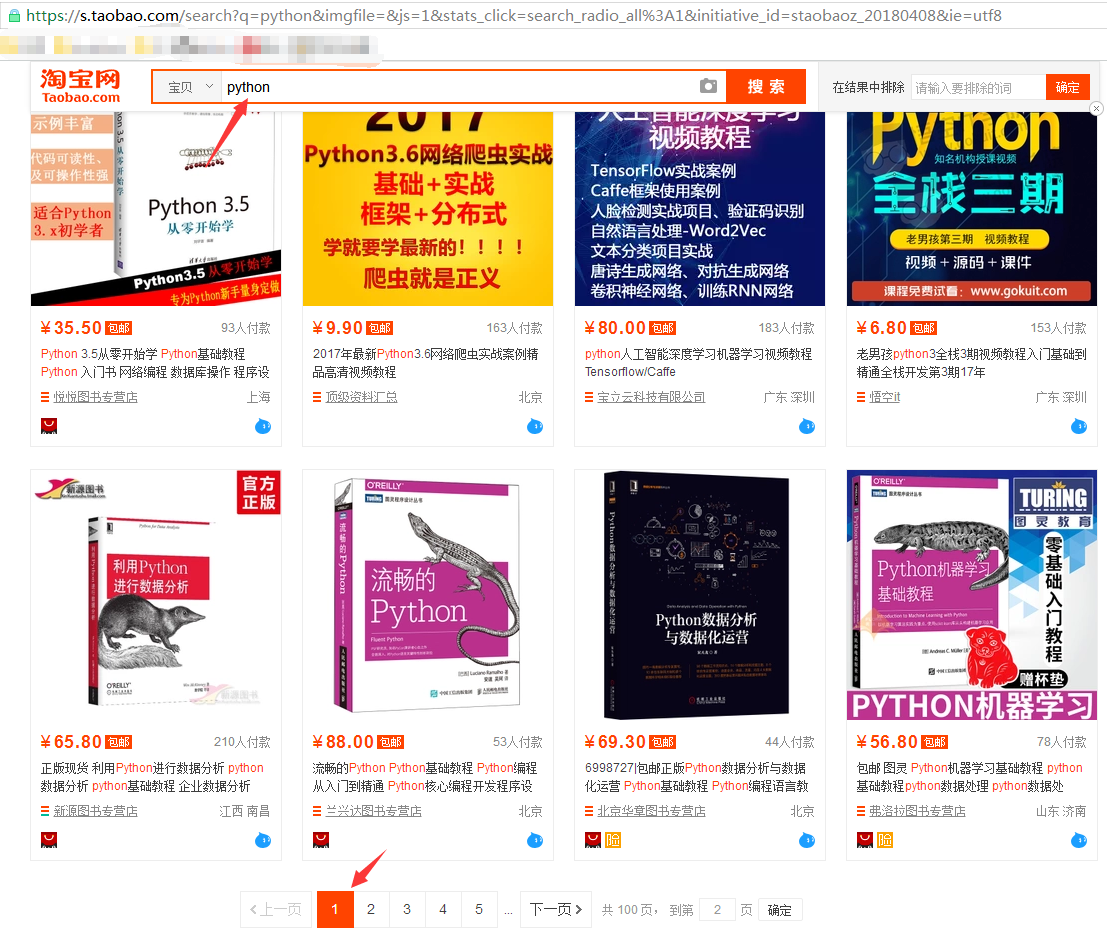
从url连接中可以得到搜索商品的关键字是“q=”,所以我们要用的起始url为:https://s.taobao.com/search?q=python
然后翻页,先跳到第二页,url变为:

再跳到第三页,url变为:

经过对比发现,翻页后,变化的关键字是s,每次翻页,s便以44的倍数增长(可以数一下每页显示的商品数量,刚好是44)
所以可以根据关键字“s=”,来设置爬取的深度(爬取多少页)
右键查看源码:
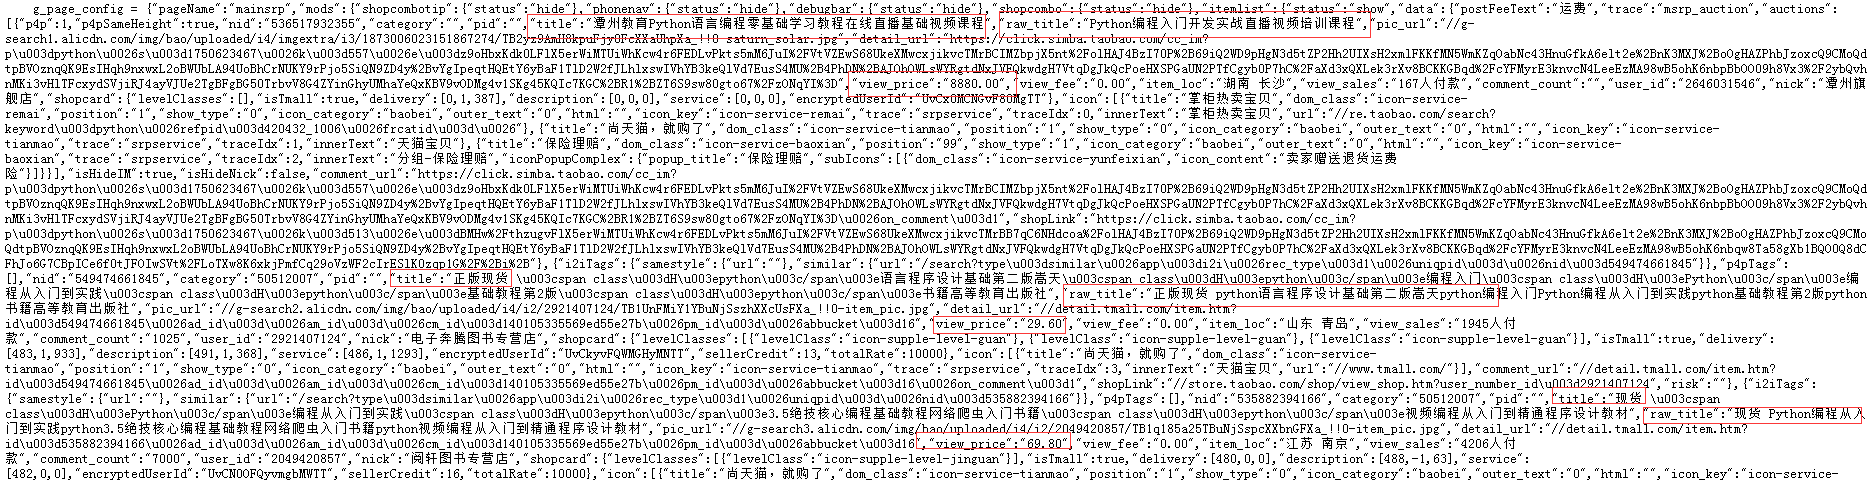
分析商品名称和商品价格分别由哪个关键字控制:
商品名称可能的关键字是“title”和“raw_title”,进一步多看几个商品的名称,发现选取“raw_title”比较合适;商品价格自然就是“view_price”(通过比对淘宝商品展示页面);
所以商品名称和商品价格分别是以 "raw_title":"名称" 和 "view_price":"价格",这样的键/值对的形式展示的。
(2)分析如何实现
与上一个例子爬取“最好大学排名”不同,淘宝商品信息不像之前的大学信息是以HTML格式嵌入的,这里的商品信息并未以HTML标签的形式处理数据,而是直接以脚本语言放进来的,所以不需要用BeautifulSoup来解析,直接用正则表达式提取 关键字信息即可
(3)提取信息
写个demo,看看是如何一步步解析信息的
# coding:utf-8

import requests

import re

goods = '水杯'

url = 'https://s.taobao.com/search?q=' + goods

r = requests.get(url=url, timeout=10)

html = r.text

tlist = re.findall(r'\"raw_title\"\:\".*?\"', html)  # 正则提取商品名称

plist = re.findall(r'\"view_price\"\:\"[\d\.]*\"', html)  # 正则提示商品价格

print(tlist)

print(plist)

print(type(plist))  #  正则表达式提取出的商品名称和商品价格都是以列表形式存储数据的

去掉列表中的键,只留下值,也就是去掉每组数据的“raw_title”和“view_price”
print('第一个商品的键值对信息:', tlist[0])  # 查看第一个商品的键值对信息

a = tlist[0].split(':')[1]  # 使用split()方法以":"为切割点,将商品的键值分开,提取值,即商品名称

print('第一个商品的名称', a)

print(type(a))  # 查看a的类型

b = eval(a)  # 使用eval()函数,去掉字符串的引号

print('把商品名称去掉引号后', b)  # 查看去掉引号后的效果

print(type(b))  # 查看b的类型

利用for循环,把每个商品的名称和价格组成一个列表,然后把这写列表再追加到一个大列表中:
goodlist = []

for i in range(len(tlist)):

    title = eval(tlist[i].split(':')[1])  # eval()函数简单说就是用于去掉字符串的引号

    price = eval(plist[i].split(':')[1])

    goodlist.append([title, price]) # 把每个商品的名称和价格组成一个小列表,然后把所有商品组成的列表追加到一个大列表中

    print(goodlist)

完整代码:
# coding: utf-8

import requests

import re

# def getHTMLText(url):

#     try:

#         r = requests.get(url, timeout=30)

#         r.raise_for_status()

#         r.encoding = r.apparent_encoding

#         return r.text

#     except:

#         return ""

#

#

# def parsePage(ilt, html):

#     try:

#         plt = re.findall(r'\"view_price\"\:\"[\d\.]*\"', html)

#         tlt = re.findall(r'\"raw_title\"\:\".*?\"', html)

#         for i in range(len(plt)):

#             price = eval(plt[i].split(':')[1])

#             title = eval(tlt[i].split(':')[1])

#             ilt.append([price, title])

#     except:

#         print()

#

#

# def printGoodsList(ilt):

#     tplt = "{:4}\t{:8}\t{:16}"

#     print(tplt.format("序号", "价格", "商品名称"))

#     count = 0

#     for t in ilt:

#         count = count + 1

#         print(tplt.format(count, t[0], t[1]))

#

#

# def main():

#     goods = '高达'

#     depth = 3

#     start_url = 'https://s.taobao.com/search?q=' + goods

#     infoList = []

#     for i in range(depth):

#         try:

#             url = start_url + '&s=' + str(44 * i)

#             html = getHTMLText(url)

#             parsePage(infoList, html)

#         except:

#             continue

#     printGoodsList(infoList)

#

#

# main()

def get_html(url):

    """获取源码html"""

    try:

        r = requests.get(url=url, timeout=10)

        r.encoding = r.apparent_encoding

        return r.text

    except:

        print("获取失败")

def get_data(html, goodlist):

    """使用re库解析商品名称和价格

    tlist:商品名称列表

    plist:商品价格列表"""

    tlist = re.findall(r'\"raw_title\"\:\".*?\"', html)

    plist = re.findall(r'\"view_price\"\:\"[\d\.]*\"', html)

    for i in range(len(tlist)):

        title = eval(tlist[i].split(':')[1])  # eval()函数简单说就是用于去掉字符串的引号

        price = eval(plist[i].split(':')[1])

        goodlist.append([title, price])

def write_data(list, num):

    # with open('E:/Crawler/case/taob2.txt', 'a') as data:

    #    print(list, file=data)

    for i in range(num):  # num控制把爬取到的商品写进多少到文本中

        u = list[i]

        with open('E:/Crawler/case/taob.txt', 'a') as data:

            print(u, file=data)

def main():

    goods = '水杯'

    depth = 3   # 定义爬取深度,即翻页处理

    start_url = 'https://s.taobao.com/search?q=' + goods

    infoList = []

    for i in range(depth):

        try:

            url = start_url + '&s=' + str(44 * i)  # 因为淘宝显示每页44个商品,第一页i=0,一次递增

            html = get_html(url)

            get_data(html, infoList)

        except:

            continue

    write_data(infoList, len(infoList))

if __name__ == '__main__':

    main()

python爬虫学习(三):使用re库爬取"淘宝商品",并把结果写进txt文件的更多相关文章
- python爬虫学习之使用BeautifulSoup库爬取开奖网站信息-模块化
实例需求:运用python语言爬取http://kaijiang.zhcw.com/zhcw/html/ssq/list_1.html这个开奖网站所有的信息,并且保存为txt文件和excel文件. 实 ...
- python爬虫实例,一小时上手爬取淘宝评论(附代码)
前言 本文的文字及图片来源于网络,仅供学习.交流使用,不具有任何商业用途,版权归原作者所有,如有问题请及时联系我们以作处理. 1 明确目的 通过访问天猫的网站,先搜索对应的商品,然后爬取它的评论数据. ...
- Python 爬虫实例(9)—— 搜索 爬取 淘宝
# coding:utf- import json import redis import time import requests session = requests.session() impo ...
- Python爬虫实战八之利用Selenium抓取淘宝匿名旺旺
更新 其实本文的初衷是为了获取淘宝的非匿名旺旺,在淘宝详情页的最下方有相关评论,含有非匿名旺旺号,快一年了淘宝都没有修复这个. 可就在今天,淘宝把所有的账号设置成了匿名显示,SO,获取非匿名旺旺号已经 ...
- Python 爬取淘宝商品数据挖掘分析实战
Python 爬取淘宝商品数据挖掘分析实战 项目内容 本案例选择>> 商品类目:沙发: 数量:共100页 4400个商品: 筛选条件:天猫.销量从高到低.价格500元以上. 爬取淘宝商品 ...
- python3编写网络爬虫16-使用selenium 爬取淘宝商品信息
一.使用selenium 模拟浏览器操作爬取淘宝商品信息 之前我们已经成功尝试分析Ajax来抓取相关数据,但是并不是所有页面都可以通过分析Ajax来完成抓取.比如,淘宝,它的整个页面数据确实也是通过A ...
- 利用Selenium爬取淘宝商品信息
一. Selenium和PhantomJS介绍 Selenium是一个用于Web应用程序测试的工具,Selenium直接运行在浏览器中,就像真正的用户在操作一样.由于这个性质,Selenium也是一 ...
- Selenium+Chrome/phantomJS模拟浏览器爬取淘宝商品信息
#使用selenium+Carome/phantomJS模拟浏览器爬取淘宝商品信息 # 思路: # 第一步:利用selenium驱动浏览器,搜索商品信息,得到商品列表 # 第二步:分析商品页数,驱动浏 ...
- <day003>登录+爬取淘宝商品信息+字典用json存储
任务1:利用cookie可以免去登录的烦恼(验证码) ''' 只需要有登录后的cookie,就可以绕过验证码 登录后的cookie可以通过Selenium用第三方(微博)进行登录,不需要进行淘宝的滑动 ...
随机推荐
- 问题:grid卸载后重新安装时ASM磁盘识别不到了
现象,磁盘路径是对的,但是识别不出来asmdisk2 系统显示磁盘也存在 识别不到的原因是:安装了一次磁盘已经有asm信息写入,需要擦除才能重新被识别到,命令如下 [root@swnode1 dev] ...
- JAVA中拆箱和装箱
浅谈JAVA中拆箱与装箱 一. 什么是装箱?什么是拆箱? 在Java SE5之前,如果要生成一个数值为10的Integer对象,必须这样进行: Integer i = new Integer(10) ...
- CSS的进一步深入(更新中···)
在之前我们学了6种选择器和三种CSS样式的引入,学习选择器就是为了更好的选择文本,学习CSS的引入是为了使文本增加各种样式和属性, 下面我们简单来学习一下为文本加样式和一些属性和属性值: 1.文本的样 ...
- Intellij IDEA 安装配置Gradle
1.安装 到官网链接下载最新的bin版本,解压到 D:\Program Files (x86)\JetBrains\IDEA Configuration And Cache\gradle 配置环境变量 ...
- 【第四十章】Spring Boot 自定义拦截器
1.首先编写拦截器代码 package com.sarnath.interceptor; import javax.servlet.http.HttpServletRequest; import ja ...
- FastQC结果详解
REF https://www.plob.org/article/5987.html 解压后,查看html格式的结果报告.结果分为如下几项: 结果分为绿色的"PASS",黄色的&q ...
- 在同一台电脑部署多个Tomcat服务
背景:公司的项目使用的是jdk1.6,Tomcat7.0,比较旧,打算建一些测试项目用jdk1.8,Tomcat9.0. 参考了网上几篇文章 http://dong-shuai22-126-com.i ...
- Google advertiser api开发概述——最佳做法&建议
最佳做法 本指南介绍了一些最佳做法,您可以运用它们来优化 AdWords API 应用的效率和性能. 日常维护 为确保您的应用不间断运行,可采取以下做法: 确保 AdWords API 中心中的开发者 ...
- 《算法竞赛入门经典》刘汝佳 C语言部分(前四章)“注解与习题” 之思索 -<1>
此书我购于去年的十一月份,也是经前人推荐购买的一本比较有用的书籍,在寒假自学此书,其简洁清晰高效的示例代码令我印象深刻,于是我打算把这本书的前四章后面的注解与习题(未给出标准解答)认真的去思索和研究, ...
- C# 调用Windows图片查看器
/// <summary> /// 查看原图 /// </summary> /// <param name="image"></param ...