
5.2 RDD编程---键值对RDD
一、键值对RDD的创建
1.从文件中加载
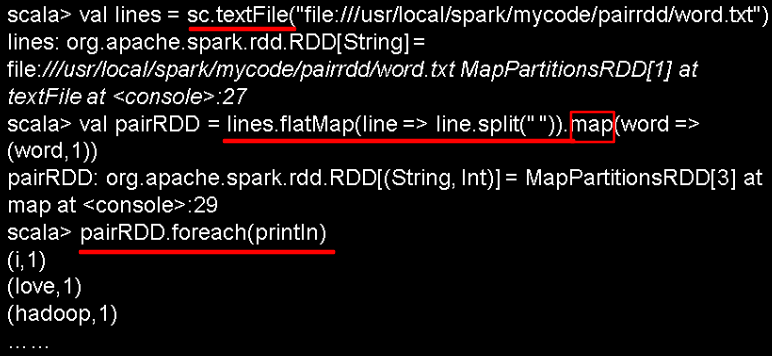
2.通过并行集合(数组)创建RDD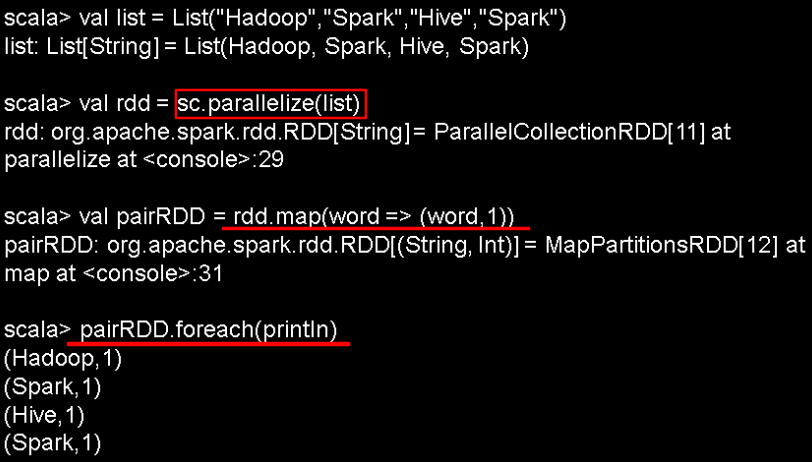
二、常用的键值对RDD转换操作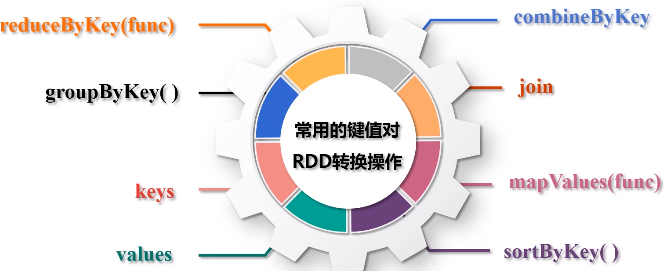
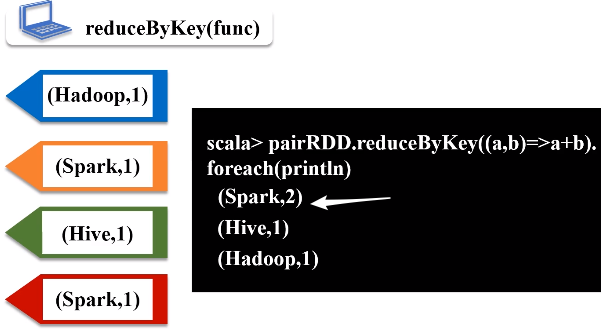
1.reduceByKey(func)
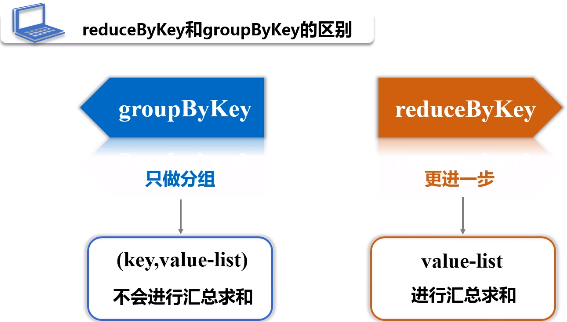
功能:使用func函数合并具有相同键的值
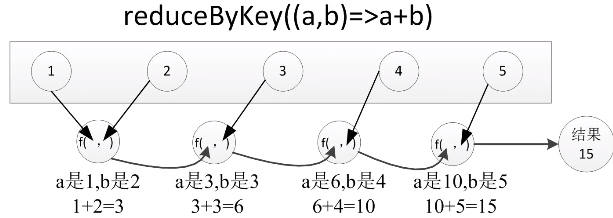
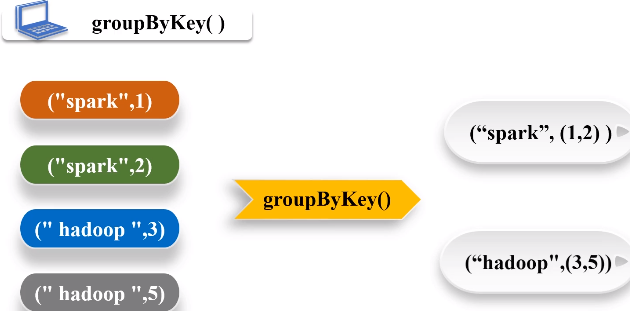
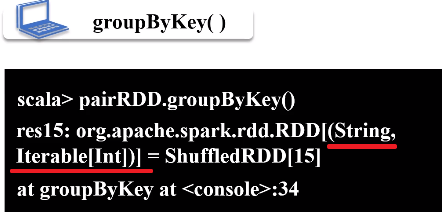
2.groupByKey()
功能:对具有相同键的值进行分组

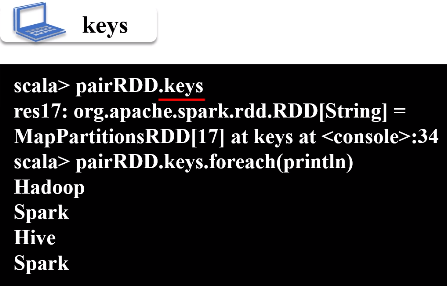
3.keys
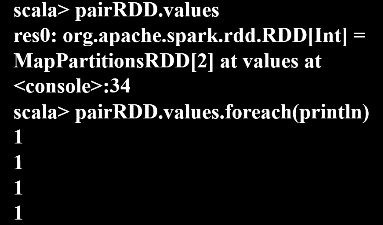
4.values
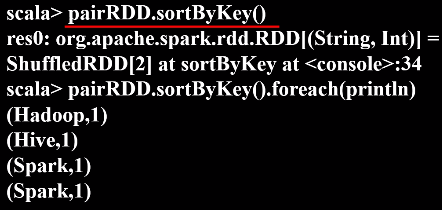
5.sortByKey()
默认按升序排序,括号里写false为降序排序
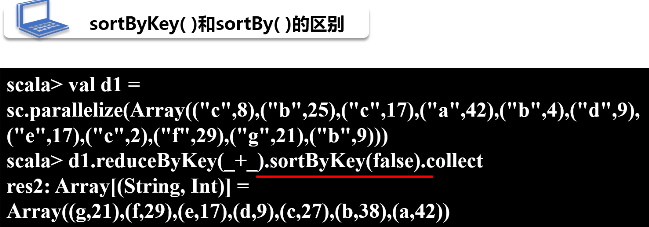
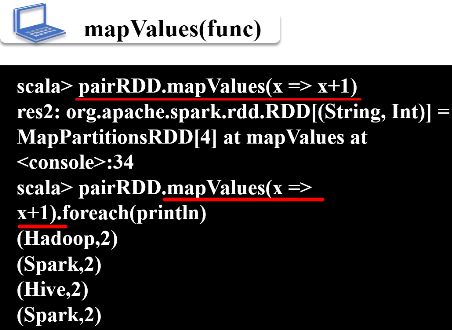
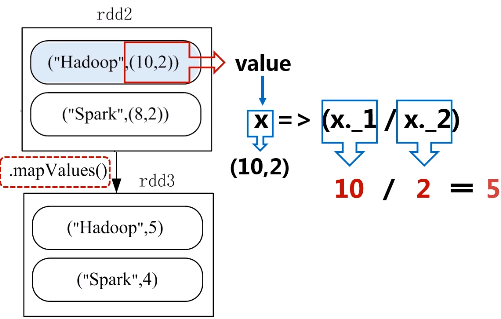
6.mapValues(func)
功能:对键值对RDD中的每个value都应用一个函数,key不会发生变化。
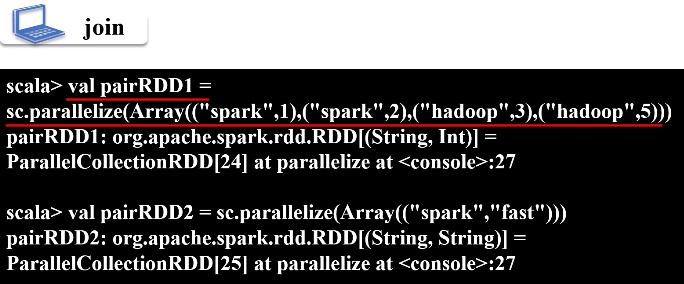
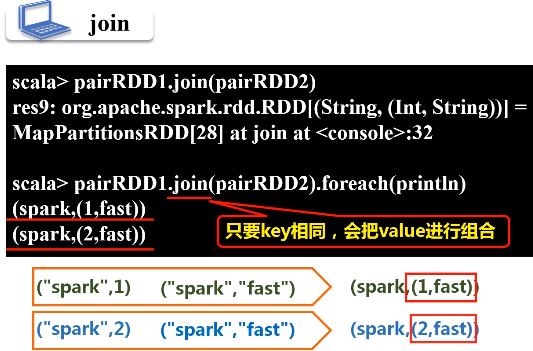
7.join
功能:把几个RDD当中元素key相同的进行连接
8.combineByKey
combineByKey(createCombiner,mergeValue,mergeCombiners,partitioner,mapSideCombine)
createCombiner:在第一次遇到Key时创建组合器函数,将RDD数据集中的V类型值转换C类型值(V => C)
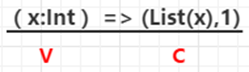
mergeValue:合并值函数,再次遇到相同的Key时,将createCombiner的C类型值与这次传入的V类型值合并成一个C类型值(C,V)=>C

mergeCombiners:合并组合器函数,将C类型值两两合并成一个C类型值
partitioner:使用已有的或自定义的分区函数,默认是HashPartitioner mapSideCombine:是否在map端进行Combine操作,默认为true
注意:前三个函数的参数类型要对应;第一次遇到Key时调用createCombiner,再次遇到相同的Key时调用mergeValue合并值
例:编程实现自定义Spark合并方案。给定一些销售数据,数据采用键值对的形式<公司,收入>,求出每个公司的总收入和平均收入,保存在本地文件
提示:可直接用sc.parallelize在内存中生成数据,在求每个公司总收入时,先分三个分区进行求和,然后再把三个分区进行合并。只需要编写RDD combineByKey函数的前三个参数的实现。
三、综合实例
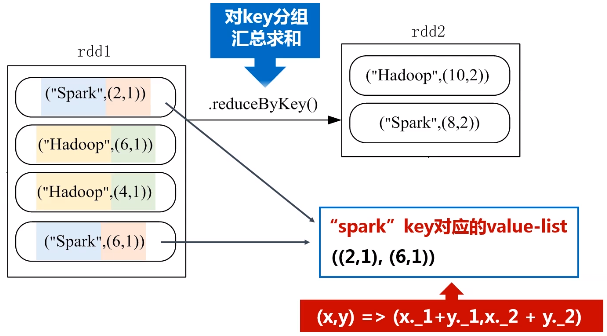
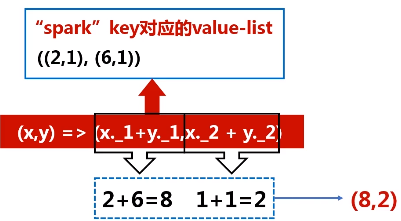
题目:给定一组键值对("spark",2),("hadoop",6),("hadoop",4),("spark",6),键值对的key表示图书名称,value表示某天图书销量,请计算每个键对应的平均值,也就是计算每种图书的每天平均销量。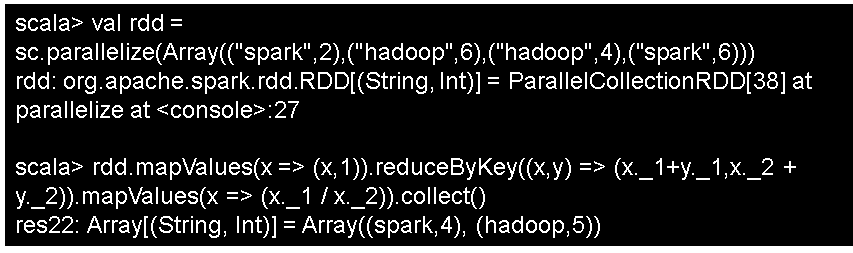
5.2 RDD编程---键值对RDD的更多相关文章
- Spark 键值对RDD操作
键值对的RDD操作与基本RDD操作一样,只是操作的元素由基本类型改为二元组. 概述 键值对RDD是Spark操作中最常用的RDD,它是很多程序的构成要素,因为他们提供了并行操作各个键或跨界点重新进行数 ...
- 3. 键值对RDD
键值对RDD是Spark中许多操作所需要的常见数据类型.除了在基础RDD类中定义的操作之外,Spark为包含键值对类型的RDD提供了一些专有的操作在PairRDDFunctions专门进行了定义.这些 ...
- 2. RDD编程
2.1 编程模型 在Spark中,RDD被表示为对象,通过对象上的方法调用来对RDD进行转换.经过一系列的transformations定义RDD之后,就可以调用actions触发RDD的计算,act ...
- Learning Spark中文版--第四章--使用键值对(1)
本章介绍了如何使用键值对RDD,Spark中很多操作都基于此数据类型.键值对RDD通常在聚合操作中使用,而且我们经常做一些初始的ETL(extract(提取),transform(转换)和load ...
- 【Spark 深入学习 07】RDD编程之旅基础篇03-键值对RDD
--------------------- 本节内容: · 键值对RDD出现背景 · 键值对RDD转化操作实例 · 键值对RDD行动操作实例 · 键值对RDD数据分区 · 参考资料 --------- ...
- Spark学习之键值对(pair RDD)操作(3)
Spark学习之键值对(pair RDD)操作(3) 1. 我们通常从一个RDD中提取某些字段(如代表事件时间.用户ID或者其他标识符的字段),并使用这些字段为pair RDD操作中的键. 2. 创建 ...
- 5.1 RDD编程
一.RDD编程基础 1.创建 spark采用textFile()方法来从文件系统中加载数据创建RDD,该方法把文件的URL作为参数,这个URL可以是: 本地文件系统的地址 分布式文件系统HDFS的地址 ...
- spark RDD编程,scala版本
1.RDD介绍: RDD,弹性分布式数据集,即分布式的元素集合.在spark中,对所有数据的操作不外乎是创建RDD.转化已有的RDD以及调用RDD操作进行求值.在这一切的背后,Spark会自动 ...
- 02、体验Spark shell下RDD编程
02.体验Spark shell下RDD编程 1.Spark RDD介绍 RDD是Resilient Distributed Dataset,中文翻译是弹性分布式数据集.该类是Spark是核心类成员之 ...
随机推荐
- 21.Java基础_String类
String类构造方法 package pack1; //推荐使用直接赋值的方式得到字符串 public class test { public static void main(String[] a ...
- TeamyinyinFish-> 测试报告
测试人员 1. 姓名:鱼嘤嘤 2. 年龄: 21 3. 职业: 大三学生 4. 感情状况: 单身 用户故事 软件工程课上,老师想要他们组实现一个小组项目,鱼嘤嘤原本想摸鱼,但是转念一想觉得 还是需要好 ...
- C++ 标准库 std::remove
参见:https://zh.cppreference.com/w/cpp/algorithm/remove std::remove 不会改变输入vector / string 的长度.其过程,相当于去 ...
- jenkins构建:通过testng.xml构建项目
1.项目的pom.xml中build下添加maven插件,xmlFileName为可变参数 2.jenkins新建maven项目 构建脚本: 原文:https://www.jianshu.com/p/ ...
- Velocity与Jsp、Freemarker的对比
在java领域,表现层技术主要有三种:jsp.freemarker.velocity.jsp是大家最熟悉的技术 优点: 1.功能强大,可以写java代码 2.支持jsp标签(jsp tag) 3.支持 ...
- 设计模式-Prototype(通过复制构造函数实现自我复制)-(创建型模式)
以下代码来源: 设计模式精解-GoF 23种设计模式解析附C++实现源码 //Prototype.h #pragma once class Prototype { public: virtual ~P ...
- 设计模式-单例模式(Singleton) (创建型模式)
//以下代码来源: 设计模式精解-GoF 23种设计模式解析附C++实现源码 //Singleton.h #pragma once #include<iostream> class Sin ...
- Vue v-for操作对象与数值
<!doctype html> <html lang="en"> <head id="head"> <meta cha ...
- zz错误集锦
1.csp-s模拟测试63 T1 2e8的数组开bitset会ce,开bool就可以了,bool一位占一个字节,不是四个字节 2.csp-s模拟测试65 T2 把用vector存图改成前向星,就A了, ...
- Paper | Compression artifacts reduction by a deep convolutional network
目录 1. 故事 2. 方法 3. 实验 这是继SRCNN(超分辨)之后,作者将CNN的战火又烧到了去压缩失真上.我们看看这篇文章有什么至今仍有启发的故事. 贡献: ARCNN. 讨论了low-lev ...