
HDFS原理解析
一、HDFS简介
HDFS为了做到可靠性(reliability)创建了多分数据块(data blocks)的复制(replicas),并将它们放置在服务器群的计算节点中(computer nodes),MapReduce就可以在它们所在的节点上处理这些数据了。
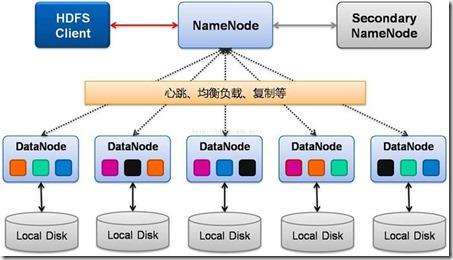
1.1 HDFS数据存储单元(block)
- 文件被切分成固定大小的数据块
- 默认数据块大小为64M(Hadoop 2.x默认为128M),可配置
- 若文件大小不足64M,则单纯存为一个block
- 文件存储方式
- 按大小被切分成若干个block,存储到不同的节点上
- 默认情况下每个block都有三个副本
- Block的大小和副本数通过client端上传文件时设置,文件上传成功后副本数可以变更,block size不可变更
1.2 Namenode(NN)
- NameNode主要功能:接收客户端的读写服务
- NameNode保存metadata信息包括
- 文件owership和permissions
- 文件包含哪些块
- Block保存在哪些DataNode(由DataNode启动时上报)
- NameNode的metadata信息在启动后会加载到内存
- metadata存储到磁盘文件名为 fsimage
- Block的位置信息不会保存到 fsimage
- edits文件记录了对metadata的操作日志
1.3 DataNode(DN)
存储数据(Block)
- 启动DN线程的时候回向NN汇报block信息
- 通过向NN发送心跳保持与其联系(3秒一次),如果NN 10分钟内没有收到DN的心跳,则认为其已经lost,并copy其上的block到其他的DN
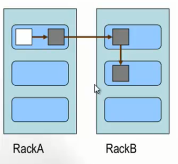
1.2.1 Block的副本放置策略
第一个副本:放置在上传文件的DN;如果是集群外提交,则随机挑选一台磁盘不太满,CPU不太忙的节点。
第二个副本:放置在与第一个副本不同的机架上的节点上。
第三个副本:放置在与第二个副本相同机架的节点。
更多副本:随机节点
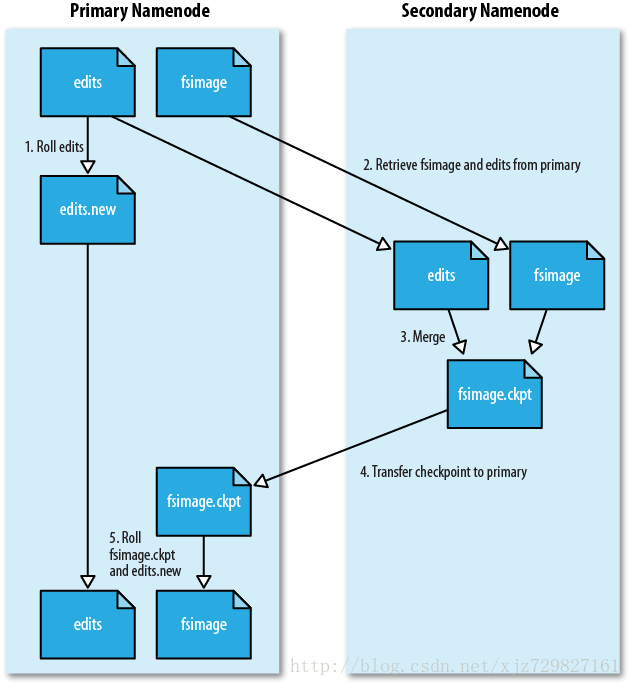
1.4 SecondNameNode
- 它不是NN的备份(但可以做备份),它的主要工作是帮助NN合并edits log,减少NN启动时间。
- SNN执行合并时机
- 根据配置文件设置的时间间隔fs.checkpoint.period 默认3600秒
- 根据配置文件设置edits log大小 fs.checkpoint.size 规定edits文件的最大值,默认64M
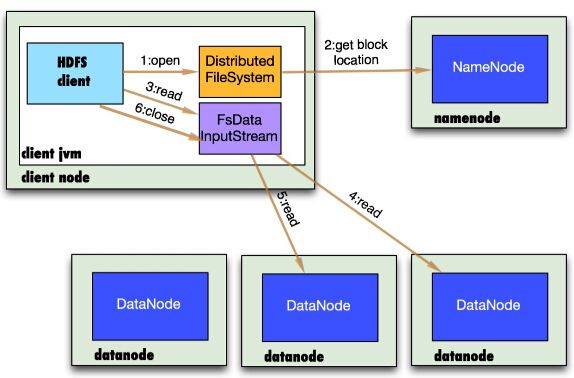
1.5 HDFS读流程
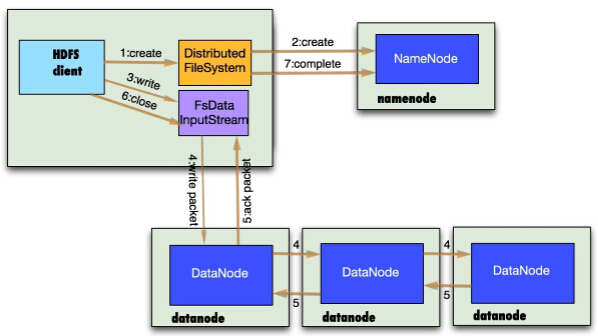
1.6 HDFS写流程
1.7 HDFS优缺点:
优点:
- 高容错性
- 数据自动保存多个副本
- 副本丢失后,自动回复
- 适合批处理适合大数据处理
- 移动计算而非数据
- 数据位置暴露给计算框架
- 可构架在廉价机器上
缺点:
- 低延迟数据访问
- 比如毫秒级
- 低延迟与高吞吐率
- 小文件存取
- 占用NameNode大量内存
- 寻道时间超过读取时间
- 并发写入、文件随机修改
- 一个文件只能有一个写者
- 仅支持append
二、HDFS2.x
2.1 Hadoop 2.0产生背景
- Hadoop1.0中HDFS和MapReduce在高可用、扩展性等方面存在问题
- HDFS存在的问题
- NameNode单点故障,男衣应用于在线场景
- NameNode压力过大,且内存受限,影响系统扩展性
- MapReduce存在的问题
- JboTracker访问压力大,影响系统扩展性
- 难以支持除MapReduce之外的计算框架,比如Spark、Storm等
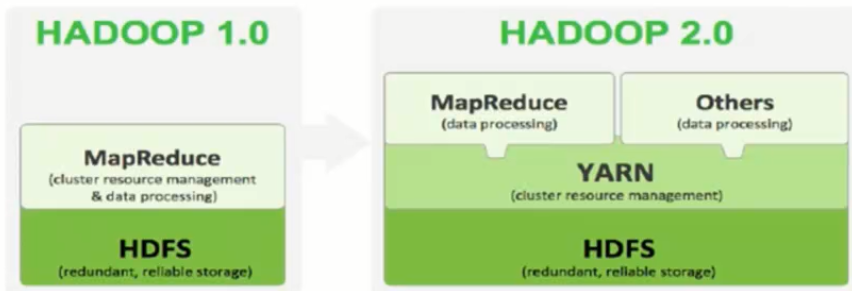
- Hadoop 2.x由HDFS、MapReduce和YARN三个分支构成
- HDFS:NN Federation、HA
- MapReduce:运行在YARN上的MR
- YARN:资源管理系统
2.2 HDFS 2.x特点
- 解决HDFS 1.0中单点故障和内存受限问题
- 解决单点故障
- HDFS HA:通过主备NameNode解决
- 如果主NameNode发生故障,则切换到备NameNode上
- 解决内存受限问题
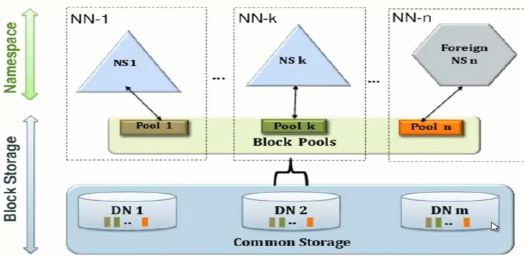
- HDFS Federation(联邦)
- 水平扩展,支持多个NameNode
- 每个NameNode分管一部分目录
- 所有NameNode共享所有的DataNode存储资源
- 2.x仅是架构上发生了变化,使用方式不变
- 对HDFS使用者透明
- HDFS1.x中的命令和API仍可以使用
2.3 HDFS 2.x HA
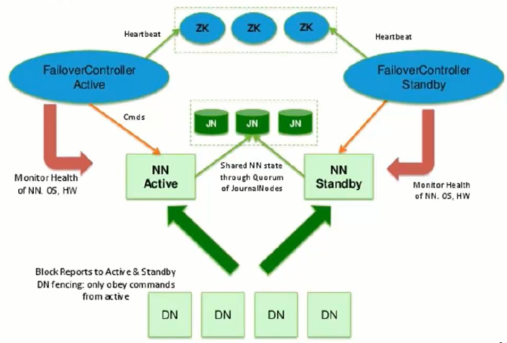
- 主备NameNode
- 解决单点故障
- 主NameNode对外提供服务,备NameNode同步主NameNode元数据,以待切换
- 所有DataNode同时向两个NameNode汇报数据块信息
- 两种切换选择
- 手动切换:通过命令实现主备之间的切换,可以用HDFS升级等场合
- 自动切换:基于Zookeeper实现
- 基于Zookeeper自动切换方案
- Zookeeper Failover Controller:监控NameNode健康状态
- 并向Zookeeper注册NameNode
- NameNode挂掉后,ZKFC为NameNode竞争锁,获得ZKFC锁的NameNode变为active
2.4 HDFS 2.x Federation
- 通过多个NameNode/namespace把元数据的存储和管理分散到多个节点中,使得NameNode/namespace可以通过增加机器来进行水平扩展。
- 能把单个namenode的负载分散到多个节点中,在HDFS数据规模较大的时候不会降低HDFS的性能。可以通过多个namespace来隔离不同类型的应用,把不同类型应用的HDFS元数据的存储和管理分派到不同的namenode中。
2.5 YARN
- YARN:Yet Another Resource Negotiator
- Hadoop 2.0新引入的资源管理系统,直接从MRv1演化二来的
- 核心思想:将MRv1中JobTracker的资源管理和任务调度两个功能分开,分别由ResourceManager和ApplicationMaster进程实现
- ResourceManager:负责整个集群的资源管理和调度
- ApplicationMaster:负责应用程序相关的事务,比如任务调度、任务监控和容错等
- YARN的引入,使得多个计算框架可运行在一个集群中
- 每个应用程序对应一个ApplicationMaster
- 目前多个计算框架可以运行在YARN中,比如MapReduce、Spark、Storm等
2.6 MapReduce On YARN
- MapReduce On YARN:MRv2
- 将MapReduce作业直接运行在YARN中,而不是由JobTracker和TaskTracker构建的MRv1中
- 基本功能模块
- YARN:复制资源管理和调度
- MRAppMaster:负责任务切分、任务调度、任务监控和容错等
- MapTask/ReduceTask:任务驱动引擎,与MRv1一致
- 每个MapReduce作业对应一个MRAppMaster
- MRAppMaster任务调度
- YARN将资源分配给MRAppMaster
- MRAppMaster进一步将资源分配给内部的任务
- MRAppMaster容错
- 失败后,由YARN重新启动
- 任务失败后,MRAppMaster重新申请资源
HDFS原理解析的更多相关文章
- HDFS 原理解析
源自https://www.cnblogs.com/duanxz/p/3874009.html Namenode是整个文件系统的管理节点.它维护着整个文件系统的文件目录树,文件/目录的元信息和每个文件 ...
- HDFS原理解析(总体架构,读写操作流程)
前言 HDFS 是一个能够面向大规模数据使用的,可进行扩展的文件存储与传递系统.是一种允许文件通过网络在多台主机上分享的文件系统,可让多机器上的多用户分享文件和 存储空间.让实际上是通过网络来访问文件 ...
- HDFS原理解析(整体架构,读写操作流程及源代码查看等)
前言 HDFS 是一个能够面向大规模数据使用的.可进行扩展的文件存储与传递系统.是一种同意文件通过网络在多台主机上分享的文件系统,可让多机器上的多用户分享文件和存储空间.让实际上是通过网络来訪问文件的 ...
- HDFS之四:HDFS原理解析(总体架构,读写操作流程)
前言 HDFS 是一个能够面向大规模数据使用的,可进行扩展的文件存储与传递系统.是一种允许文件通过网络在多台主机上分享的文件系统,可让多机器上的多用户分享文件和 存储空间.让实际上是通过网络来访问文件 ...
- HDFS 原理、架构与特性介绍--转载
原文地址:http://www.uml.org.cn/sjjm/201309044.asp 本文主要讲述 HDFS原理-架构.副本机制.HDFS负载均衡.机架感知.健壮性.文件删除恢复机制 1:当前H ...
- Hadoop之HDFS原理及文件上传下载源码分析(上)
HDFS原理 首先说明下,hadoop的各种搭建方式不再介绍,相信各位玩hadoop的同学随便都能搭出来. 楼主的环境: 操作系统:Ubuntu 15.10 hadoop版本:2.7.3 HA:否(随 ...
- Hadoop之HDFS原理及文件上传下载源码分析(下)
上篇Hadoop之HDFS原理及文件上传下载源码分析(上)楼主主要介绍了hdfs原理及FileSystem的初始化源码解析, Client如何与NameNode建立RPC通信.本篇将继续介绍hdfs文 ...
- HDFS 原理、架构与特性介绍
本文主要讲述 HDFS原理-架构.副本机制.HDFS负载均衡.机架感知.健壮性.文件删除恢复机制 1:当前HDFS架构详尽分析 HDFS架构 •NameNode •DataNode •Senc ...
- HA 高可用集群概述及其原理解析
HA 高可用集群概述及其原理解析 1. 概述 1)所谓HA(High Available),即高可用(7*24小时不中断服务). 2)实现高可用最关键的策略是消除单点故障.HA严格来说应该分成各个组件 ...
随机推荐
- UVA_11922 Permutation Transformer 【splay树】
一.题目 UVA11922 二.分析 为什么会有伸展树? 伸展树与AVL的区别除了保持平衡的方式不同外,最重要的是在每次查找点时,让该点旋转到根结点,这里可以结合计算机里的局部性原理思考. 伸展树有什 ...
- 思科设备配置DHCP服务
路由器,三层交换机都是可以做DHCP服务的,下面以Cisco 3750G-24TS-S为例配置DHCP服务,指令如下: ip dhcp pool DHCP-Server network 192.168 ...
- Bomb(要49)--数位dp
Bomb Time Limit: 2000/1000 MS (Java/Others) Memory Limit: 131072/65536 K (Java/Others)Total Submi ...
- ArduinoNano卡在上传,无法烧录
卡在“上传...”.过了很久被告知失败. 上午在开发版管理器中将Arduino AVR Boards从1.6.20升级到1.6.22,出现这个问题. 再安装回1.6.20,问题未被解决. 查阅资料无果 ...
- IIS7如何实现访问HTTP跳转到HTTPS访问 转的
加几句,1.安装url重写模块,不需要重启IIS,安装完了就能用.个人感觉比 IIS REWRITE组件更好用,iis rewrite是安装第三方的那种,不缴费只可以把所有规则写在一起,不能区别站点, ...
- java反射机制_读取properties
代码: import java.lang.reflect.InvocationTargetException; import java.lang.reflect.Method; /** * 反射特点: ...
- jenkins创建构建任务
构建项目类型 点击 Jenkins 首页 “创建一个新任务” 的链接, 输入任务名称 Jenkins 提供了六种类型的任务. 构建一个自由风格的软件项目 这是Jenkins的主要功能.Jenkins ...
- Types方法之isCastable-isConvertible
5. Conversions and Promotions 5.1. Kinds of Conversion 5.1.1. Identity Conversion 5.1.2. Widening Pr ...
- Python2.7环境下安装pydbg
From:http://blog.csdn.net/cheng_tian/article/details/7652058 最近在看<Python灰帽子:黑客与逆向工程师的Python编程之道&g ...
- python-Event事件处理进程同步
#!/usr/bin/python from multiprocessing import Process,Event import os,time def A(e): print "blo ...