
spark 在yarn模式下提交作业
1、spark在yarn模式下提交作业需要启动hdfs集群和yarn,具体操作参照:hadoop 完全分布式集群搭建
2、spark需要配置yarn和hadoop的参数目录
将spark/conf/目录下的spark-env.sh.template文件复制一份,加入配置:

YARN_CONF_DIR=/opt/hadoop/hadoop-2.8.3/etc/hadoop

HADOOP_CONF_DIR=/opt/hadoop/hadoop-2.8.3/etc/hadoop
3、将spark整个目录分发到hdfs集群中每台机器上,分发命令可以参考:linux rsync
如果不想用rsync也可以直接用scp -r拷贝,测试环境下差别不大。
4、提交作业测试
bin/spark-submit --class org.apache.spark.examples.SparkPi --master yarn --deploy-mode client ./examples/jars/spark-examples_2.11-2.4.4.jar 200
正常情况下很快就能计算完成:

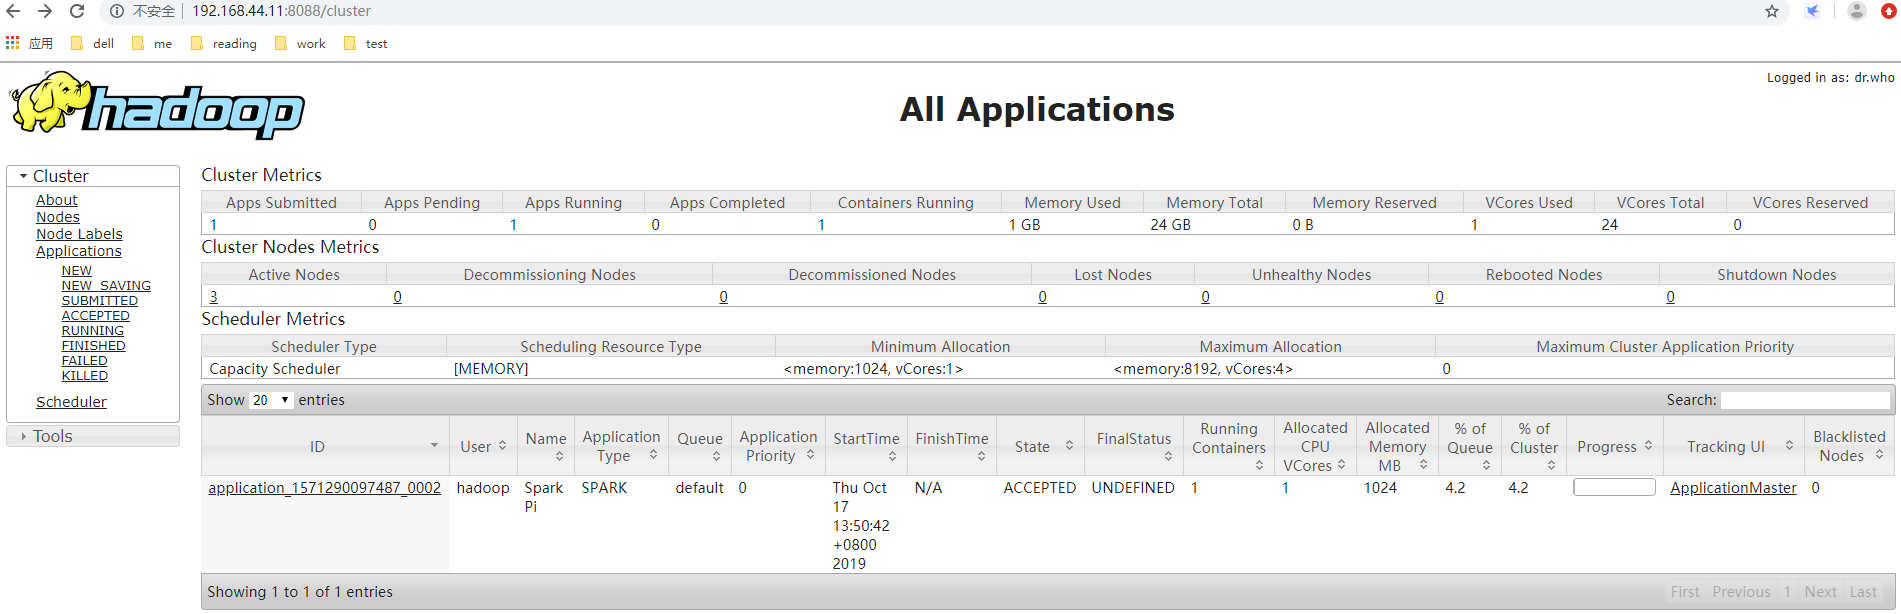
在yarn的UI可以监控到执行的作业:
5、spark参数优先级
Spark加载属性参数的优先顺序是:

 (1)直接在SparkConf设置的属性参数

 (2)通过 spark-submit 或 spark-shell 方式传递的属性参数

 (3)最后加载 spark-defaults.conf 配置文件的属性参数
如果在程序里指定了SparkConf的参数,则spark缺省参数以及命令行参数都将失效,如果想灵活一下,我们可以在SparkConf加载缺省配置(spark-defaults.conf),然后在命令方式下覆盖参数。
val conf: SparkConf = new SparkConf(true).setAppName("SparkWordCount")
master这个参数就可以指定local或者yarn等模式,但是name参数在命令指定是无效的,因为已经内置了。
bin/spark-submit --master yarn --name myWordCount --class com.home.spark.WordCount --executor-memory 512M ~/sparkWordCount.jar hdfs://vmhome10.com:9000/input
spark 在yarn模式下提交作业的更多相关文章
- spark on yarn模式下配置spark-sql访问hive元数据
spark on yarn模式下配置spark-sql访问hive元数据 目的:在spark on yarn模式下,执行spark-sql访问hive的元数据.并对比一下spark-sql 和hive ...
- spark on yarn模式下内存资源管理(笔记1)
问题:1. spark中yarn集群资源管理器,container资源容器与集群各节点node,spark应用(application),spark作业(job),阶段(stage),任务(task) ...
- spark on yarn模式下内存资源管理(笔记2)
1.spark 2.2内存占用计算公式 https://blog.csdn.net/lingbo229/article/details/80914283 2.spark on yarn内存分配** 本 ...
- Spark在StandAlone模式下提交任务,spark.rpc.message.maxSize太小而出错
1.错误信息org.apache.spark.SparkException: Job aborted due to stage failure:Serialized task 32:5 was 172 ...
- spark跑YARN模式或Client模式提交任务不成功(application state: ACCEPTED)
不多说,直接上干货! 问题详情 电脑8G,目前搭建3节点的spark集群,采用YARN模式. master分配2G,slave1分配1G,slave2分配1G.(在安装虚拟机时) export SPA ...
- spark跑YARN模式或Client模式提交任务不成功(application state: ACCEPTED)(转)
不多说,直接上干货! 问题详情 电脑8G,目前搭建3节点的spark集群,采用YARN模式. master分配2G,slave1分配1G,slave2分配1G.(在安装虚拟机时) export SPA ...
- flink on yarn模式下两种提交job方式
yarn集群搭建,参见hadoop 完全分布式集群搭建 通过yarn进行资源管理,flink的任务直接提交到hadoop集群 1.hadoop集群启动,yarn需要运行起来.确保配置HADOOP_HO ...
- Spark on YARN模式的安装(spark-1.6.1-bin-hadoop2.6.tgz + hadoop-2.6.0.tar.gz)(master、slave1和slave2)(博主推荐)
说白了 Spark on YARN模式的安装,它是非常的简单,只需要下载编译好Spark安装包,在一台带有Hadoop YARN客户端的的机器上运行即可. Spark on YARN简介与运行wor ...
- spark on yarn模式里需要有时手工释放linux内存
为什么要提出这个问题? spark跑YARN模式或Client模式提交任务不成功(application state: ACCEPTED) 然后执行 [spark@master spark--bin- ...
随机推荐
- 《少年的你》票房被刷爆?让我用python分析一波它好看在哪里!
最近少年的你刷爆票房,但是是真好看还是假好看,我们也不知道,所以让我们用python来分析一下~ 票房过12亿 两位主演粉丝加起来过亿 电影话题量过亿 豆瓣8.4分, 时光网8.4分, IMDB 7. ...
- git操作教程
首先就是创建码云(用户名不能是中文),然后新建一个项目(用户名/项目名都不能是中文). 一.在Windows上安装Git 1.从http://msysgit.github.io下载,然后按默认选项安装 ...
- OAuth2、OpenID Connect简介
当我们在登录一些网站的时候,需要第三方的登录.比如,现在我们要登录简书https://www.jianshu.com/sign_in,我们使用微博登录,点击下方的一个微博的小按钮,就会出现这么一个地址 ...
- vue-cli 引用elementUI打包后文件过大
解决方案:使用externals引用第三方资源,防止element资源被打包到自己项目中,(总共修改3个页面index.html.webpack.base.conf.js.main.js) 1.修改i ...
- Java反射01 : 概念、入门示例、用途及注意事项
1.Java反射定义 本文转载自:https://blog.csdn.net/hanchao5272/article/details/79360452 官方定义如下: Reflection enabl ...
- 微信小程序出现 text 设置行高 line-height 无效的问题
前言: 我在写程序过程中遇到过给text加line-height不生效的问题,但是也有生效的情况,如果不生效了就按下面的解决方法处理吧. 解决办法: 在text的外层嵌套一层view,然后给view设 ...
- Codeforces Round #588 (Div. 2)
传送门 A. Dawid and Bags of Candies 乱搞. Code #include <bits/stdc++.h> #define MP make_pair #defin ...
- 整理几个经常在H5移动端开发遇到的东西。
本篇主要是我个人的学习分享. 1.弹出数字键盘 <!-- 有“#” “*” 符号输入 --> <input type="tel"> <!-- 纯数字 ...
- 攻防世界Web_php_unserialize
本文借鉴 https://blog.csdn.net/qq_40884727/article/details/101162105 打开页面得到源码 <?php class Demo { priv ...
- 2019csp-s
11.17一切尘埃落定 回来之后一直“沉迷”文化课,不想去面对自己,更多的可能是不敢吧 晃晃悠悠一个星期过去了 其实信息学考完就知道成绩了,很垃圾,不想去想,所以沉迷解析几何无法自拔(但好像也做不对几 ...