
Python 爬取豆瓣TOP250实战
学习爬虫之路,必经的一个小项目就是爬取豆瓣的TOP250了,首先我们进入TOP250的界面看看。
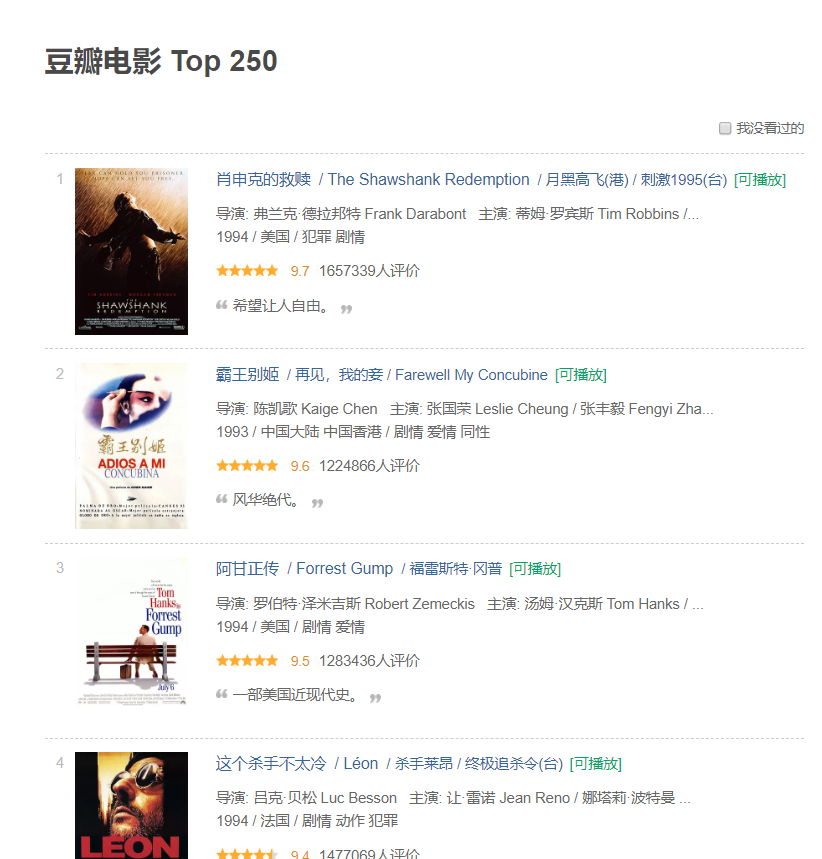
可以看到每部电影都有比较全面的简介。其中包括电影名、导演、评分等。
接下来,我们就爬取这些数据,并将这些数据制成EXCEL表格方便查看。
首先,我们用requests库请求一下该网页,并返回他的text格式。
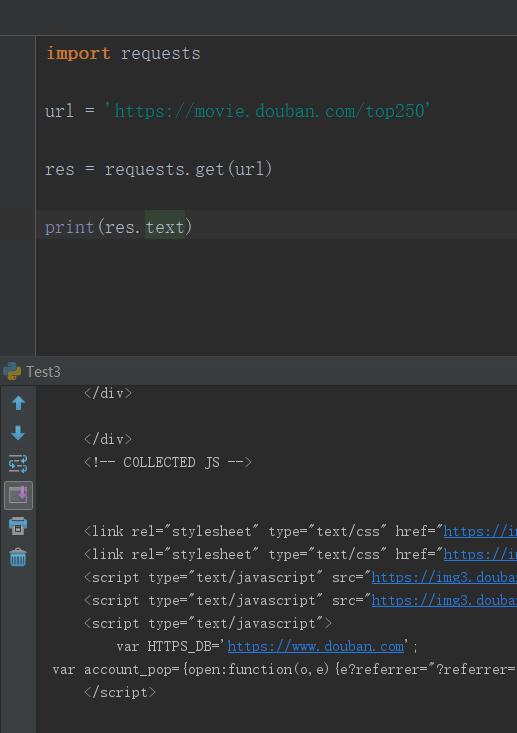
请求并返回成功!
接下来,我们提取我们所需要的网页元素。
点击“肖申克救赎”的检查元素。
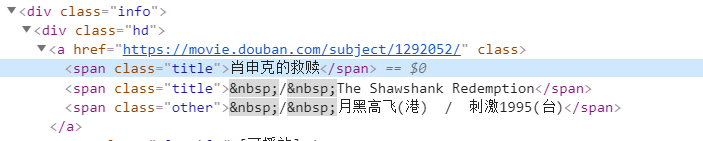
发现它在div class = "hd" -> span class = "title"里,所以我们import beautifulsoup,来定位该元素。
同时,用相同的方法定位电影的评价人数和评分以及短评。
代码如下:
soup = BeautifulSoup(res.text, 'html.parser')

    names = []

    scores = []

    comments = []

    result = []

    #获取电影的所有名字

    res_name = soup.find_all('div',class_="hd")

    for i in res_name:

        a=i.a.span.text

        names.append(a)

    #获取电影的评分

    res_scores = soup.find_all('span',class_='rating_num')

    for i in res_scores:

        a=i.get_text()

        scores.append(a)

    #获取电影的短评

    ol = soup.find('ol', class_='grid_view')

    for i in ol.find_all('li'):

        info = i.find('span', attrs={'class': 'inq'})  # 短评

        if info:

            comments.append(info.get_text())

        else:

            comments.append("无")

    return names,scores,comments
Ok,现在,我们所需要的数据都存在三个列表里面,names,scores,comments。
我们将这三个列表存入EXCEL文件里,方便查看。
调用WorkBook方法
wb = Workbook()

    filename = 'top250.xlsx'

    ws1 = wb.active

    ws1.title = 'TOP250'

    for (i, m, o) in zip(names,scores,comments):

        col_A = 'A%s' % (names.index(i) + 1)

        col_B = 'B%s' % (names.index(i) + 1)

        col_C = 'C%s' % (names.index(i) + 1)

        ws1[col_A] = i

        ws1[col_B] = m

        ws1[col_C] = o

    wb.save(filename=filename)
运行结束后,会生成一个.xlsx的文件,我们来看看效果:
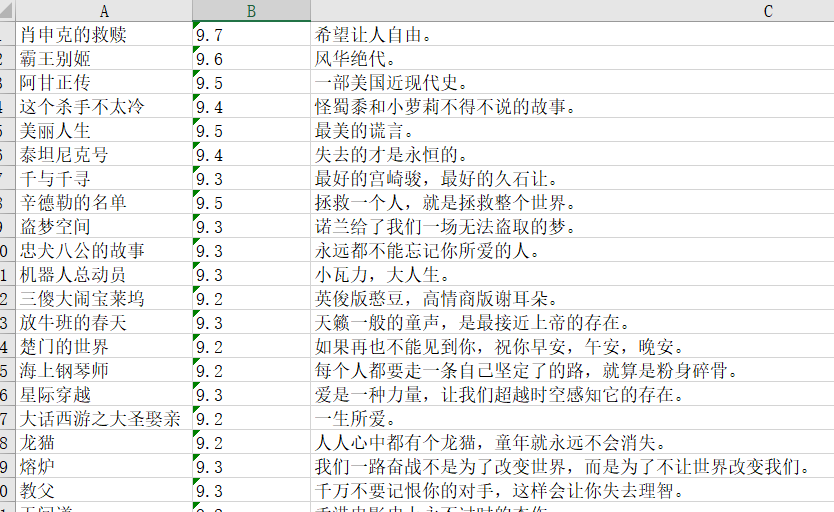
Very Beatuful! 以后想学习之余想放松一下看看好的电影,就可以在上面直接查找啦。
以下是我的源代码:
import requests

from bs4 import BeautifulSoup

from openpyxl import Workbook

def open_url(url):

    res = requests.get(url)

    return res

def get_movie(res):

    soup = BeautifulSoup(res.text, 'html.parser')

    names = []

    scores = []

    comments = []

    result = []

    #获取电影的所有名字

    res_name = soup.find_all('div',class_="hd")

    for i in res_name:

        a=i.a.span.text

        names.append(a)

    #获取电影的评分

    res_scores = soup.find_all('span',class_='rating_num')

    for i in res_scores:

        a=i.get_text()

        scores.append(a)

    #获取电影的短评

    ol = soup.find('ol', class_='grid_view')

    for i in ol.find_all('li'):

        info = i.find('span', attrs={'class': 'inq'})  # 短评

        if info:

            comments.append(info.get_text())

        else:

            comments.append("无")

    return names,scores,comments

def get_page(res):

    soup = BeautifulSoup(res.text,'html.parser')

     #获取页数

    page_num = soup.find('span',class_ ='next').previous_sibling.previous_sibling.text

    return int(page_num)

def main():

    host = 'https://movie.douban.com/top250'

    res = open_url(host)

    pages = get_page(res)

    #print(pages)

    names =[]

    scores = []

    comments = []

    for i in range(pages):

        url = host + '?start='+ str(25*i)+'&filter='

        #print(url)

        result = open_url(url)

        #print(result)

        a,b,c = get_movie(result)

        #print(a,b,c)

        names.extend(a)

        scores.extend(b)

        comments.extend(c)

    # print(names)

    # print(scores)

    # print(comments)

    wb = Workbook()

    filename = 'top250.xlsx'

    ws1 = wb.active

    ws1.title = 'TOP250'

    for (i, m, o) in zip(names,scores,comments):

        col_A = 'A%s' % (names.index(i) + 1)

        col_B = 'B%s' % (names.index(i) + 1)

        col_C = 'C%s' % (names.index(i) + 1)

        ws1[col_A] = i

        ws1[col_B] = m

        ws1[col_C] = o

    wb.save(filename=filename)

if __name__ == '__main__':

    main()
生成EXCEL文件还有很多种方法,下次分享Pandas生成EXCEL文件的方法~
Python 爬取豆瓣TOP250实战的更多相关文章
- python爬取豆瓣top250的电影数据并存入excle
爬取网址: https://movie.douban.com/top250 一:爬取思路(新手可以看一下) : 1:定义两个函数,一个get_page函数爬取数据,一个save函数保存数据,mian中 ...
- Python爬取豆瓣音乐存储MongoDB数据库(Python爬虫实战1)
1. 爬虫设计的技术 1)数据获取,通过http获取网站的数据,如urllib,urllib2,requests等模块: 2)数据提取,将web站点所获取的数据进行处理,获取所需要的数据,常使用的技 ...
- 零基础爬虫----python爬取豆瓣电影top250的信息(转)
今天利用xpath写了一个小爬虫,比较适合一些爬虫新手来学习.话不多说,开始今天的正题,我会利用一个案例来介绍下xpath如何对网页进行解析的,以及如何对信息进行提取的. python环境:pytho ...
- python爬取豆瓣电影Top250(附完整源代码)
初学爬虫,学习一下三方库的使用以及简单静态网页的分析.就跟着视频写了一个爬取豆瓣Top250排行榜的爬虫. 网页分析 我个人感觉写爬虫最重要的就是分析网页,找到网页的规律,找到自己需要内容所在的地方, ...
- Python爬取豆瓣电影top
Python爬取豆瓣电影top250 下面以四种方法去解析数据,前面三种以插件库来解析,第四种以正则表达式去解析. xpath pyquery beaufifulsoup re 爬取信息:名称 评分 ...
- Python爬取豆瓣指定书籍的短评
Python爬取豆瓣指定书籍的短评 #!/usr/bin/python # coding=utf-8 import re import sys import time import random im ...
- 利用Python爬取豆瓣电影
目标:使用Python爬取豆瓣电影并保存MongoDB数据库中 我们先来看一下通过浏览器的方式来筛选某些特定的电影: 我们把URL来复制出来分析分析: https://movie.douban.com ...
- 基础爬虫,谁学谁会,用requests、正则表达式爬取豆瓣Top250电影数据!
爬取豆瓣Top250电影的评分.海报.影评等数据! 本项目是爬虫中最基础的,最简单的一例: 后面会有利用爬虫框架来完成更高级.自动化的爬虫程序. 此项目过程是运用requests请求库来获取h ...
- Python爬取豆瓣《复仇者联盟3》评论并生成乖萌的格鲁特
代码地址如下:http://www.demodashi.com/demo/13257.html 1. 需求说明 本项目基于Python爬虫,爬取豆瓣电影上关于复仇者联盟3的所有影评,并保存至本地文件. ...
随机推荐
- Session和Cookie的用法及区别
1. Session.Cookie是什么 1.1 概念理解 要了解session和cookie是什么,先要了解以下几个概念. 1.1.1 无状态的HTTP协议 协议:是指计算机通信网络中两台计算机之间 ...
- linux中必备常用支持库的安装(CentOS)
在CentOS安装软件的时候,可能缺少一部分支持库,而报错.这里首先安装系统常用的支持库.那么在安装的时候就会减少很多的错误的出现 yum install -y gcc gdb strace gcc- ...
- BASLER Pylon 抓取策略
BASLER Pylon 抓取策略 ( 涛哥工业技术 微信号 TaoRobotics) One by One Grab Strategy 逐个抓取策略 当使用 one by one 抓取模式时,图像按 ...
- Spring boot 梳理 - SpringBoot中注入ApplicationContext对象的三种方式
直接注入(Autowired) @Configuration public class OAConfig { @Autowired private ApplicationContext applica ...
- Flask基础(16)-->WTForms表单创建和简单验证
Flask基础(16)-->WTForms表单创建和简单验证 前言:使用Flask_WTF需要配置参数SECRET_KEYCSRF_ENABLED是为了CSRF(跨站请求伪造)保护.SECRET ...
- Kubernetes 系列(四):使用Traefik访问.net core api
一. 准备 本篇的要求是在前三篇的基础上已经搭建好的本地k8s以及部署了Traefik,我们将会使用Traefik Ingress来访问.net core api,比较简单,做个记录,如果还没有搭建k ...
- cat命令显示文件指定行
cat filename | tail -n 100 显示文件最后100行 cat filename | head -n 100 显示文件前面100行 cat filename | tail -n + ...
- 解决thinkphp批量上传图片只有一张上传成功解决方案
批量上传时 存在一个生成文件名的问题 如果出现此bug,则不要用原生的生成规则来命名图片文件名 如果你试试同时上传两个不同类型,例如一张jpg,一张png,你就发现的确是可以两张同时上传的! 方案1: ...
- SpringBoot系列:Spring Boot使用模板引擎FreeMarker
一.Java模板引擎 模板引擎(这里特指用于Web开发的模板引擎)是为了使用户界面与业务数据(内容)分离而产生的,它可以生成特定格式的文档,用于网站的模板引擎就会生成一个标准的HTML文档. 在jav ...
- php企业微信获取员工userid以及打卡信息
企业微信可以通过部门列表获取部门下的员工信息,从而获取到员工的userid //首先获取需要的access_token $access_token = json_decode($this->ge ...