
【python】利用jieba中文分词进行词频统计
以下代码对鲁迅的《祝福》进行了词频统计:
 import io

 import jieba

 txt = io.open("zhufu.txt", "r", encoding='utf-8').read()

 words  = jieba.lcut(txt)

 counts = {}

 for word in words:

     if len(word) == 1:

         continue

     else:

         counts[word] = counts.get(word,0) + 1

 items = list(counts.items())

 items.sort(key=lambda x:x[1], reverse=True)

 for i in range(15):

     word, count = items[i]

     print (u"{0:<10}{1:>5}".format(word, count))
结果如下:
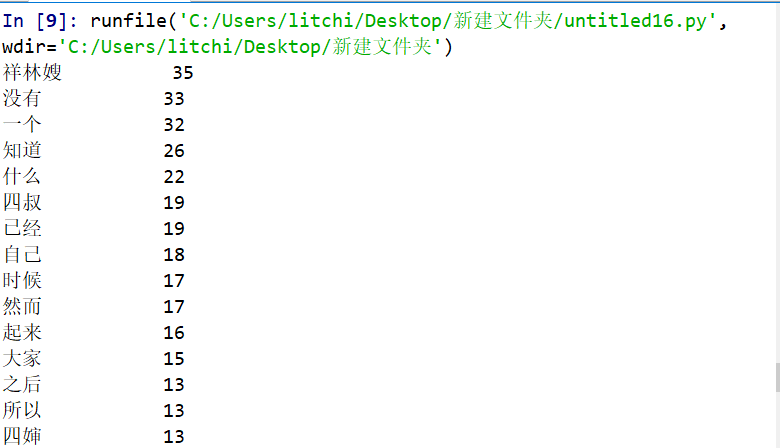
并把它生成词云
 from wordcloud import WordCloud

 import PIL.Image as image

 import numpy as np

 import jieba

 # 分词

 def trans_CN(text):

     # 接收分词的字符串

     word_list = jieba.cut(text)

     # 分词后在单独个体之间加上空格

     result = " ".join(word_list)

     return result

 with open("zhufu.txt") as fp:

     text = fp.read()

     # print(text)

     # 将读取的中文文档进行分词

     text = trans_CN(text)

     mask = np.array(image.open("xinxing.jpg"))

     wordcloud = WordCloud(

         # 添加遮罩层

         mask=mask,

         font_path = "msyh.ttc"

     ).generate(text)

     image_produce = wordcloud.to_image()

     image_produce.show()
效果如下:

【python】利用jieba中文分词进行词频统计的更多相关文章
- Python大数据:jieba 中文分词,词频统计
# -*- coding: UTF-8 -*- import sys import numpy as np import pandas as pd import jieba import jieba. ...
- Hadoop上的中文分词与词频统计实践 (有待学习 http://www.cnblogs.com/jiejue/archive/2012/12/16/2820788.html)
解决问题的方案 Hadoop上的中文分词与词频统计实践 首先来推荐相关材料:http://xiaoxia.org/2011/12/18/map-reduce-program-of-rmm-word-c ...
- python安装Jieba中文分词组件并测试
python安装Jieba中文分词组件 1.下载http://pypi.python.org/pypi/jieba/ 2.解压到解压到python目录下: 3.“win+R”进入cmd:依次输入如下代 ...
- python库--jieba(中文分词)
import jieba 精确模式,试图将句子最精确地切开,适合文本分析:全模式,把句子中所有的可以成词的词语都扫描出来, 速度非常快,但是不能解决歧义:搜索引擎模式,在精确模式的基础上,对长词再次切 ...
- 【python】一篇文章里的词频统计
一.环境 1.python3.6 2.windows系统 3.安装第三方模块 pip install wordcloud #词云展示库 pip install jieba #结巴分词 pip inst ...
- jieba中文分词
jieba中文分词¶ 中文与拉丁语言不同,不是以空格分开每个有意义的词,在我们处理自然语言处理的时候,大部分情况下,词汇是对句子和文章的理解基础.因此需要一个工具去把完整的中文分解成词. ji ...
- python利用jieba进行中文分词去停用词
中文分词(Chinese Word Segmentation) 指的是将一个汉字序列切分成一个一个单独的词. 分词模块jieba,它是python比较好用的分词模块.待分词的字符串可以是 unicod ...
- jieba中文分词(python)
问题小结 1.安装 需要用到python,根据python2.7选择适当的安装包.先下载http://pypi.python.org/pypi/jieba/ ,解压后运行python setup.py ...
- Python分词模块推荐:jieba中文分词
一.结巴中文分词采用的算法 基于Trie树结构实现高效的词图扫描,生成句子中汉字所有可能成词情况所构成的有向无环图(DAG)采用了动态规划查找最大概率路径, 找出基于词频的最大切分组合对于未登录词,采 ...
随机推荐
- CentOS7使用tar.gz方法安装php7.2.8
软件:VMware 系统版本:CentOS7 1.检查系统里是否有安装的PHP包,如果有的话先删除 [root@localhost ~]# yum list installed | grep php ...
- Python习题集(十三)
每天一习题,提升Python不是问题!!有更简洁的写法请评论告知我! https://www.cnblogs.com/poloyy/category/1676599.html 题目 写一个函数,该函数 ...
- BigDecimal介绍及BigDecimal实现四舍五入
BigDecimal介绍及BigDecimal实现四舍五入 BigDecimal是什么? 我们知道float最大精度是7-8位有效数字,而double的最大精度是16-17位有效数字,那么大于16位的 ...
- 《Python学习手册 第五版》 -第18章 参数
在函数的定义和调用中,参数是使用最多喝最频繁的,本章内容就是围绕函数的参数进行讲解 本章重点内容如下: 1.参数的传递 1)不可变得参数传递 2)可变得参数传递 2.参数的匹配模式 1)位置次序:从左 ...
- [Visual Basic]冒泡排序及优化
冒泡排序 注意点 越界问题:i的边界是n-1,也就是说是对总共的第1~n个数进行排列(最后一个数处于被比较状态,不需要额外主动比较):j的初始值或最终值与当前i的值 有关题目中往往会改变i的值来考察, ...
- .NetCore 3.1 MVC 发布Linux实操
记录自己.net Core的学习,现在来发布到Linux系统 第一步:准备一台CentOS 7 X64服务器 .net core 3.1项目 第二步:准备服务器.net core环境 1.安装微软官方 ...
- FFmpeg SDK for iOS
FFmpeg是一套可以用来记录.转换数字音频.视频,并能将其转化为流的跨平台开源计算机程序. 很多平台视频播放器都是使用FFmpeg来开发的,FFmpeg官方并没有为各个平台提供编译好的SDK,所以使 ...
- Shell 截取字符串方法
原文链接 方法1 "${varible##*string}" 从左向右截取最后一个string后的字符串 e.g. exampleString="abc//888//ab ...
- Java流中的map算子和flatMap算子的区别
map算子和flatMap算子 map和flatMap都是映射(转换),那么他们之间究竟有什么区别呢? 1.我们先简单了解下map算子: @org.junit.Test public void tes ...
- selenium 使用教程详解-java版本
第一章 Selenium 概述 1.1.Selenium 发展史 Selenium是一系列基于Web的自动化工具,提供一套测试函数,用于支持Web自动化测试.函数非常灵活,能够完成界面元素定位.窗 ...