
python爬虫-vmgirls-正则表达式
概述
本次爬虫任务是爬取图片网站图片,网址是https://www.vmgirls.com/
分析网页
第一步,打开需要爬取的页面https://www.vmgirls.com/13344.html
打开F12,随便选择一张图片查看图片,操作如下
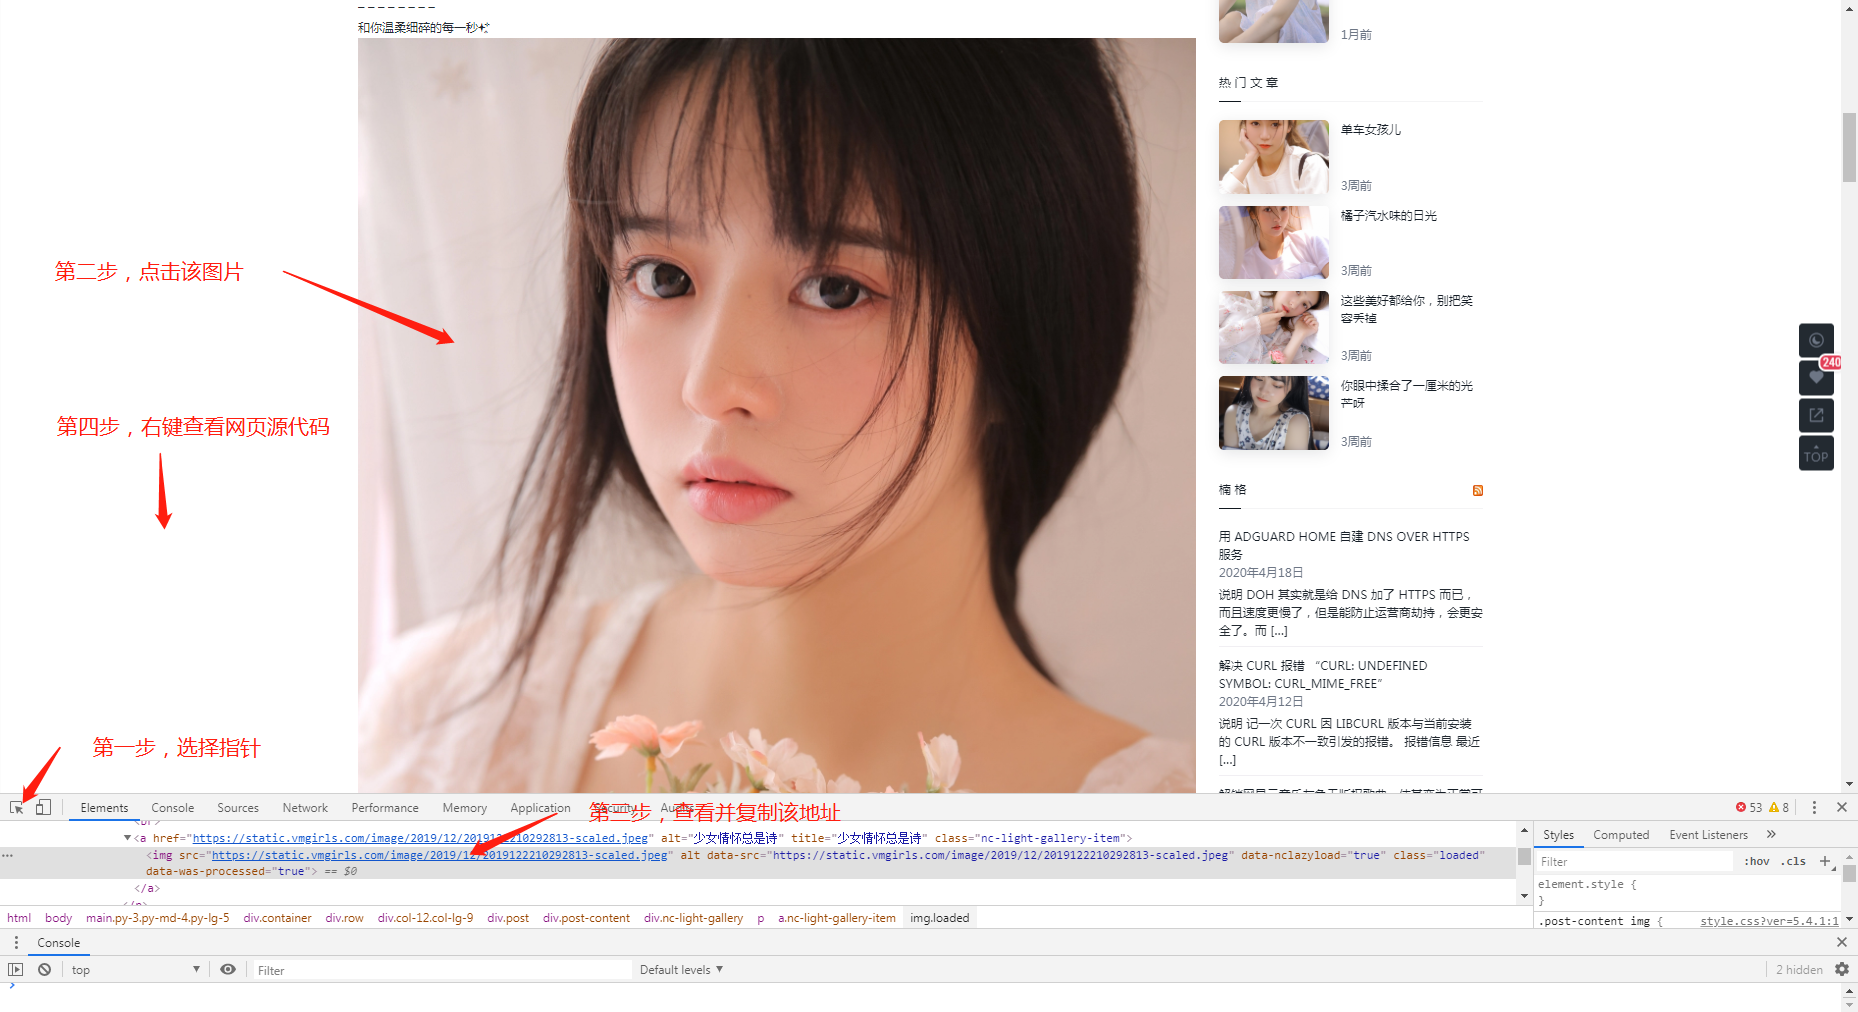
第二步,寻找所需下载图片的地址,并分析最优的方式
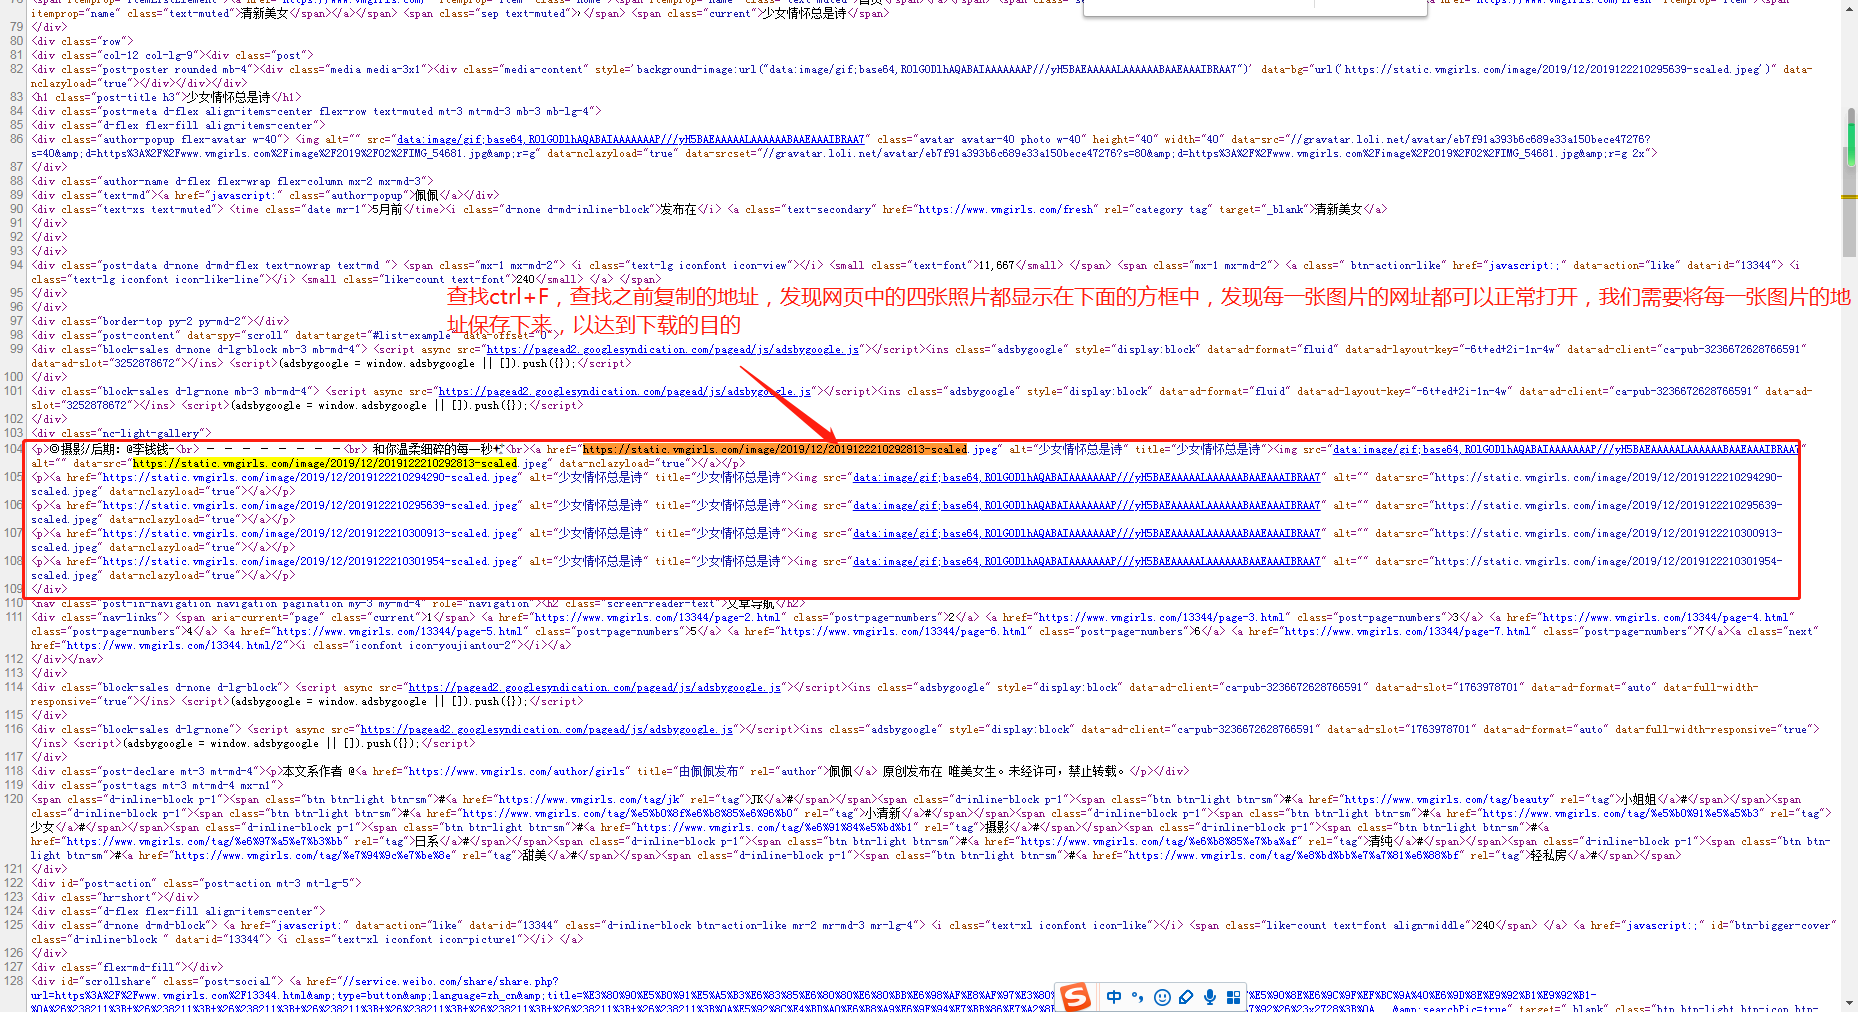
第三步,得出结论,可以通过获取每张图片的url地址,进行保存图片的动作
代码操作
请求网页
第一步,我们请求网页并打印网页返回的请求
import requests

'''请求网页'''

response = requests.get('https://www.vmgirls.com/13344.html', headers=headers)#请求网址并得到一个回复

print(response.text)
发现出现403 Forbidden,我们需要寻找原因
# <html>

# <head><title>403 Forbidden</title></head>

# <body>

# <center><h1>403 Forbidden</h1></center>

# <hr><center>Her</center>

# </body>

# </html>
我们插入一个代码
print(response.request.headers)
发现问题所在,网页返回的信息中表示,我们发送的请求来源于一个爬虫程序,所以我们需要伪装一个header,
# {'User-Agent': 'python-requests/2.23.0',

# 'Accept-Encoding': 'gzip, deflate',

# 'Accept': '*/*',

# 'Connection': 'keep-alive'}
怎么做,打开浏览器,指定网页,F12查看浏览器发送的headers
复制heades到代码中
import requests

'''请求网页'''

headers = {

    'user-agent': 'Mozilla/5.0 (Windows NT 6.1; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/80.0.3987.163 Safari/537.36'

}

response = requests.get('https://www.vmgirls.com/13344.html', headers=headers)#请求网址并得到一个回复

print(response.text)

print(response.request.headers)
能够正常得到网页返回的信息了
解析网页
解析网页本次使用正则表达式
导入re库
import re

urls = re.findall('<a href="(.*?)" alt=".*?" title=".*?">', html)

print(urls)
得到5个图片的url链接
['https://static.vmgirls.com/image/2019/12/2019122210292813-scaled.jpeg',
'https://static.vmgirls.com/image/2019/12/2019122210294290-scaled.jpeg',
'https://static.vmgirls.com/image/2019/12/2019122210295639-scaled.jpeg',
'https://static.vmgirls.com/image/2019/12/2019122210300913-scaled.jpeg',
'https://static.vmgirls.com/image/2019/12/2019122210301954-scaled.jpeg']
保存图片
将所有的图片保存为文件格式
for url in urls:

    response = requests.get(url, headers=headers)

    # 将url中后面的数字字段截取出来作为图片的文件名

    file_name = url.split('/')[-1]

    # 以二进制格式打开一个文件只用于写入。如果该文件已存在则将其覆盖。如果该文件不存在,创建新文件。

    with open(file_name,'wb') as f:

    # 文件写入每一个response返回的内容,最终保存的即为图片,图片地址在该py文件相同目录

        f.write(response.content)
此时需要考虑到两个问题
1.访问频次
2.文件应该需要保存在但个文件夹中,问不是散乱的存放
修改代码如下
import os
# 获得文件夹名

dir_name = re.findall('<h1 class="post-title h3">(.*?)</h1>', html)[-1]

# 判断文件夹是否存在,并创建文件夹

if not  os.path.exists(dir_name):

    os.makedirs(dir_name)

# 遍历所有的url,将所有的url单独保存

for url in urls:

    # 放置访问频次太高,设置访问频率,需要导入time模块

    time.sleep(1)

    response = requests.get(url, headers=headers)

    # 将url中后面的数字字段截取出来作为图片的文件名

    file_name = url.split('/')[-1]

    # 以二进制格式打开一个文件只用于写入。如果该文件已存在则将其覆盖。如果该文件不存在,创建新文件。

    # 由于加入了文件夹的步骤,所以with open(file_path,wb)as f中file_path需要带上文件夹

    # with open(file_name,'wb') as f:

    with open(dir_name+'/'+file_name, 'wb') as f:

        # 文件写入每一个response返回的内容,最终保存的即为图片,图片地址在该py文件相同目录

        f.write(response.content)

# 由于这种方式文件是一个个单独的存放在目录下面,并没有较好的分类,我们需要加入一个分类的步骤

# 根据网页中的名称设置文件夹名为dir_name = re.findall('<h1 class="post-title h3">(.*?)</h1>')[-1]

# 若想创建文件夹,需要导入os库

# 判断文件夹是否存在
任务完成
完整代码
import requests

import re

import time

import os

'''请求网页'''

headers = {

    'user-agent': 'Mozilla/5.0 (Windows NT 6.1; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/80.0.3987.163 Safari/537.36'

}

response = requests.get('https://www.vmgirls.com/13344.html', headers=headers)#请求网址并得到一个回复

html = response.text

"""

print(response.text)

# <html>

# <head><title>403 Forbidden</title></head>

# <body>

# <center><h1>403 Forbidden</h1></center>

# <hr><center>Her</center>

# </body>

# </html>

# 发现了403 Forbidden,也就是这个系统设置了反爬虫,所以需要改变

# 我们查看一下返回的headers,也就是请求的头信息

print(response.request.headers)

# {'User-Agent': 'python-requests/2.23.0',

# 'Accept-Encoding': 'gzip, deflate',

# 'Accept': '*/*',

# 'Connection': 'keep-alive'}

# 发现这是用python端请求,理所当然的被网页拒绝了,所以我们需要一个伪装的headers,伪装成浏览器发送的请求

# 怎么做,打开浏览器,指定网页,F12查看浏览器发送的headers

# {user-agent: Mozilla/5.0 (Windows NT 6.1; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/80.0.3987.163 Safari/537.36}

# 制作伪装的headers

# headers = {'user-agent: Mozilla/5.0 (Windows NT 6.1; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/80.0.3987.163 Safari/537.36'}

# 注意headers是一个字典,不是字符串,所以格式为"user-agent":"头部具体信息"

# 将headers放置到网页请求的前面,即response前

# 同时response里面带上headers

# 程序运行之后发现可以正常运行

"""

'''解析网页'''

# 解析网页本次使用正则表达式

# 导入re库

# 获得文件夹名

dir_name = re.findall('<h1 class="post-title h3">(.*?)</h1>', html)[-1]

# 判断文件夹是否存在,并创建文件夹

if not  os.path.exists(dir_name):

    os.makedirs(dir_name)

# 获得所有图片的url链接

urls = re.findall('<a href="(.*?)" alt=".*?" title=".*?">', html)

print(urls)

"""保存图片"""

# 遍历所有的url,将所有的url单独保存

for url in urls:

    # 放置访问频次太高,设置访问频率,需要导入time模块

    time.sleep(1)

    response = requests.get(url, headers=headers)

    # 将url中后面的数字字段截取出来作为图片的文件名

    file_name = url.split('/')[-1]

    # 以二进制格式打开一个文件只用于写入。如果该文件已存在则将其覆盖。如果该文件不存在,创建新文件。

    # 由于加入了文件夹的步骤,所以with open(file_path,wb)as f中file_path需要带上文件夹

    # with open(file_name,'wb') as f:

    with open(dir_name+'/'+file_name, 'wb') as f:

        # 文件写入每一个response返回的内容,最终保存的即为图片,图片地址在该py文件相同目录

        f.write(response.content)

# 由于这种方式文件是一个个单独的存放在目录下面,并没有较好的分类,我们需要加入一个分类的步骤

# 根据网页中的名称设置文件夹名为dir_name = re.findall('<h1 class="post-title h3">(.*?)</h1>')[-1]

# 若想创建文件夹,需要导入os库

# 判断文件夹是否存在
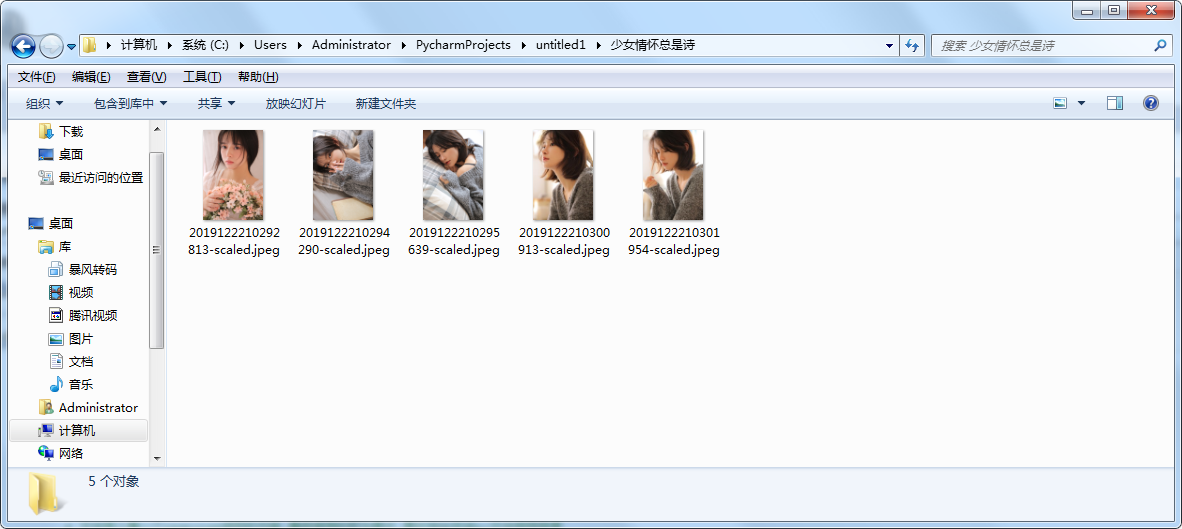
图片结果
python爬虫-vmgirls-正则表达式的更多相关文章
- 玩转python爬虫之正则表达式
玩转python爬虫之正则表达式 这篇文章主要介绍了python爬虫的正则表达式,正则表达式在Python爬虫是必不可少的神兵利器,本文整理了Python中的正则表达式的相关内容,感兴趣的小伙伴们可以 ...
- 【Python爬虫】正则表达式与re模块
正则表达式与re模块 阅读目录 在线正则表达式测试 常见匹配模式 re.match re.search re.findall re.compile 实战练习 在线正则表达式测试 http://tool ...
- python 爬虫之-- 正则表达式
正则表达式是一个特殊的字符序列,它能帮助你方便的检查一个字符串是否与某种模式匹配. 正则表达式非python独有,python 提供了正则表达式的接口,re模块 一.正则匹配字符简介 模式 描述 \d ...
- python爬虫训练——正则表达式+BeautifulSoup爬图片
这次练习爬 传送门 这贴吧里的美食图片. 如果通过img标签和class属性的话,用BeautifulSoup能很简单的解决,但是这次用一下正则表达式,我这也是参考了该博主的博文:传送门 所有图片的s ...
- 【python爬虫和正则表达式】爬取表格中的的二级链接
开始进公司实习的一个任务是整理一个网页页面上二级链接的内容整理到EXCEL中,这项工作把我头都搞大了,整理了好几天,实习生就是端茶送水的.前段时间学了爬虫,于是我想能不能用python写一个爬虫一个个 ...
- Python爬虫运用正则表达式
我看到最近几部电影很火,查了一下猫眼电影上的数据,发现还有个榜单,里面有各种经典和热映电影的排行榜,然后我觉得电影封面图还挺好看的,想着一张一张下载真是费时费力,于是突发奇想,好像可以用一下最近学的东 ...
- Python爬虫之正则表达式(3)
# re.sub # 替换字符串中每一个匹配的子串后返回替换后的字符串 import re content = 'Extra strings Hello 1234567 World_This is a ...
- Python爬虫之正则表达式(1)
廖雪峰正则表达式学习笔记 1:用\d可以匹配一个数字:用\w可以匹配一个字母或数字: '00\d' 可以匹配‘007’,但是无法匹配‘00A’; ‘\d\d\d’可以匹配‘010’: ‘\w\w\d’ ...
- python爬虫之正则表达式
一.简介 正则表达式,又称正规表示式.正规表示法.正规表达式.规则表达式.常规表示法(英语:Regular Expression,在代码中常简写为regex.regexp或RE),计算机科学的一个概念 ...
- Python爬虫基础——正则表达式
说到爬虫,不可避免的会牵涉到正则表达式. 因为你需要清晰地知道你需要爬取什么信息?它们有什么共同点?可以怎么去表示它们? 而这些,都需要我们熟悉正则表达,才能更好地去提取. 先简单复习一下各表达式所代 ...
随机推荐
- 【山外笔记-云原生】《Docker+Kubernetes应用开发与快速上云》读书笔记-2020.04.25(六)
书名:Docker+Kubernetes应用开发与快速上云 作者:李文强 出版社:机械工业出版社 出版时间:2020-01 ISBN:9787111643012 [山外笔记-云原生]<Docke ...
- 理解java容器底层原理--手动实现HashSet
HashSet的底层其实就是HashMap,换句话说HashSet就是简化版的HashMap. 直接上代码: package com.xzlf.collection2; import java.uti ...
- vnpy源码阅读学习(9)回到OptionMaster
回到OptionMaster 根据我们对APP调用的代码阅读,我们基本上知道了一个APP是如何被调用,那么我们回到OptionMaster学习下这个APP的实现. 看看结构 class OptionM ...
- C语言指定初始化器解析及其应用
指定初始化器的概念 C90 标准要求初始化程序中的元素以固定的顺序出现,与要初始化的数组或结构体中的元素顺序相同.但是在新标准 C99 中,增加了一个新的特性:指定初始化器.利用该特性可以初始化指定的 ...
- C# 基础知识系列- 14 IO篇之入门IO
0. 前言 在之前的章节中,大致介绍了C#中的一些基本概念.这篇我们将介绍一下C#的I/O操作,这将也是一个小连续剧.这是第一集,我们先来简单了解一下C#中的I/O框架. 1. 什么是I/O I/O ...
- php phpStudy session存放位置
如果你仅仅是想知道session保存的文件在哪里,你可以在你的PHP文件当中运行函数:session_save_path之后查看运行结果即可知道session文件的存放目录. 或者: 在php-ini ...
- 终止过久没有返回的 Windows API 函数 ---- “CancelSynchronousIo”
Marks pending synchronous I/O operations that are issued by the specified thread as canceled. BOOL W ...
- web 之 tomcat 8.5 和9.0如何进入manager?
tomcat 8.5 和9.0如何进入manager? 第一步找到tomcat-user.xml文件 第二步添加如下代码 <role rolename="manager-gui&quo ...
- usermod,用户密码管理,mkpasswd命令
passwd是更改用户密码的文件,如果在root下,我们可以直接输入这个命令更改密码[root@localhost ~]# passwd更改用户 root 的密码 .新的 密码:如果想更改其他用户的密 ...
- 图论--差分约束--POJ 3169 Layout(超级源汇建图)
Like everyone else, cows like to stand close to their friends when queuing for feed. FJ has N (2 < ...