
python爬虫训练——正则表达式+BeautifulSoup爬图片
这次练习爬 传送门 这贴吧里的美食图片。
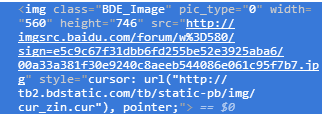
如果通过img标签和class属性的话,用BeautifulSoup能很简单的解决,但是这次用一下正则表达式,我这也是参考了该博主的博文:传送门
所有图片的src地址前面都是相同的,所以根据这个就可以筛选出我们想要的图片了。也就是在匹配时不用class属性的值,而是用正则表达式去匹配src的值。
 from urllib import request

 from bs4 import BeautifulSoup

 import re

 def get_page(url, tot_page):

     url_list = []

     for i in range(1,tot_page):

         new_url = re.sub(('=(.*)'),'%s%s' %('=',i), url)

         url_list.append(new_url)

     return url_list

 if __name__ == '__main__':

     url = 'http://tieba.baidu.com/p/4792769205?pn=1'

     path = 'D:\python\project\爬虫结果'

     count = 0

     url_list = get_page(url, 4)

     for url in url_list:

         print(url)

         page = request.urlopen(url).read().decode()

         soup = BeautifulSoup(page, 'lxml')

         regex = re.compile("http://imgsrc.baidu.com/forum/w%3D580/sign=.+\.jpg")

         pic_list = soup.findAll('img', {'src': regex})

         for pic in pic_list:

             pic = pic['src']

             request.urlretrieve(pic, '%s/%s.jpg' % (path, count))

             count += 1
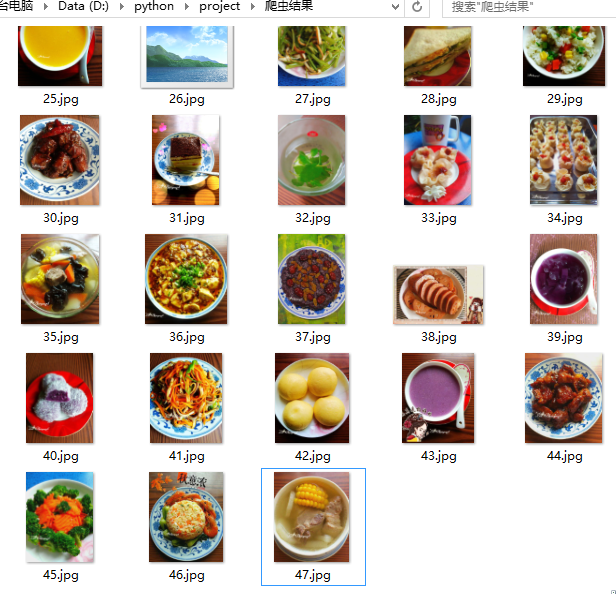
我就爬了3页的图片:
python爬虫训练——正则表达式+BeautifulSoup爬图片的更多相关文章
- 【python爬虫和正则表达式】爬取表格中的的二级链接
开始进公司实习的一个任务是整理一个网页页面上二级链接的内容整理到EXCEL中,这项工作把我头都搞大了,整理了好几天,实习生就是端茶送水的.前段时间学了爬虫,于是我想能不能用python写一个爬虫一个个 ...
- Python爬虫之利用BeautifulSoup爬取豆瓣小说(一)——设置代理IP
自己写了一个爬虫爬取豆瓣小说,后来为了应对请求不到数据,增加了请求的头部信息headers,为了应对豆瓣服务器的反爬虫机制:防止请求频率过快而造成“403 forbidden”,乃至封禁本机ip的情况 ...
- python爬虫:利用BeautifulSoup爬取链家深圳二手房首页的详细信息
1.问题描述: 爬取链家深圳二手房的详细信息,并将爬取的数据存储到Excel表 2.思路分析: 发送请求--获取数据--解析数据--存储数据 1.目标网址:https://sz.lianjia.com ...
- python爬虫-80电子书,爬图片
''' 作者:Caric_lee 日期:2018 查看图片 ''' import requests from bs4 import BeautifulSoup r = requests.get(&qu ...
- Python爬虫之利用BeautifulSoup爬取豆瓣小说(三)——将小说信息写入文件
#-*-coding:utf-8-*- import urllib2 from bs4 import BeautifulSoup class dbxs: def __init__(self): sel ...
- Python爬虫之利用BeautifulSoup爬取豆瓣小说(二)——回车分段打印小说信息
在上一篇文章中,我主要是设置了代理IP,虽然得到了相关的信息,但是打印出来的信息量有点多,要知道每打印一页,15个小说的信息全部会显示而过,有时因为屏幕太小,无法显示全所有的小说信息,那么,在这篇文章 ...
- PYTHON 爬虫笔记九:利用Ajax+正则表达式+BeautifulSoup爬取今日头条街拍图集(实战项目二)
利用Ajax+正则表达式+BeautifulSoup爬取今日头条街拍图集 目标站点分析 今日头条这类的网站制作,从数据形式,CSS样式都是通过数据接口的样式来决定的,所以它的抓取方法和其他网页的抓取方 ...
- Python爬虫实战二之爬取百度贴吧帖子
大家好,上次我们实验了爬取了糗事百科的段子,那么这次我们来尝试一下爬取百度贴吧的帖子.与上一篇不同的是,这次我们需要用到文件的相关操作. 前言 亲爱的们,教程比较旧了,百度贴吧页面可能改版,可能代码不 ...
- Python爬虫实战一之爬取糗事百科段子
大家好,前面入门已经说了那么多基础知识了,下面我们做几个实战项目来挑战一下吧.那么这次为大家带来,Python爬取糗事百科的小段子的例子. 首先,糗事百科大家都听说过吧?糗友们发的搞笑的段子一抓一大把 ...
随机推荐
- numpy文件操作
import numpy as np print '读取csv文件做为数组' arr = np.loadtxt('array_ex.txt', delimiter = ',') print arr i ...
- mybatis源码解析4---Configuration解析
Configuration类解析 Configuration类位于mybatis包的org.apache.ibatis.session目录下,是mybatis的全局变量,属性就是对应于mybatis的 ...
- python 网页cookie的使用
网页cookie的使用 Cookie,指某些网站为了辨别用户身份.进行session跟踪而储存在用户本地终端上的数据(通常经过加密) # opener的概念当你获取一个URL你使用一个opener(一 ...
- 通过junit/TestNG+java 实现自动化测试
第一步 安装JDK JDk1.7. 下载地址:http://www.oracle.com/technetwork/java/javase/downloads/jdk7-downloads-188026 ...
- 直播协议的选择:RTMP vs. HLS
文章转自:直播协议的选择:RTMP vs. HLS 前言 随着直播业务的兴起,越来越多的直播平台开始涌现,这火热的程度好像一个应用不带上直播业务出来都不好意思跟人打招呼.想要做一个直播业务,主要包括三 ...
- mysql03
查询的列不在同一表中必须使用连接内连接,外链接 -- 输出学生姓名以及对应的年级名称 内连接 select studentName,gradeName from student inner join ...
- jQuery获取子元素个数的方法
//获取id=div1下的子元素的个数 $('#id').children().length; //获取id=div1下的p元素个数 $('#id').children('p').length;
- springmvc的ajax返回406问题
在springmvc中ajax请求写为XXX.html,如果在controller的如:@RequestMapping(value="/login/doLogin.html",pr ...
- django 分页函数
实现类似: 上一页 1 ... 4 5 7 8 ... 89 下一页 的效果 def pageGenerate(fullList,pagenum,urltype,type,currpage): pag ...
- Docker学习笔记之Docker的Build 原理
0x00 概述 使用 Docker 时,最常用的命令无非是 docker container 和 docker image 相关的子命令,当然最初没有管理类命令(或者说分组)的时候,最常使用的命令也无 ...