
python3下scrapy爬虫(第一卷:安装问题)
一般爬虫都是用urllib包,requests包 配合正则.beautifulsoup等包混合使用,达到爬虫效果,不过有框架谁还用原生啊,现在我们来谈谈SCRAPY框架爬虫,
现在python3的兼容性上来了,SCRAPY不光支持python2版本了,有新的不用旧的,现在说一下让很多人望而止步的安装问题,很多人开始都安装不明白,
当前使用的版本是PYTHON3.5,安装时用PIP3
安装步骤:
1 安装wheel
pip3 install wheel
2 安装twisted
pip3 install Twisted-17.9.0-cp35-cp35m-win_amd64.whl
3 安装lxml
pip3 install lxml-4.1.1-cp35-cp35m-win_amd64.whl
4 安装scrapy
pip3 install scrapy
这样你就成功的安装上了scrapy,你可以创建文件,但是你任然不可爬虫,一旦执行爬虫文件就会报错
5 安装pywin32

一路下一步就行
接着我们创建scrapy文件夹
进入运行环境为python3.5的文件路径,如果你的电脑同时安装2,3版本一定要注意问题。两个版本会出现环境冲突问题,一旦python3版本下的scrapy运行在python2下就会出现版本不兼容问题,就会出现NO MOUDLE的报错
路径切换到python3运行的环境:
scrapy startproject filename
终端进入filename目录
scrapy genspider -t basic crawl1 webname.com
就会创建爬虫脚本文件
文件夹里几个文件我也就不介绍了,
我说下基本爬虫setting.py的应用
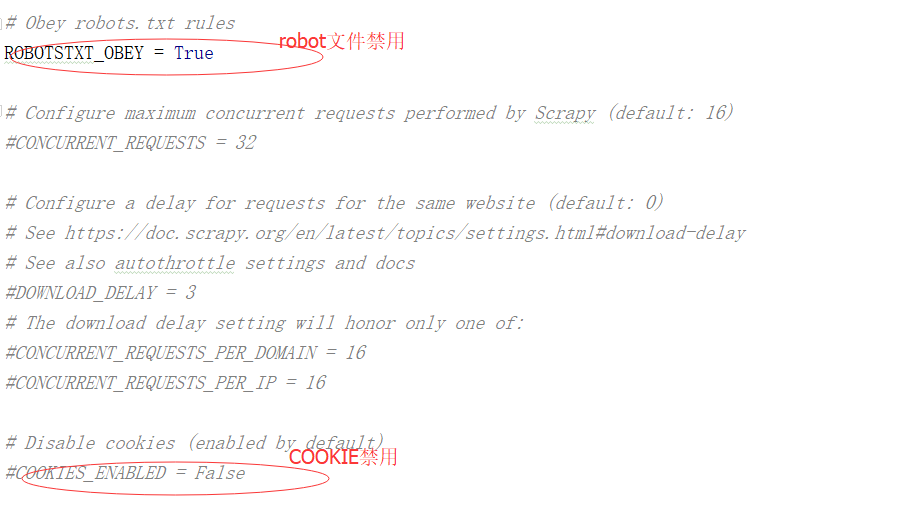
现在可以进行正常的爬取网页了
python3下scrapy爬虫(第一卷:安装问题)的更多相关文章
- python3下scrapy爬虫(第五卷:初步抓取网页内容之scrapy全面应用)
现在爬取http://category.dangdang.com/pg1-cid4008149.html网址上的商品价格,名称,评价数量 先准备下下数据:商品名,商品链接,评价数量 第一步:在item ...
- python3下scrapy爬虫(第二卷:初步抓取网页内容之直接抓取网页)
上一卷中介绍了安装过程,现在我们开始使用这个神奇的框架 跟很多博主一样我也先选择一个非常好爬取的网站作为最初案例,那么我先用屌丝必备网站http://www.shaimn.com/xinggan/作为 ...
- python3下scrapy爬虫(第十四卷:scrapy+scrapy_redis+scrapyd打造分布式爬虫之执行)
现在我们现在一个分机上引入一个SCRAPY的爬虫项目,要求数据存储在MONGODB中 现在我们需要在SETTING.PY设置我们的爬虫文件 再添加PIPELINE 注释掉的原因是爬虫执行完后,和本地存 ...
- python3下scrapy爬虫(第十二卷:解决scrapy数据存储大量数据时阻塞问题)
之前我们使用scrapy爬取数据,用的存储方式是直接引入PYMYSQL,或者MYSQLDB,案例中数据量并不大,这种数据存储方式属于同步过程,也就是上一条语句执行完才能执行下一条语句,当数据量变大时, ...
- python3下scrapy爬虫(第十一卷:scrapy数据存储进mongodb)
说起python爬虫数据存储就不得不说到mongodb,现在我们来试一下scrapy操作mongodb 首先开启mongodb mongod --dbpath=D:\mongodb\db 开启服务后就 ...
- python3下scrapy爬虫(第七卷:编辑器内执行scrapy)
之前我们都是在终端切入到scrapy的路境内执行爬虫的,你要多敲多少行的字节,所以这次我们谈谈如何在编辑器里执行,这个你可以用在爬虫中,当你使用PYTHONWEB开发时尽量不要在编辑器内启动端口服务那 ...
- python3下scrapy爬虫(第三卷:初步抓取网页内容之抓取网页里的指定数据)
上一卷中我们抓取了网页的所有内容,现在我们抓取下网页的图片名称以及连接 现在我再新建个爬虫文件,名称设置为crawler2 做爬虫的朋友应该知道,网页里的数据都是用文本或者块级标签包裹着的,scrap ...
- python3下scrapy爬虫(第十三卷:scrapy+scrapy_redis+scrapyd打造分布式爬虫之配置)
之前我们的爬虫都是单机爬取,也是单机维护REQUEST队列, 看一下单机的流程图: 一台主机控制一个队列,现在我要把它放在多机执行,会产生一个事情就是做重复的爬取,毫无意义,所以分布式爬虫的第一个难点 ...
- python3下scrapy爬虫(第六卷:利用cookie模拟登陆抓取个人中心页面)
之前我们爬取的都是那些无需登录就要可以使用的网站但是当我们想爬取自己或他人的个人中心时就需要做登录,一般进入登录页面有两种 ,一个是独立页面登陆,另一个是弹窗,我们先不管验证码登陆的问题 ,现在试一下 ...
随机推荐
- java this的用法以及原理
/** * this存在方法中,在方法中被调用. * 且是非static方法中被调用.(this 表示这个类的当前实例,而静态方法不依赖于该类的任何实例,随着类产生而装载,因此方法内不能引用 this ...
- Python笔记_第一篇_面向过程_第一部分_2.内存详解
Python的很多教材中并没有讲内存方面的知识,但是内存的知识非常重要,对于计算机工作原理和方便理解编程语言是非常重要的,尤其是小白,因此需要把这一方面加上,能够更加深入的理解编程语言.这里引用了C语 ...
- 深入分析Java反射(二)-数组和枚举
前提 Java反射的API在JavaSE1.7的时候已经基本完善,但是本文编写的时候使用的是Oracle JDK11,因为JDK11对于sun包下的源码也上传了,可以直接通过IDE查看对应的源码和进行 ...
- jquery如何获取div下ul的某个li
$('div ul').each(function(){ alert($(this).find('li').eq(x)) }) $("div ul li:eq(1)")// $(& ...
- java使用forEach填充字典值
// 填充字典值 Vector vector = vectorMapper.selectByPrimaryKey(id); VectorModel vectorModel = new VectorMo ...
- (最全最灵活地)利用Jxl工具包实现Excel表的内容读取 、写入(可向已有表中追加数据)
1.引子 (1)读取 Jxl工具比较强大,可以方便地实现Excel表的读取和写入.另一款工具Poi也具有相似的功能,并且功能更多,运用也相对复杂.Poi读取Excel表内容时,需要先判断其内容格式,如 ...
- Linux-proc文件系统介绍
1.操作系统级别的调试 (1).简单程序单步调试 (2).复杂程序printf打印信息调试 (3).框架体系日志记录信息调试 (4).内核调试的困境 2.proc虚拟文件系统的工作原理 (1).Lin ...
- Linux中的各种文件类型
Linux中有一句话:一切皆是文件 1.普通文件( - regular file ) (1).文本文件 文件中的内容是由文本构成的,文本指的是ASCII码字符.文件里的内容本质上都是数字( ...
- C++ 静态成员变量、成员函数
1.每个变量,都有自己的属性. 2.用 static 定义的成员变量.成员函数 ,是属于所有变量的. 3.关键字 static 可以用于说明一个类的成员. 4.把一个类的成员说明为 static 时, ...
- 如何把word文档导入到数据库中——java POI
本文方法借鉴于https://www.cnblogs.com/ljysy/p/10574197.html 在经过朋友的指导下,在处理文档的方式上有所不同. 我的数据库使用的是SQL server,这篇 ...