
IK分词器 整合solr4.7 含同义词、切分词、停止词
转载请注明出处!
IK分词器如果配置成
<fieldType name="text_ik" class="solr.TextField">

       <analyzer type="index" isMaxWordLength="false" class="org.wltea.analyzer.lucene.IKAnalyzer"/>

           <analyzer type="query" isMaxWordLength="true" class="org.wltea.analyzer.lucene.IKAnalyzer"/>

</fieldType>
本人测试切分词可以,但是同义词,扩展词库用不了,
网上查各种资料说IK分词器有个BUG,要自己把jar文件改一下,于是找到IK的源码,里面只有IKAnalyzer的源码,代码如下
package org.wltea.analyzer.lucene;

import java.io.Reader;

import org.apache.lucene.analysis.Analyzer;

import org.apache.lucene.analysis.Tokenizer;

/**

 * IK分词器,Lucene Analyzer接口实现

 * 兼容Lucene 4.0版本

 */

public final class IKAnalyzer extends Analyzer{

	private boolean useSmart;

	public boolean useSmart() {

		return useSmart;

	}

	public void setUseSmart(boolean useSmart) {

		this.useSmart = useSmart;

	}

	/**

	 * IK分词器Lucene  Analyzer接口实现类

	 *

	 * 默认细粒度切分算法

	 */

	public IKAnalyzer(){

		this(false);

	}

	/**

	 * IK分词器Lucene Analyzer接口实现类

	 *

	 * @param useSmart 当为true时,分词器进行智能切分

	 */

	public IKAnalyzer(boolean useSmart){

		super();

		this.useSmart = useSmart;

	}

	/**

	 * 重载Analyzer接口,构造分词组件

	 */

	@Override

	protected TokenStreamComponents createComponents(String fieldName, final Reader in) {

		Tokenizer _IKTokenizer = new IKTokenizer(in , this.useSmart());

		return new TokenStreamComponents(_IKTokenizer);

	}

}
自己加了一个IKAnalyzerSolrFactory,代码如下
package org.wltea.analyzer.lucene;

import java.io.Reader;

import java.util.Map;

import org.apache.lucene.analysis.Tokenizer;

import org.apache.lucene.analysis.util.TokenizerFactory;

import org.apache.lucene.util.AttributeSource.AttributeFactory;

public class IKAnalyzerSolrFactory extends TokenizerFactory{

    private boolean useSmart;

    public boolean useSmart() {

        return useSmart;

    }

    public void setUseSmart(boolean useSmart) {

        this.useSmart = useSmart;

    }

     public IKAnalyzerSolrFactory(Map<String,String> args) {

         super(args);

         assureMatchVersion();

         this.setUseSmart(args.get("useSmart").toString().equals("true"));

       }

    @Override

    public Tokenizer create(AttributeFactory factory, Reader input) {

        Tokenizer _IKTokenizer = new IKTokenizer(input , this.useSmart);

        return _IKTokenizer;

    }

}
这样一来就能在配置文件中配置成IKAnalyzerSolrFactory 的列子
下面是具体的配置描述:
1。修改IK的jar文件,加入IKAnalyzerSolrFactory (如果不会改的自行下载 http://pan.baidu.com/s/1gfLOIL9)
2.修改solrconfig.xml文件,加入
<lib dir="/contrib/analysis-extras/lib" regex=".*\.jar" />
3.修改schema.xml文件,加入
<!--IK分词器-->

	 <fieldType name="text_ik" class="solr.TextField">

        <analyzer type="index">

            <tokenizer class="org.wltea.analyzer.lucene.IKAnalyzerSolrFactory" useSmart="true"/>

        </analyzer>

        <analyzer type="query">

            <tokenizer class="org.wltea.analyzer.lucene.IKAnalyzerSolrFactory" useSmart="true"/>

			<filter class="solr.SynonymFilterFactory" synonyms="synonyms.txt" ignoreCase="true" expand="true"/>

        </analyzer>

    </fieldType>
4.在solr的webINFO 下的classes(没有新建)加入如下图,IK压缩文件中的部分文件,如图所示:
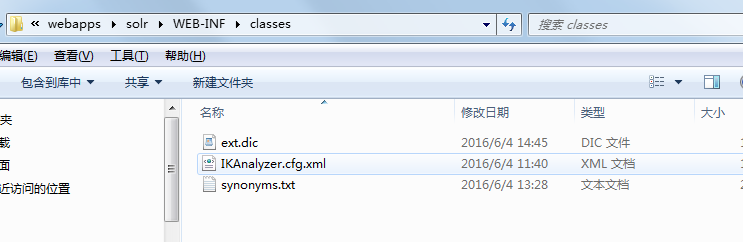
5.在ext.dic配置自定义词库,不需要切分词的词语配置在此,同义词写在synonyms.txt中即可。格式为: 通知,通告
注意每次改变词库或者同义词需要重启服务。
IK分词器 整合solr4.7 含同义词、切分词、停止词的更多相关文章
- Ik分词器没有使用---------elasticsearch-analysis-ik 5.6.3分词问题
此文章在作者认真阅读源码后发现,这并不是问题所在. 此篇文章是对IK配置的错误理解.新版本的IK配置的扩展字典本来就该使用者自己去手动配置! 1.问题 现在项目中用的是ES5.6.3的版本,在解决Fi ...
- nlp任务中的传统分词器和Bert系列伴生的新分词器tokenizers介绍
layout: blog title: Bert系列伴生的新分词器 date: 2020-04-29 09:31:52 tags: 5 categories: nlp mathjax: true ty ...
- 【杂记】docker搭建ELK 集群6.4.0版本 + elasticsearch-head IK分词器与拼音分词器整合
大佬博客地址:https://blog.csdn.net/supermao1013/article/category/8269552 docker elasticsearch 集群启动命令 docke ...
- solr4.x配置IK2012FF智能分词+同义词配置
本文配置环境:solr4.6+ IK2012ff +tomcat7 在Solr4.0发布以后,官方取消了BaseTokenizerFactory接口,而直接使用Lucene Analyzer标准接口T ...
- solr添加中文IK分词器,以及配置自定义词库
Solr是一个基于Lucene的Java搜索引擎服务器.Solr 提供了层面搜索.命中醒目显示并且支持多种输出格式(包括 XML/XSLT 和 JSON 格式).它易于安装和配置,而且附带了一个基于H ...
- 三、Solr多核心及分词器(IK)配置
多核心的概念 多核心说白了就是多索引库.也可以理解为多个"数据库表" 说一下使用multicore的真实场景,比若说,产品搜索和会员信息搜索,不使用多核也没问题,这样带来的问题是 ...
- Solr多核心及分词器(IK)配置
Solr多核心及分词器(IK)配置 多核心的概念 多核心说白了就是多索引库.也可以理解为多个"数据库表" 说一下使用multicore的真实场景,比若说,产品搜索和会员信息搜索 ...
- elasticsearch 之IK分词器安装
IK分词器地址:https://github.com/medcl/elasticsearch-analysis-ik 安装好ES之后就可以安装分词器插件了 记住选择ES对应的版本 对应的有版本选择下载 ...
- solr4.5配置中文分词器mmseg4j
solr4.x虽然提供了分词器,但不太适合对中文的分词,给大家推荐一个中文分词器mmseg4j mmseg4j的下载地址:https://code.google.com/p/mmseg4j/ 通过以下 ...
随机推荐
- Caffe源码解析6:Neuron_Layer
转载请注明出处,楼燚(yì)航的blog,http://home.cnblogs.com/louyihang-loves-baiyan/ NeuronLayer,顾名思义这里就是神经元,激活函数的相应 ...
- java中的大数BigInteger
compareTo比较大小 equals比较是否相等 ,不能用== while(cin.hasNext())//等价于!=EOF n=cin.nextBigInteger();//读入一个大整数 Sy ...
- [No00006A]Js的addEventListener()及attachEvent()区别分析【js中的事件监听】
1.添加时间监听: Chrom中: addEventListener的使用方式: target.addEventListener(type, listener, useCapture); target ...
- python有超时的windows系统时间设置代码
手边的笔记本用久了,cmos电池可能又没电了.每次开机时间都不对,导致访问一些有https的网页会出现警告信息. 于是找了找通过python脚本设置系统时间的方法,发现了两种,其一是调用socket直 ...
- Metasploit爆破tcpwrapped服务
转自:http://www.mamicode.com/info-detail-1653722.html 一.利用nmap工具扫描目标主机 1.1 使用nmap命令对目标主机进行扫描. 1.2 在终端中 ...
- Java面试宝典摘抄
1,ClassLoader知识 加载流程:当运行一个程序时,JVM启动,运行bootstrap classloader,该classloader加载Java核心API(此时ExtClassLoader ...
- button 样式
/** * 个人资料 */Ext.define('For.view.personal.MyPersonalData',{ extend:'Ext.panel.Panel', ...
- Freemarker常用技巧
1,截取字符串 有的时候我们在页面中不需要显示那么长的字符串,比如新闻标题,这样用下面的例子就可以自定义显示的长度 < lt. <= lte. > gt. >= gte < ...
- 分布式光伏系列:分布式光伏电站 运行与维护方案一览(zz)
原文:http://www.toutiao.com/a6353487210709516546/ 中小型光伏电站的特点是占地面积小.安装位置灵活且日常维护量少.由于光伏电站不同的运行环境,为了能够使光伏 ...
- 安卓开发:一种快速提取安卓app的UI图标资源的方法
在做安卓设计时,找美工设计界面的漂亮图标是必不可少的,但是对于一个初创团队来说,请一个UI的成本其实也挺高的,此时对于一个偏技术的产品经理来说,从其他成熟的产品的apk中提取图标就是一个很便捷的方法, ...