
Spark任务调度流程及调度策略分析
Spark任务调度
TaskScheduler调度入口:
(1) CoarseGrainedSchedulerBackend 在启动时会创建DriverEndPoint. 而DriverEndPoint中存在一定时任务,每隔一定时间(spark.scheduler.revive.interval, 默认为1s)进行一次调度(给自身发送ReviveOffers消息, 进行调用makeOffers进行调度)。代码如下所示
 override def onStart() {

      // Periodically revive offers to allow delay scheduling to work

      val reviveIntervalMs = conf.getTimeAsMs("spark.scheduler.revive.interval", "1s")

      reviveThread.scheduleAtFixedRate(new Runnable {

        override def run(): Unit = Utils.tryLogNonFatalError {

          Option(self).foreach(_.send(ReviveOffers))

        }

      }, , reviveIntervalMs, TimeUnit.MILLISECONDS)

    }
(2)当Executor执行完成已分配任务时,会向Driver发送StatusUpdate消息,当Driver接收到消后会调用 makeOffers(executorId)方法,进行任务调度, CoarseGrainedExecutorBackend 状态变化时向Driver (DriverEndPoint)向送StatusUpdate消息
  override def statusUpdate(taskId: Long, state: TaskState, data: ByteBuffer) {

    val msg = StatusUpdate(executorId, taskId, state, data)

    driver match {

      case Some(driverRef) => driverRef.send(msg)

      case None => logWarning(s"Drop $msg because has not yet connected to driver")

    }

  }
Dirver接收到StatusUpdate消息时将会触发设调度(makeOffers),为完成任务的Executor分配任务。
override def receive: PartialFunction[Any, Unit] = {

      case StatusUpdate(executorId, taskId, state, data) =>

        scheduler.statusUpdate(taskId, state, data.value)

        if (TaskState.isFinished(state)) {

          executorDataMap.get(executorId) match {

            case Some(executorInfo) =>

              executorInfo.freeCores += scheduler.CPUS_PER_TASK

              makeOffers(executorId)

            case None =>

              // Ignoring the update since we don't know about the executor.

              logWarning(s"Ignored task status update ($taskId state $state) " +

                s"from unknown executor with ID $executorId")

          }

        }

      case ReviveOffers =>

        makeOffers()

      case KillTask(taskId, executorId, interruptThread) =>

        executorDataMap.get(executorId) match {

          case Some(executorInfo) =>

            executorInfo.executorEndpoint.send(KillTask(taskId, executorId, interruptThread))

          case None =>

            // Ignoring the task kill since the executor is not registered.

            logWarning(s"Attempted to kill task $taskId for unknown executor $executorId.")

        }

    }
其中makeOffers方法,会调用TaskSchedulerImpl中的resourceOffers方法,依其的调度策略为Executor分配适合的任务。具体代码如下:
a、为所有资源分配任务
 // Make fake resource offers on all executors

    private def makeOffers() {

      // Filter out executors under killing

      val activeExecutors = executorDataMap.filterKeys(!executorsPendingToRemove.contains(_))

      val workOffers = activeExecutors.map { case (id, executorData) =>

        new WorkerOffer(id, executorData.executorHost, executorData.freeCores)

      }.toSeq

      launchTasks(scheduler.resourceOffers(workOffers))

    }
b、为单个executor分配任务
 // Make fake resource offers on just one executor

    private def makeOffers(executorId: String) {

      // Filter out executors under killing

      if (!executorsPendingToRemove.contains(executorId)) {

        val executorData = executorDataMap(executorId)

        val workOffers = Seq(

          new WorkerOffer(executorId, executorData.executorHost, executorData.freeCores))

        launchTasks(scheduler.resourceOffers(workOffers))

      }

    }
分配完任务后,向Executor发送LaunchTask指令,启动任务,执行用户逻辑代码
 // Launch tasks returned by a set of resource offers

    private def launchTasks(tasks: Seq[Seq[TaskDescription]]) {

      for (task <- tasks.flatten) {

        val serializedTask = ser.serialize(task)

        if (serializedTask.limit >= akkaFrameSize - AkkaUtils.reservedSizeBytes) {

          scheduler.taskIdToTaskSetManager.get(task.taskId).foreach { taskSetMgr =>

            try {

              var msg = "Serialized task %s:%d was %d bytes, which exceeds max allowed: " +

                "spark.akka.frameSize (%d bytes) - reserved (%d bytes). Consider increasing " +

                "spark.akka.frameSize or using broadcast variables for large values."

              msg = msg.format(task.taskId, task.index, serializedTask.limit, akkaFrameSize,

                AkkaUtils.reservedSizeBytes)

              taskSetMgr.abort(msg)

            } catch {

              case e: Exception => logError("Exception in error callback", e)

            }

          }

        }

        else {

          val executorData = executorDataMap(task.executorId)

          executorData.freeCores -= scheduler.CPUS_PER_TASK

          executorData.executorEndpoint.send(LaunchTask(new SerializableBuffer(serializedTask)))

        }

      }

    }
Spark任务调度策略
Ò FIFO
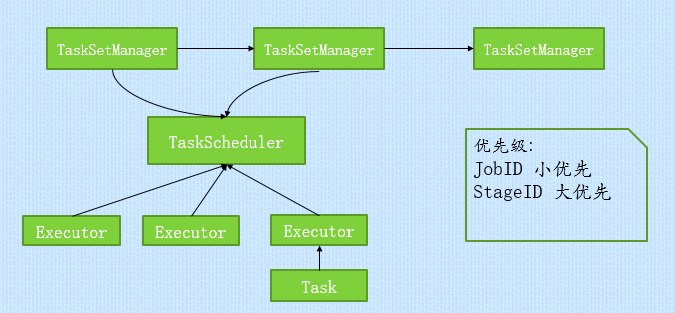
FIFO(先进先出)方式调度Job,如下图所示,每个Job被切分成多个Stage.第一个Job优先获取所有可用资源,接下来第二个Job再获取剩余可用资源。(每个Stage对应一个TaskSetManager)
Ò FAIR
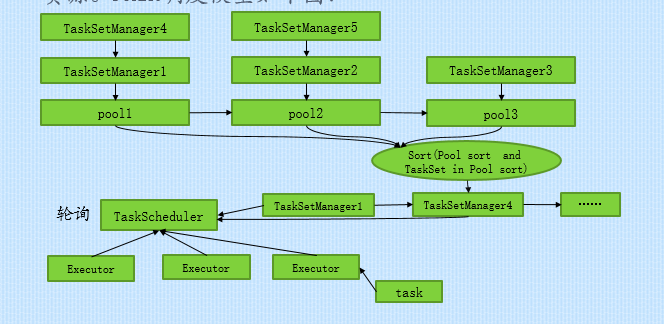
FAIR共享模式调度下,Spark以在多Job之间轮询方式为任务分配资源,所有的任务拥有大致相当的优先级来共享集群的资源。FAIR调度模型如下图:
下面从源码的角度对调度策略进行说明:
当触发调度时,会调用TaskSchedulerImpl的resourceOffers方法,方法中会依照调度策略选出要执行的TaskSet, 然后取出适合(考虑本地性)的task交由Executor执行, 其代码如下:
  /**

   * Called by cluster manager to offer resources on slaves. We respond by asking our active task

   * sets for tasks in order of priority. We fill each node with tasks in a round-robin manner so

   * that tasks are balanced across the cluster.

   */

  def resourceOffers(offers: Seq[WorkerOffer]): Seq[Seq[TaskDescription]] = synchronized {

    // Mark each slave as alive and remember its hostname

    // Also track if new executor is added

    var newExecAvail = false

    for (o <- offers) {

      executorIdToHost(o.executorId) = o.host

      activeExecutorIds += o.executorId

      if (!executorsByHost.contains(o.host)) {

        executorsByHost(o.host) = new HashSet[String]()

        executorAdded(o.executorId, o.host)

        newExecAvail = true

      }

      for (rack <- getRackForHost(o.host)) {

        hostsByRack.getOrElseUpdate(rack, new HashSet[String]()) += o.host

      }

    }

    // Randomly shuffle offers to avoid always placing tasks on the same set of workers.

    val shuffledOffers = Random.shuffle(offers)

    // Build a list of tasks to assign to each worker.

    val tasks = shuffledOffers.map(o => new ArrayBuffer[TaskDescription](o.cores))

    val availableCpus = shuffledOffers.map(o => o.cores).toArray

    val sortedTaskSets = rootPool.getSortedTaskSetQueue

    for (taskSet <- sortedTaskSets) {

      logDebug("parentName: %s, name: %s, runningTasks: %s".format(

        taskSet.parent.name, taskSet.name, taskSet.runningTasks))

      if (newExecAvail) {

        taskSet.executorAdded()

      }

    }

    // Take each TaskSet in our scheduling order, and then offer it each node in increasing order

    // of locality levels so that it gets a chance to launch local tasks on all of them.

    // NOTE: the preferredLocality order: PROCESS_LOCAL, NODE_LOCAL, NO_PREF, RACK_LOCAL, ANY

    var launchedTask = false

    for (taskSet <- sortedTaskSets; maxLocality <- taskSet.myLocalityLevels) {

      do {

        launchedTask = resourceOfferSingleTaskSet(

            taskSet, maxLocality, shuffledOffers, availableCpus, tasks)

      } while (launchedTask)

    }

    if (tasks.size > ) {

      hasLaunchedTask = true

    }

    return tasks

  }
经过分析可知,通过rootPool.getSortedTaskSetQueue对队列中的TaskSet进行排序,getSortedTaskSetQueue的具体实现如下:
  override def getSortedTaskSetQueue: ArrayBuffer[TaskSetManager] = {

    var sortedTaskSetQueue = new ArrayBuffer[TaskSetManager]

    val sortedSchedulableQueue =

      schedulableQueue.asScala.toSeq.sortWith(taskSetSchedulingAlgorithm.comparator)

    for (schedulable <- sortedSchedulableQueue) {

      sortedTaskSetQueue ++= schedulable.getSortedTaskSetQueue

    }

    sortedTaskSetQueue

  }
由上述代码可知,其通过算法做为比较器对taskSet进行排序, 其中调度算法有FIFO和FAIR两种,下面分别进行介绍。
FIFO
优先级(Priority): 在DAGscheduler创建TaskSet时使用JobId做为优先级的值。
FIFO调度算法实现如下所示
private[spark] class FIFOSchedulingAlgorithm extends SchedulingAlgorithm {

  override def comparator(s1: Schedulable, s2: Schedulable): Boolean = {

    val priority1 = s1.priority

    val priority2 = s2.priority

    var res = math.signum(priority1 - priority2)

    if (res == ) {

      val stageId1 = s1.stageId

      val stageId2 = s2.stageId

      res = math.signum(stageId1 - stageId2)

    }

    if (res < ) {

      true

    } else {

      false

    }

  }

}
由源码可知,FIFO依据JobId进行挑选较小值。因为越早提交的作业,JobId越小。
对同一个作业(Job)来说越先生成的Stage,其StageId越小,有依赖关系的多个Stage之间,DAGScheduler会控制Stage是否会被提交到调度队列中(若其依赖的Stage未执行完前,此Stage不会被提交),其调度顺序可通过此来保证。但若某Job中有两个无入度的Stage的话,则先调度StageId小的Stage.
Fair
Fair调度队列相比FIFO较复杂,其可存在多个调度队列,且队列呈树型结构(现阶段Spark的Fair调度只支持两层树结构),每用户可以使用sc.setLocalProperty(“spark.scheduler.pool”, “poolName”)来指定要加入的队列,默认情况下会加入到buildDefaultPool。每个队列中还可指定自己内部的调度策略,且Fair还存在一些特殊的属性:
schedulingMode: 设置调度池的调度模式FIFO或FAIR, 默认为FIFO.
minShare:最少资源保证量,当一个队列最少资源未满足时,它将优先于其它同级队列获取资源。
weight: 在一个队列内部分配资源时,默认情况下,采用公平轮询的方法将资源分配给各个应用程序,而该参数则将打破这种平衡。例如,如果用户配置一个指定调度池权重为2, 那么这个调度池将会获得相对于权重为1的调度池2倍的资源。
以上参数,可通过conf/fairscheduler.xml文件配置调度池的属性。
Fair调度算法实现如下所示:
private[spark] class FairSchedulingAlgorithm extends SchedulingAlgorithm {

  override def comparator(s1: Schedulable, s2: Schedulable): Boolean = {

    val minShare1 = s1.minShare

    val minShare2 = s2.minShare

    val runningTasks1 = s1.runningTasks

    val runningTasks2 = s2.runningTasks

    val s1Needy = runningTasks1 < minShare1

    val s2Needy = runningTasks2 < minShare2

    val minShareRatio1 = runningTasks1.toDouble / math.max(minShare1, 1.0).toDouble

    val minShareRatio2 = runningTasks2.toDouble / math.max(minShare2, 1.0).toDouble

    val taskToWeightRatio1 = runningTasks1.toDouble / s1.weight.toDouble

    val taskToWeightRatio2 = runningTasks2.toDouble / s2.weight.toDouble

    var compare: Int =

    if (s1Needy && !s2Needy) {

      return true

    } else if (!s1Needy && s2Needy) {

      return false

    } else if (s1Needy && s2Needy) {

      compare = minShareRatio1.compareTo(minShareRatio2)

    } else {

      compare = taskToWeightRatio1.compareTo(taskToWeightRatio2)

    }

    if (compare < ) {

      true

    } else if (compare > ) {

      false

    } else {

      s1.name < s2.name

    }

  }

}
由原码可知,未满足minShare规定份额的资源的队列或任务集先执行;如果所有均不满足minShare的话,则选择缺失比率小的先调度;如果均不满足,则按执行权重比进行选择,先调度执行权重比小的。如果执行权重也相同的话则会选择StageId小的进行调度(name=“TaskSet_”+ taskSet.stageId.toString)。
以此为标准将所有TaskSet进行排序, 然后选出优先级最高的进行调度。
Spark 任务调度之任务本地性
当选出TaskSet后,将按本地性从中挑选适合Executor的任务,在Executor上执行。
(详细见http://www.cnblogs.com/barrenlake/p/4550800.html一小节相关内容)
文章地址: http://www.cnblogs.com/barrenlake/p/4891589.html
Spark任务调度流程及调度策略分析的更多相关文章
- 【Spark】Spark任务调度相关知识
文章目录 准备知识 DAG 概述 shuffle 概述 SortShuffleManager 普通机制 bypass机制 Spark任务调度 流程 准备知识 要弄清楚Spark的任务调度流程,就必须要 ...
- 苏宁基于Spark Streaming的实时日志分析系统实践 Spark Streaming 在数据平台日志解析功能的应用
https://mp.weixin.qq.com/s/KPTM02-ICt72_7ZdRZIHBA 苏宁基于Spark Streaming的实时日志分析系统实践 原创: AI+落地实践 AI前线 20 ...
- Spark RPC框架源码分析(三)Spark心跳机制分析
一.Spark心跳概述 前面两节中介绍了Spark RPC的基本知识,以及深入剖析了Spark RPC中一些源码的实现流程. 具体可以看这里: Spark RPC框架源码分析(二)运行时序 Spark ...
- Spark Scheduler模块源码分析之TaskScheduler和SchedulerBackend
本文是Scheduler模块源码分析的第二篇,第一篇Spark Scheduler模块源码分析之DAGScheduler主要分析了DAGScheduler.本文接下来结合Spark-1.6.0的源码继 ...
- Apache 流框架 Flink,Spark Streaming,Storm对比分析(一)
本文由 网易云发布. 1.Flink架构及特性分析 Flink是个相当早的项目,开始于2008年,但只在最近才得到注意.Flink是原生的流处理系统,提供high level的API.Flink也提 ...
- Spark RPC框架源码分析(二)RPC运行时序
前情提要: Spark RPC框架源码分析(一)简述 一. Spark RPC概述 上一篇我们已经说明了Spark RPC框架的一个简单例子,Spark RPC相关的两个编程模型,Actor模型和Re ...
- Apache 流框架 Flink,Spark Streaming,Storm对比分析(二)
本文由 网易云发布. 本文内容接上一篇Apache 流框架 Flink,Spark Streaming,Storm对比分析(一) 2.Spark Streaming架构及特性分析 2.1 基本架构 ...
- 第二篇:Spark SQL Catalyst源码分析之SqlParser
/** Spark SQL源码分析系列文章*/ Spark SQL的核心执行流程我们已经分析完毕,可以参见Spark SQL核心执行流程,下面我们来分析执行流程中各个核心组件的工作职责. 本文先从入口 ...
- Apache 流框架 Flink,Spark Streaming,Storm对比分析(2)
此文已由作者岳猛授权网易云社区发布. 欢迎访问网易云社区,了解更多网易技术产品运营经验. 2.Spark Streaming架构及特性分析 2.1 基本架构 基于是spark core的spark s ...
随机推荐
- vs 2013调试的时候重启的解决方案
今天在用vs 2013 调试程序的时候,vs 总是莫名其妙的关闭,停止运行,泪蹦了..... 是什么原因呢? 以前的时候可是好好的啊,经过认真的思索,最近装过和vs 2013 相关的程序也只有 ref ...
- java--I/O流总结
java中的I/O流从所操作的数据单元上分为两类:字节流和字符流. 1.字节流 字节流主要有两个抽象基类:InputStream和OutputStream:其中InputStream是输入字节流,Ou ...
- ubuntu eclipse CDT 问题
问题一:ubuntu eclipse c++ launch failed binary not found 解决:建完项目后 查看在项目中是不是有debug目录,说明没有编译.仅仅是须要做例如以下操作 ...
- Android自定义属性、控件三步法
第二步中layout-activity_main.xml 中自命名控件: xmlns:android="http://schemas.android.com/apk/res/android& ...
- 将用户信息保存到Cookie中
/** * 把用户保存到Cookie * * @param request * @param response * @param member */ private void rememberPwdA ...
- z-index优先级总结
因为显示器显示的图案是一个二维平面,拥有x轴和y轴来表示位置属性.为了表示三维立体的概念如显示元素的上下层的叠加顺序引入了z-index属性来表示z轴的区别,表示一个元素在叠加顺序上的上下立体关系. ...
- yii2 添加模块过程
本文以Yii2基本应用程序模板为例,介绍下向该框架下加入新模块的过程: 1. 新建模块相关目录与文件 step 1: 新建目录结构 首先在根目录下新建modules目录,然后在该目录下面添加模块目 ...
- 各版本IIS安装方法
各版本IIS安装方法 Windows 2000 V5.0 将操作系统安装光盘放入光驱,打开“控制面板”→“添加或删除程序”→“添加/删除 Windows 组件”,勾选“Internet信息服务(I ...
- asp.net微信开发第六篇----高级群发(文本)
说到高级群发,微信的参考资料http://mp.weixin.qq.com/wiki/14/0c53fac3bdec3906aaa36987b91d64ea.html 首先我们先来讲解一下群发文本信息 ...
- 您为这个网络适配器输入的IP地址xxx.xxx.xxx.xx已经分配给另一个适配器xxx...
您为这个网络适配器输入的IP地址xxx.xxx.xxx.xx已经分配给另一个适配器‘xxx NIC’.... 2008年11月03日 星期一 08:51 问题现象: 在网卡的TCP/IP属性中无法 ...