
【Spark】Spark任务调度相关知识
准备知识
要弄清楚Spark的任务调度流程,就必须要清楚RDD、Lineage、DAG和shuffle的相关知识,关于RDD和Lineage,我的这两天文章已经有过相关介绍,感兴趣可以去看一看
【Spark】RDD(Resilient Distributed Dataset)究竟是什么?
【Spark】RDD的依赖关系和缓存相关知识点接下来说一下DAG的生成和shuffle的过程
DAG
概述
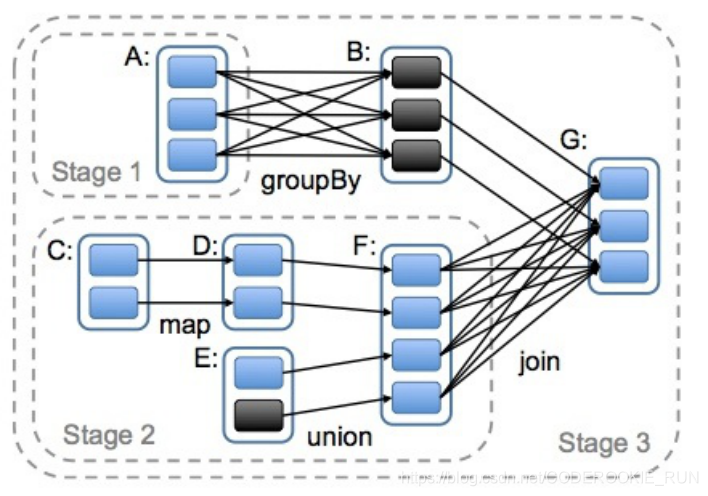
DAG(Directed Acyclic Graph),被称为有向无环图,就是有方向无闭环,是根据RDD之间的依赖关系,也即Lineage形成的。
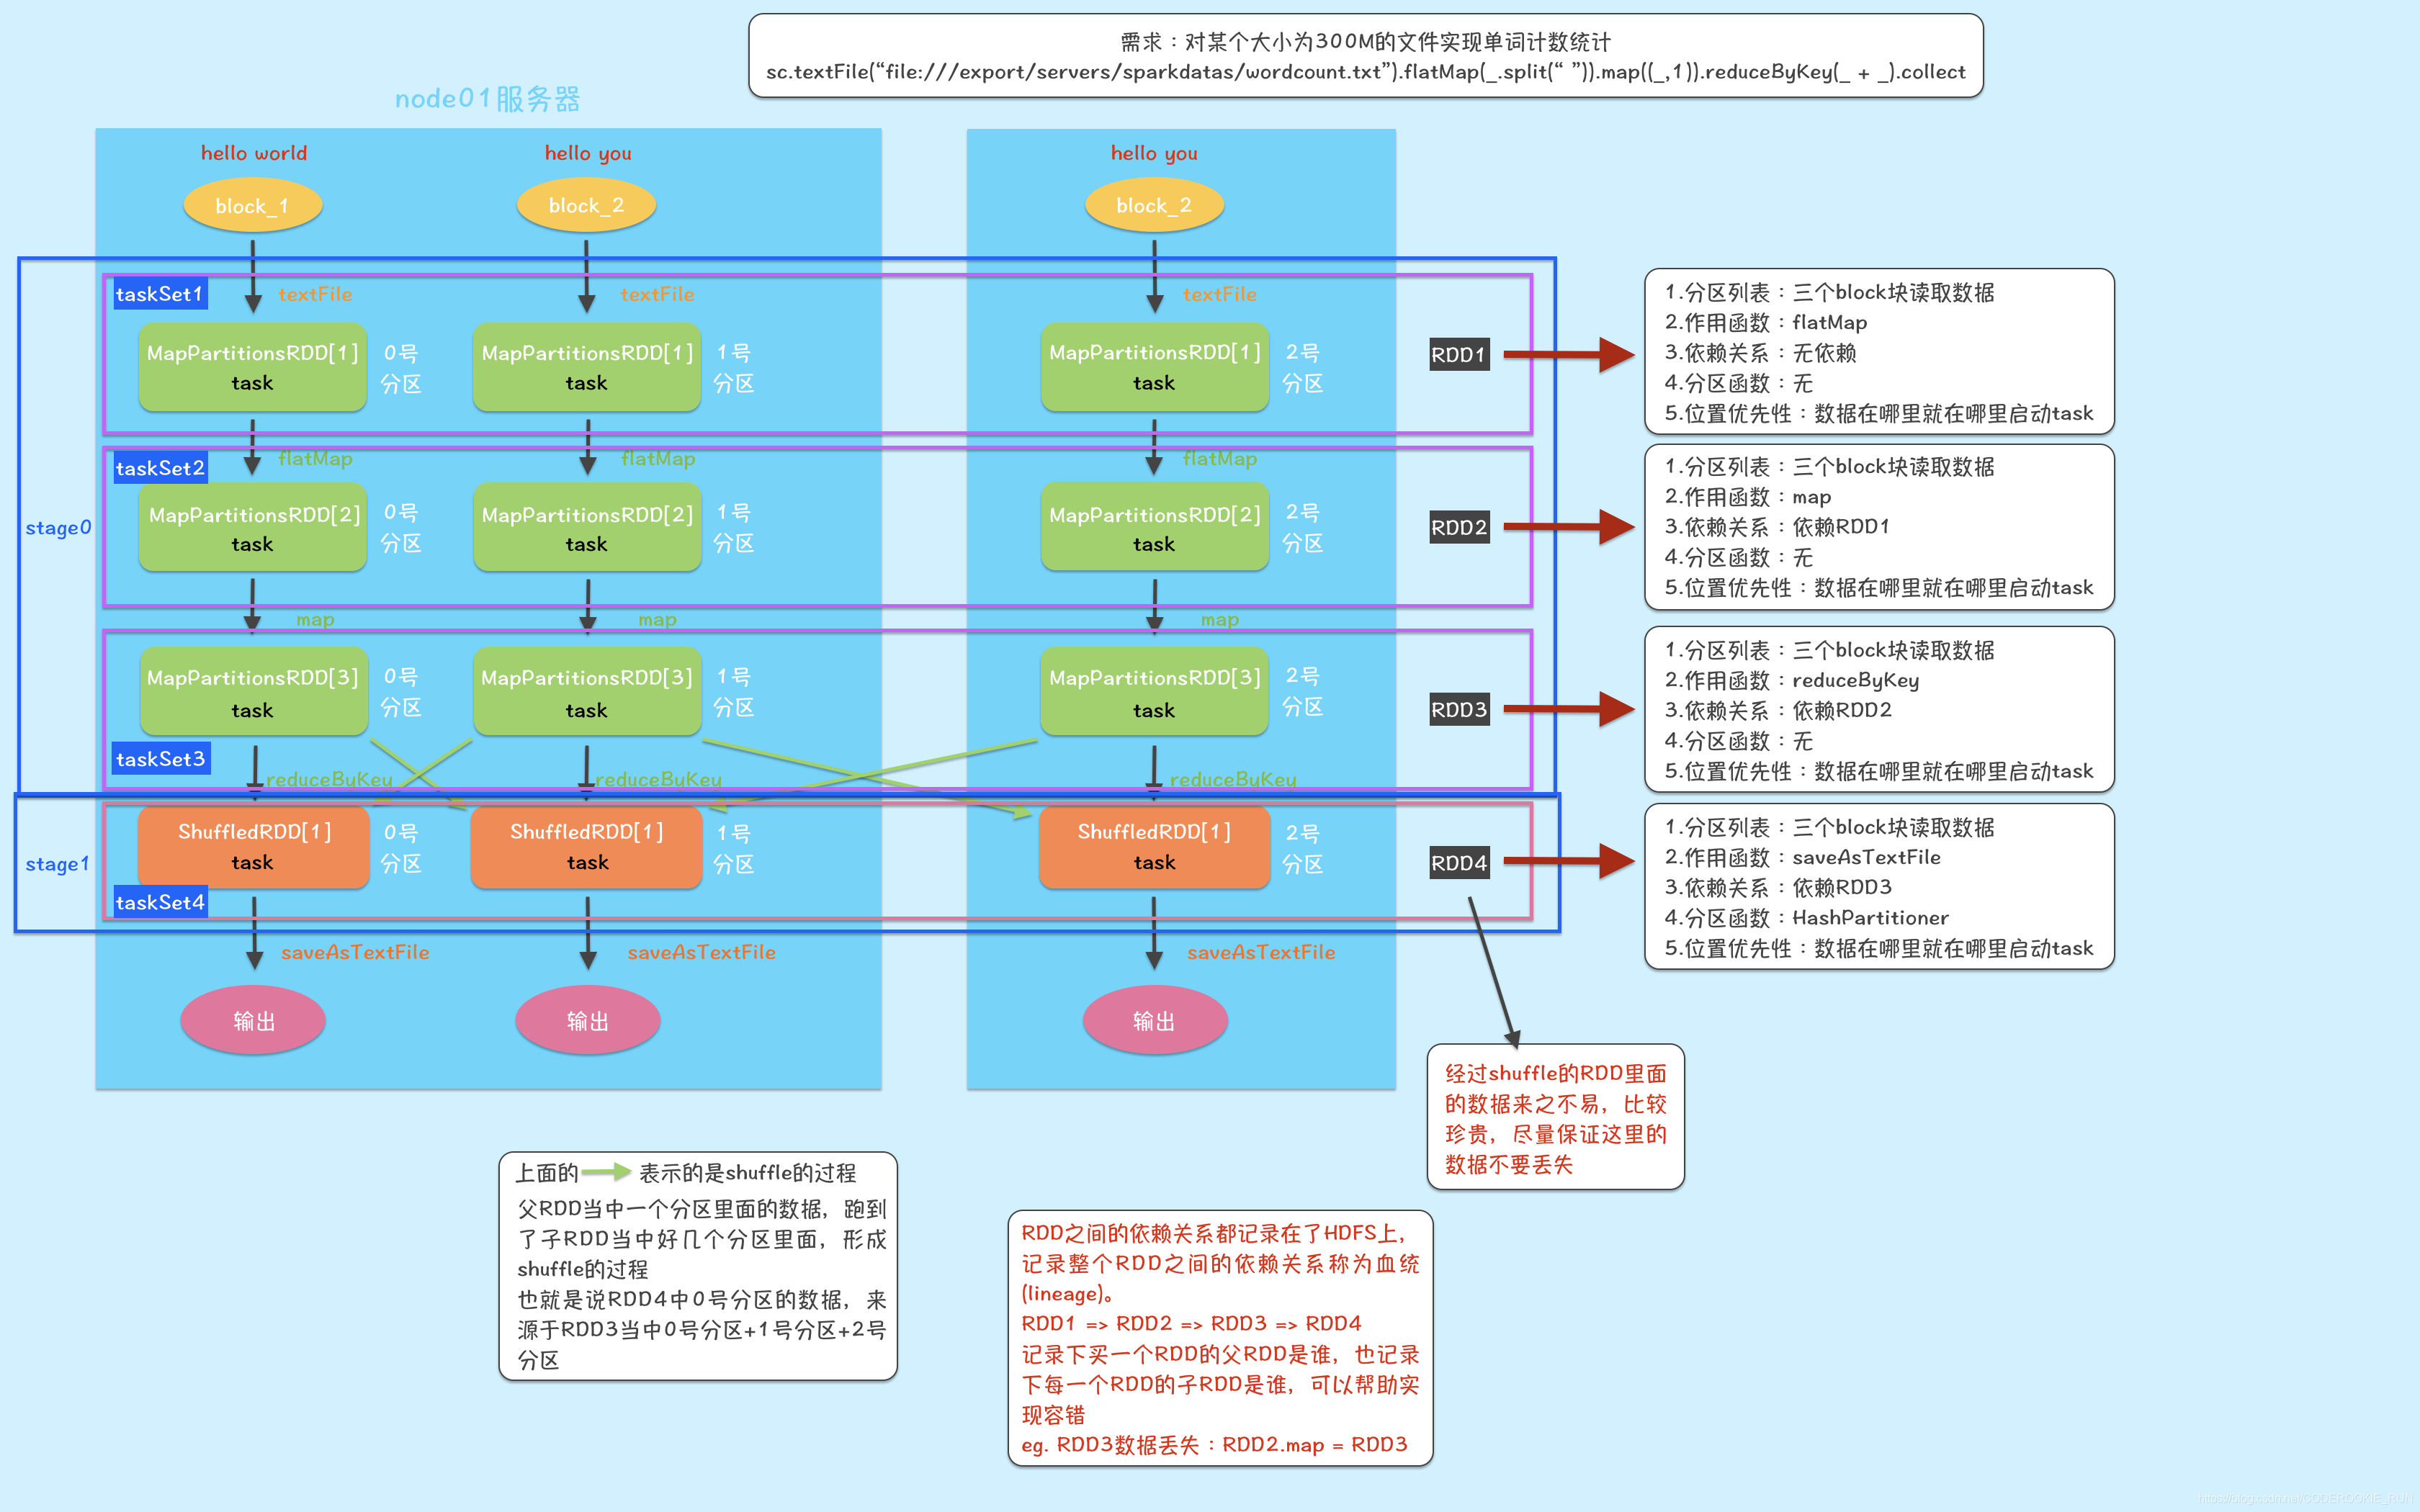
DAG的生成就是为了划分stage,而stage的划分则是从上往下依次,遇到窄依赖便将其加入到当前stage当中,如果遇到宽依赖就重新开始一个stage,而区别宽窄依赖的依据就是是否发生了shuffle过程,那么stage划分的最终依据就是是否发生shuffle过程,正如下图所示
shuffle
概述
在Spark中,负责shuffle过程的执行、计算和处理的组件主要就是ShuffleManager。在Spark1.2版本前,默认的shuffle计算引擎是 HashShuffleManager,Spark1.2版本后,改成了 SortShuffleManager。
HashShuffleManager有一个重大弊端:会产生大量的中间磁盘文件,进而由大量的磁盘IO操作影响了性能。
SortShuffleManager
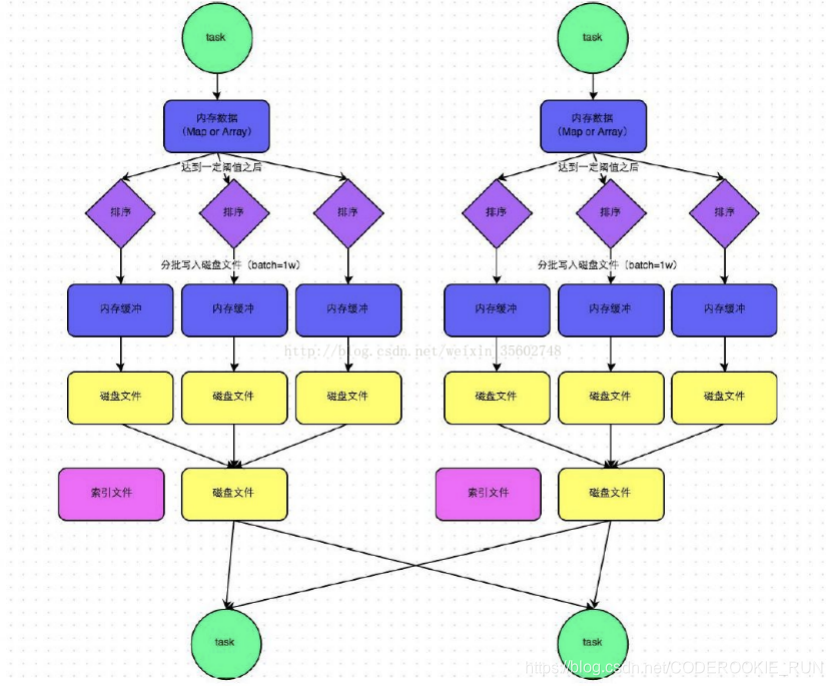
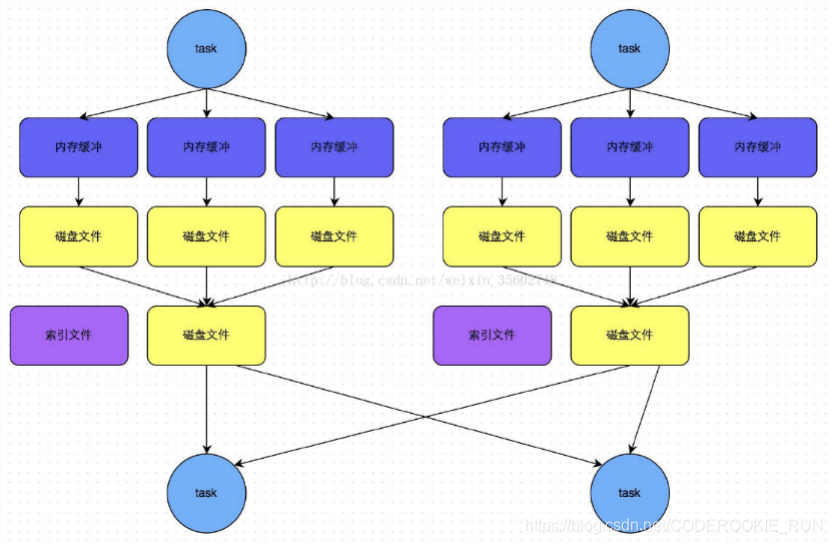
SortShuffleManager针对HashShuffleManager的弊端做了改进,设置了两种运行机制:普通运行机制和bypass运行机制。
当shuffle read task的数量小于等于spark.shuffle.sort.bypassMergeThreshold参数的值时(默认为200),就会启用bypass机制。
普通机制
数据会先写到内存大小为5M的缓存中,写满后溢写成为一个个的小文件,并同时进行排序,然后再分批写入到内存缓冲区,进一步写入到磁盘文件中,最后将磁盘文件进行合并,成为一个大文件,并创建对应的索引文件,等待接下来的线程拉取数据
bypass机制
数据不需要经过溢写和排序,直接将数据写入到内存缓冲区,缓冲区写满后溢写到磁盘文件,所有的临时磁盘文件会合并成一个磁盘文件,并创建对应的索引文件,等待拉取
Spark任务调度
流程
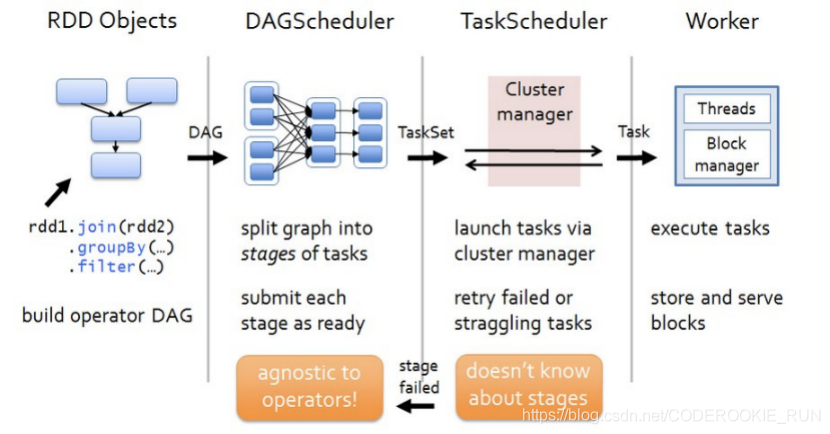
一、客户端提交jar包,也就是一个Application
二、Spark会根据Application中的RDD依赖关系,也就是Lineage开始划分DAG
三、划分完成后DAG会被送到DAGScheduler
四、DAGScheduler会根据是否为宽依赖划分Stage,并进一步划分出一个个的taskSet
五、DAGScheduler将划分好的taskSet送到TaskScheduler
六、TaskScheduler接收成功后,会将taskSet划分成为一个个的task,并准备将task发送到Worker中的executor执行
七、与executor进行通信,开始执行task
前六步都是Spark-Driver负责,所以一般推荐使用Cluster模式,将Driver运行在Worker中
【Spark】Spark任务调度相关知识的更多相关文章
- Spark on Yarn年度知识整理
大数据体系结构: Spark简介 Spark是整个BDAS的核心组件,是一个大数据分布式编程框架,不仅实现了MapReduce的算子map 函数和reduce函数及计算模型,还提供更为丰富的算子,如f ...
- Spark的任务调度
本文尝试从源码层面梳理Spark在任务调度与资源分配上的做法. 先从Executor和SchedulerBackend说起.Executor是真正执行任务的进程,本身拥有若干cpu和内存,可以执行以线 ...
- Spark内核-任务调度机制
作者:十一喵先森 链接:https://juejin.im/post/5e1c414fe51d451cad4111d1 来源:掘金 著作权归作者所有.商业转载请联系作者获得授权,非商业转载请注明出处. ...
- Spark-读写HBase,SparkStreaming操作,Spark的HBase相关操作
Spark-读写HBase,SparkStreaming操作,Spark的HBase相关操作 1.sparkstreaming实时写入Hbase(saveAsNewAPIHadoopDataset方法 ...
- 分布式计算框架-Spark(spark环境搭建、生态环境、运行架构)
Spark涉及的几个概念:RDD:Resilient Distributed Dataset(弹性分布数据集).DAG:Direct Acyclic Graph(有向无环图).SparkContext ...
- [spark] spark 特性、简介、下载
[简介] 官网:http://spark.apache.org/ 推荐学习博客:http://dblab.xmu.edu.cn/blog/spark/ spark是一个采用Scala语言进行开发,更快 ...
- PySpark SQL 相关知识介绍
title: PySpark SQL 相关知识介绍 summary: 关键词:大数据 Hadoop Hive Pig Kafka Spark PySpark SQL 集群管理器 PostgreSQL ...
- 【Python五篇慢慢弹(5)】类的继承案例解析,python相关知识延伸
类的继承案例解析,python相关知识延伸 作者:白宁超 2016年10月10日22:36:57 摘要:继<快速上手学python>一文之后,笔者又将python官方文档认真学习下.官方给 ...
- 移动WEB像素相关知识
了解移动web像素的知识,主要是为了切图时心中有数.本文主要围绕一个问题:怎样根据设备厂商提供的屏幕尺寸和物理像素得到我们切图需要的逻辑像素?围绕这个问题以iphone5为例讲解涉及到的web像素相关 ...
随机推荐
- Ajax 简述与基础语法
目录 Ajax 1. 原生 JS 实现 Ajax 2. 使用 Ajax 实现异步通信 a. Ajax 的基础语法 b. 用 Ajax 传递数据 i. 传递字符串数据 ii. 传递 JSON 数据 3. ...
- D - Three Integers CodeForces - 1311D
题意: a<=b<=c 输出A,B,C要求B是A的倍数,C是B的倍数,并且输出a,b,c变成A,B,C需要的最小次数. 题解:写了半天的二分,后来发现思路错了,,,暴力就能过.. 三层fo ...
- Python中关于第三方库的补充
Python语言的强大之处在于它的开源.正是因为它的开源,产生了成百上千的第三方库,涵盖了计算机的几乎所有的方向.第三方库的安装也并不是特别的复杂,通过在cmd中使用pip命令可以安装几乎所有的库,但 ...
- react: typescript jest && enzyme
Install Jest 1.install jest dependencies jest @types/jest ts-jest -D 2.jest.config.js module.exports ...
- orcale 树形结构查询
接到需求是要在一个表中(表结构为主键id和父id)循环显示数据,类似于省市县++这种情况 也可能不只有三级子菜单 id name parentid 1 a 0 2 ...
- GitHub 热点速览 Vol.17:在?各家视频会员要不要?
作者:HelloGitHub-小鱼干 摘要:经济实用,用作上周的 GitHub 热点的横批再合适不过.先不说 GitHub Trending 上不止一个的会员共享项目,免你找好友刷脸要会员,这项目实在 ...
- Scrapy模拟登录信息
携带cookie模拟登录 需要在爬虫里面自定义一个start_requests()的函数 里面的内容: def start_requests(self): cookies = '真实有效的cookie ...
- Apk优化极致
1. webp WebP格式,谷歌(google)开发的一种旨在加快图片加载速度的图片格式.图片压缩体积大约只有JPEG的2/3,并能节省大量的服务器宽带资源和数据空间.Facebook Ebay等知 ...
- IDEA 之 ERROR:端口被占用
问题描述:在IDEA启动javaweb项目中未能成功启动,ERROR:端口已经被使用.但是tomcat并没有被启动. 解决方法: 打开CMD 输入以下命令 netstat -aon | finfstr ...
- Material Design 设计规范总结(2)
本文是Material Design设计规范总结的第二部分,是进行UI设计与前端开发的必备参考资料. 八.布局 (1)所有可操作元素最小点击区域尺寸:48dp X 48dp. (2)栅格系统的最小单位 ...