
机器学习(1)之梯度下降(gradient descent)
机器学习(1)之梯度下降(gradient descent)
题记:最近零碎的时间都在学习Andrew Ng的machine learning,因此就有了这些笔记。
梯度下降是线性回归的一种(Linear Regression),首先给出一个关于房屋的经典例子,
| 面积(feet2) | 房间个数 | 价格(1000$) |
| 2104 | 3 | 400 |
| 1600 | 3 | 330 |
| 2400 | 3 | 369 |
| 1416 | 2 | 232 |
| 3000 | 4 | 540 |
| ... | ... | .. |
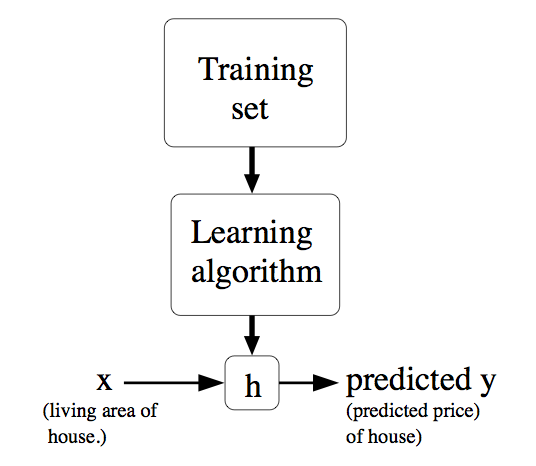
上表中面积和房间个数是输入参数,价格是所要输出的解。面积和房间个数分别表示一个特征,用X表示。价格用Y表示。表格的一行表示一个样本。现在要做的是根据这些样本来预测其他面积和房间个数对应的价格。可以用以下图来表示,即给定一个训练集合,学习函数h,使得h(x)能符合结果Y。
一. 批梯度下降算法
可以用以下式子表示一个样本:

θ表示X映射成Y的权重,x表示一次特征。假设x0=1,上式就可以写成:
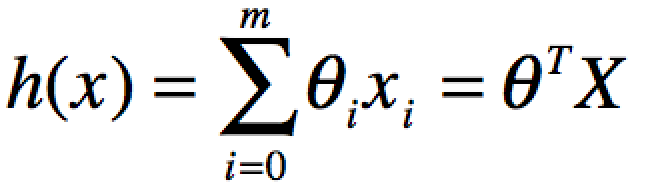
分别使用x(j),y(j)表示第J个样本。我们计算的目的是为了让计算的值无限接近真实值y,即代价函数可以采用LMS算法
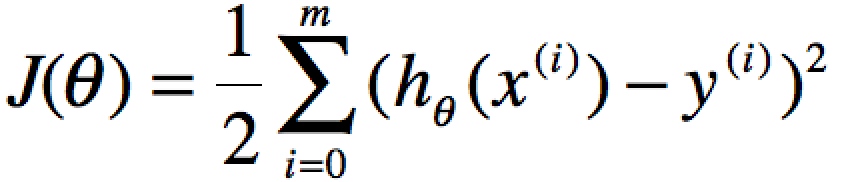
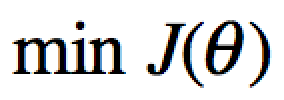
要获取J(θ)最小,即对J(θ)进行求导且为零:
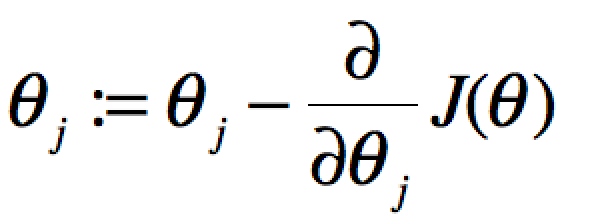
当单个特征值时,上式中j表示系数(权重)的编号,右边的值赋值给左边θj从而完成一次迭代。
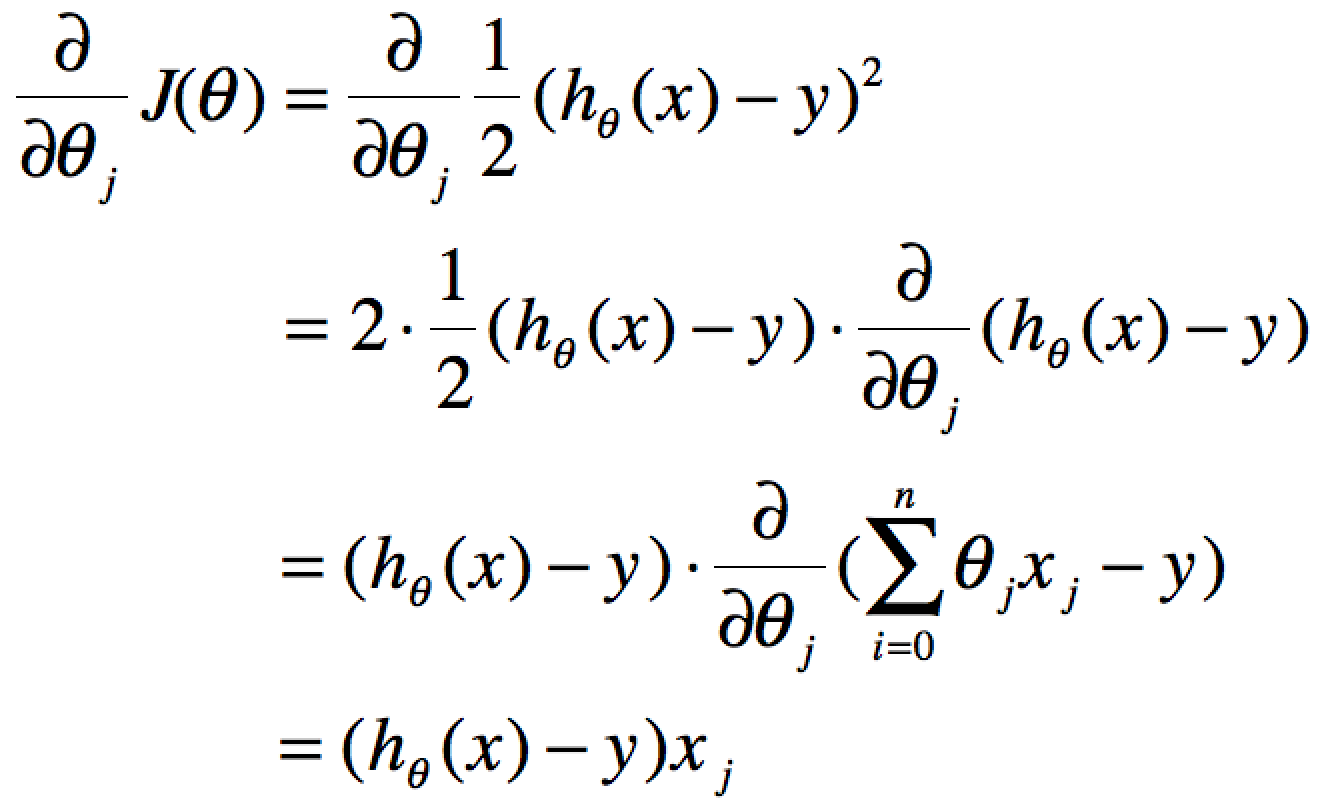
单个特征的迭代如下:

多个特征的迭代如下:
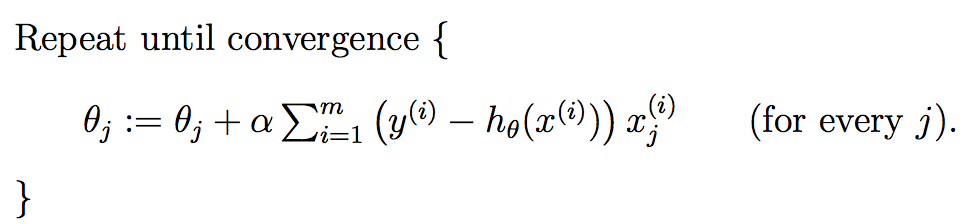
上式就是批梯度下降算法(batch gradient descent),当上式收敛时则退出迭代,何为收敛,即前后两次迭代的值不再发生变化了。一般情况下,会设置一个具体的参数,当前后两次迭代差值小于该参数时候结束迭代。注意以下几点:
二. 随机梯度下降算法
因为每次计算梯度都需要遍历所有的样本点。这是因为梯度是J(θ)的导数,而J(θ)是需要考虑所有样本的误差和 ,这个方法问题就是,扩展性问题,当样本点很大的时候,基本就没法算了。所以接下来又提出了随机梯度下降算法(stochastic gradient descent )。随机梯度下降算法,每次迭代只是考虑让该样本点的J(θ)趋向最小,而不管其他的样本点,这样算法会很快,但是收敛的过程会比较曲折,整体效果上,大多数时候它只能接近局部最优解,而无法真正达到局部最优解。所以适合用于较大训练集的case。
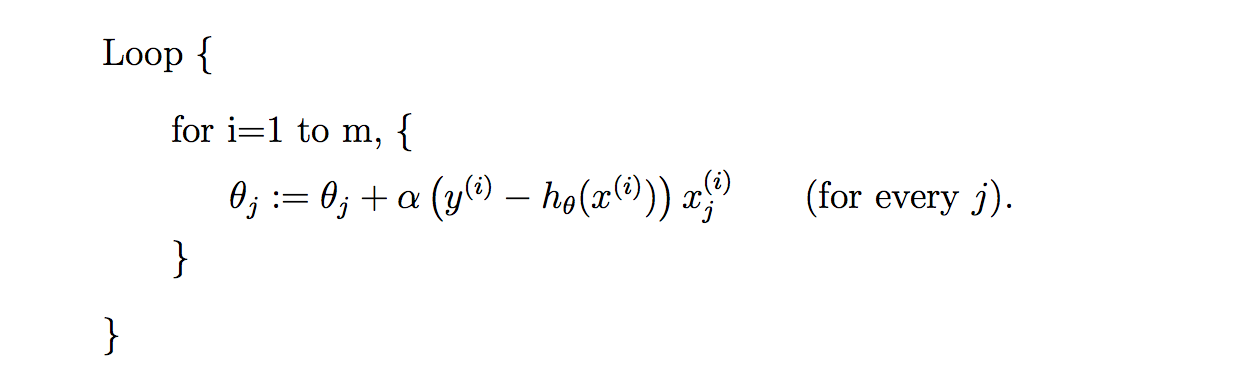
三.代码实现
随机梯度下降算法的python的实现:
 # coding=utf-8

 #!/usr/bin/python

 '''

 Created on 2014年9月6日

 @author: Ryan C. F.

 '''

 #Training data set

 #each element in x represents (x0,x1,x2)

 x = [(1,0.,3) , (1,1.,3) ,(1,2.,3), (1,3.,2) , (1,4.,4)]

 #y[i] is the output of y = theta0 * x[0] + theta1 * x[1] +theta2 * x[2]

 y = [95.364,97.217205,75.195834,60.105519,49.342380]

 epsilon = 0.0001

 #learning rate

 alpha = 0.01

 diff = [0,0]

 error1 = 0

 error0 =0

 m = len(x)

 #init the parameters to zero

 theta0 = 0

 theta1 = 0

 theta2 = 0

 while True:

     #calculate the parameters

     for i in range(m):

         diff[0] = y[i]-( theta0 + theta1 * x[i][1] + theta2 * x[i][2] )

         theta0 = theta0 + alpha * diff[0]* x[i][0]

         theta1 = theta1 + alpha * diff[0]* x[i][1]

         theta2 = theta2 + alpha * diff[0]* x[i][2]

     #calculate the cost function

     error1 = 0

     for lp in range(len(x)):

         error1 += ( y[i]-( theta0 + theta1 * x[i][1] + theta2 * x[i][2] ) )**2/2

     if abs(error1-error0) < epsilon:

         break

     else:

         error0 = error1

     print ' theta0 : %f, theta1 : %f, theta2 : %f, error1 : %f'%(theta0,theta1,theta2,error1)

 print 'Done: theta0 : %f, theta1 : %f, theta2 : %f'%(theta0,theta1,theta2)
批梯度下降算法
 # coding=utf-8

 #!/usr/bin/python

 '''

 Created on 2014年9月6日

 @author: Ryan C. F.

 '''

 #Training data set

 #each element in x represents (x0,x1,x2)

 x = [(1,0.,3) , (1,1.,3) ,(1,2.,3), (1,3.,2) , (1,4.,4)]

 #y[i] is the output of y = theta0 * x[0] + theta1 * x[1] +theta2 * x[2]

 y = [95.364,97.217205,75.195834,60.105519,49.342380]

 epsilon = 0.000001

 #learning rate

 alpha = 0.001

 diff = [0,0]

 error1 = 0

 error0 =0

 m = len(x)

 #init the parameters to zero

 theta0 = 0

 theta1 = 0

 theta2 = 0

 sum0 = 0

 sum1 = 0

 sum2 = 0

 while True:

     #calculate the parameters

     for i in range(m):

         #begin batch gradient descent

         diff[0] = y[i]-( theta0 + theta1 * x[i][1] + theta2 * x[i][2] )

         sum0 = sum0 + alpha * diff[0]* x[i][0]

         sum1 = sum1 + alpha * diff[0]* x[i][1]

         sum2 = sum2 + alpha * diff[0]* x[i][2]

         #end  batch gradient descent

     theta0 = sum0;

     theta1 = sum1;

     theta2 = sum2;

     #calculate the cost function

     error1 = 0

     for lp in range(len(x)):

         error1 += ( y[i]-( theta0 + theta1 * x[i][1] + theta2 * x[i][2] ) )**2/2

     if abs(error1-error0) < epsilon:

         break

     else:

         error0 = error1

     print ' theta0 : %f, theta1 : %f, theta2 : %f, error1 : %f'%(theta0,theta1,theta2,error1)

 print 'Done: theta0 : %f, theta1 : %f, theta2 : %f'%(theta0,theta1,theta2)
通过上述批梯度下降和随机梯度下降算法代码的对比,不难发现两者的区别:
1. 随机梯度下降算法在迭代的时候,每迭代一个新的样本,就会更新一次所有的theta参数。
35     for i in range(m):

36

37         diff[0] = y[i]-( theta0 + theta1 * x[i][1] + theta2 * x[i][2] )

38

39         theta0 = theta0 + alpha * diff[0]* x[i][0]

40         theta1 = theta1 + alpha * diff[0]* x[i][1]

41         theta2 = theta2 + alpha * diff[0]* x[i][2]
2. 批梯度下降算法在迭代的时候,是完成所有样本的迭代后才会去更新一次theta参数
35     #calculate the parameters

36     for i in range(m):

37         #begin batch gradient descent

38         diff[0] = y[i]-( theta0 + theta1 * x[i][1] + theta2 * x[i][2] )

39         sum0 = sum0 + alpha * diff[0]* x[i][0]

40         sum1 = sum1 + alpha * diff[0]* x[i][1]

41         sum2 = sum2 + alpha * diff[0]* x[i][2]

42         #end  batch gradient descent

43     theta0 = sum0;

44     theta1 = sum1;

45     theta2 = sum2;
因此当样本数量很大时候,批梯度得做完所有样本的计算才能更新一次theta,从而花费的时间远大于随机梯度下降。但是随机梯度下降过早的结束了迭代,使得它获取的值只是接近局部最优解,而并非像批梯度下降算法那么是局部最优解。
因此我觉得以上的差别才是批梯度下降与随机梯度下降最本质的差别。
机器学习(1)之梯度下降(gradient descent)的更多相关文章
- 梯度下降(Gradient Descent)小结 -2017.7.20
在求解算法的模型函数时,常用到梯度下降(Gradient Descent)和最小二乘法,下面讨论梯度下降的线性模型(linear model). 1.问题引入 给定一组训练集合(training se ...
- 梯度下降(gradient descent)算法简介
梯度下降法是一个最优化算法,通常也称为最速下降法.最速下降法是求解无约束优化问题最简单和最古老的方法之一,虽然现在已经不具有实用性,但是许多有效算法都是以它为基础进行改进和修正而得到的.最速下降法是用 ...
- 机器学习中的数学(1)-回归(regression)、梯度下降(gradient descent)
版权声明: 本文由LeftNotEasy所有,发布于http://leftnoteasy.cnblogs.com.如果转载,请注明出处,在未经作者同意下将本文用于商业用途,将追究其法律责任. 前言: ...
- (二)深入梯度下降(Gradient Descent)算法
一直以来都以为自己对一些算法已经理解了,直到最近才发现,梯度下降都理解的不好. 1 问题的引出 对于上篇中讲到的线性回归,先化一个为一个特征θ1,θ0为偏置项,最后列出的误差函数如下图所示: 手动求解 ...
- CS229 2.深入梯度下降(Gradient Descent)算法
1 问题的引出 对于上篇中讲到的线性回归,先化一个为一个特征θ1,θ0为偏置项,最后列出的误差函数如下图所示: 手动求解 目标是优化J(θ1),得到其最小化,下图中的×为y(i),下面给出TrainS ...
- 梯度下降(Gradient descent)
首先,我们继续上一篇文章中的例子,在这里我们增加一个特征,也即卧室数量,如下表格所示: 因为在上一篇中引入了一些符号,所以这里再次补充说明一下: x‘s:在这里是一个二维的向量,例如:x1(i)第i间 ...
- 回归(regression)、梯度下降(gradient descent)
本文由LeftNotEasy所有,发布于http://leftnoteasy.cnblogs.com.如果转载,请注明出处,在未经作者同意下将本文用于商业用途,将追究其法律责任. 前言: 上次写过一篇 ...
- 吴恩达深度学习:2.3梯度下降Gradient Descent
1.用梯度下降算法来训练或者学习训练集上的参数w和b,如下所示,第一行是logistic回归算法,第二行是成本函数J,它被定义为1/m的损失函数之和,损失函数可以衡量你的算法的效果,每一个训练样例都输 ...
- (3)梯度下降法Gradient Descent
梯度下降法 不是一个机器学习算法 是一种基于搜索的最优化方法 作用:最小化一个损失函数 梯度上升法:最大化一个效用函数 举个栗子 直线方程:导数代表斜率 曲线方程:导数代表切线斜率 导数可以代表方向, ...
随机推荐
- Git 的优点
1. 快速 如果你每移动一下鼠标都要等待五秒,是不是很受不了?版本控制也是一样的,每一个命令多那么几秒钟,一天下来也会浪费你不少时间.Git的操作非常快速,你可以把时间用在别的更有意义的地方. 2. ...
- JVM 调优
JVM内存,由三个部分构成 年轻代+老年代+永久代: 需要调试的是年轻代和老年代 的参数: 先解释几个JVM参数: -XMx : 最大可用内存: -Xms:初始化内存: -xss: 线程栈 的大小: ...
- system2之:4-文件系统管理(上)
文件系统 一.文件系统的作用 管理文件和目录的一套机制 1.文件存取 2.文件的查找 3.文件的大小.文件的多少. 4.一个目录可以存放多少个文件 5.文件的命名 6.一个分区可以多大 等 ...
- java——递归调用
递归函数调用调用本身,并通过自己的相应参数,这个计算过程中进行层,直到满足某些条件,只要停止呼叫. 递归函数的特点 1.函数要直接或间接调用自身. 2.要有递归终止条件检查.即递归终止的条件被满足后. ...
- qt优点
(1)优良的跨平台特性. Qt支持下列操作系统:Microsoft Windows 95/98.Microsoft Windows NT.Linux.Solaris.SunOS.HP-UX.Digi ...
- 黑白图像(DFS)
输入一个n*n的黑白图像(1表示黑色,0表示白色),任务是统计其中八连块的个数.如果两个黑格子有公共边或者公共顶点,就说它们属于同一个八连块.如图6-11所示的图形有3个八连块. 图6-11 拥有3 ...
- 开发环境下jboss 7.1.1 Final 的jsp热部署解决方案--转
公司的网站系统使用的中间是jboss7.1.1 Final,由于有些数据和服务测试环境不具备,免不了要在测试环境调试些jsp页面,发现从jboss社区里下载的jboss应用有个问题,新增jsp页面会实 ...
- linux之CentOS-7.0环境搭建
此文作为新手安装centos-7的图文教程. 一. 前言 最近,师兄要进行实验室架构搭建,需要学习docker.而docker是完全依赖于linux系统的.所以,有了这篇文章. linux有很多发 ...
- Python之路,Day19 - CMDB、CMDB、CMDB
Python之路,Day19 - CMDB.CMDB.CMDB 本节内容 浅谈ITIL CMDB介绍 Django自定义用户认证 Restful 规范 资产管理功能开发 浅谈ITIL TIL即IT ...
- OC中的单例设计模式及单例的宏抽取
// 在一个对象需要重复使用,并且很频繁时,可以对对象使用单例设计模式 // 单例的设计其实就是多alloc内部的allocWithZone下手,重写该方法 #pragma Person.h文件 #i ...