
爬虫再探实战(三)———爬取动态加载页面——selenium
自学python爬虫也快半年了,在目前看来,我面临着三个待解决的爬虫技术方面的问题:动态加载,多线程并发抓取,模拟登陆。目前正在不断学习相关知识。下面简单写一下用selenium处理动态加载页面相关的知识。目标——抓取页面所有的高考录取分数信息。
对于动态加载,开始的时候是看到Selenium+Phantomjs的强大,直接就学的这个。打开网页查看网页源码(注意不是检查元素)会发现要爬取的信息并不在源码里面。也就是说,从网页源码无法通过解析得到数据。Selenium+Phantomjs的强大一方面就在于能将完整的源码抓取到,上代码。
from selenium import webdriver

def get_grade(url):

    print(url)

    #匿名爬虫

    #假定9999端口开启tor服务

    service_args = ['--proxy=localhost:9999', '--proxy-type=socks5', ]

    driver = webdriver.PhantomJS(executable_path=这里是PhantomJS的绝对路径)

    driver.get(url)

    data = driver.page_source

    print(data)

get("http://gkcx.eol.cn/soudaxue/queryProvince.html?page=1")
这里还用到了匿名爬虫,这里呢我也只是到了能用的水平,具体原理还不太懂。。。这样就能拿到完整的源码,是不是很简单呢?当然简单啦,不过简单的代价就是牺牲速度。
这个程序还不算复杂,当抓取量大的时候,模拟抓取的效率就会变得很低(还不会多线程。。。不知道用多线程能不能提速)。下面是此项目的完整代码:
import xlsxwriter

from selenium import webdriver

from bs4 import BeautifulSoup

def get_grade(url):

    print(url)

    #匿名爬虫

    #假定9999端口开启tor服务

    service_args = ['--proxy=localhost:9999', '--proxy-type=socks5', ]

    driver = webdriver.PhantomJS(executable_path=r"F:\Techonolgoy\Python\file\spider\spider_tools\JS\1\phantomjs.exe")

    driver.get(url)

    data = driver.page_source

    # print(data)

    soup = BeautifulSoup(data, 'lxml')

    grades = soup.find_all('tr')

    for grade in grades:

        global i

        if '<td>' in str(grade):

            i += 1

            print(i)

            grade_text =grade.get_text()

            print(grade_text)

            grade_text = str(grade_text)

            city = grade_text[:-13]

            worksheet.write(i,0,city)

            time = grade_text[-13:-9]

            worksheet.write(i,1,time)

            subs = grade_text[-9:-7]

            worksheet.write(i,2,subs)

            s = grade_text[-7:-3]

            worksheet.write(i,3,s)

            grade = grade_text[-3:]

            worksheet.write(i,4,grade)

i = -1

workbook = xlsxwriter.Workbook('grades.xlsx')

worksheet = workbook.add_worksheet()

worksheet.set_column('A:A',10)

worksheet.set_column('B:B', 10)

worksheet.set_column('C:C', 10)

worksheet.set_column('D:D', 10)

worksheet.set_column('E:E', 10)

urls = ['http://gkcx.eol.cn/soudaxue/queryProvince.html?page='+str(num)

        for num in range(1,166)]

for url in urls:

    get_grade(url)

workbook.close()
家里面网速太慢,一共用了20分钟才爬取完毕。。。抓取到的EXCEL文件格式如下:
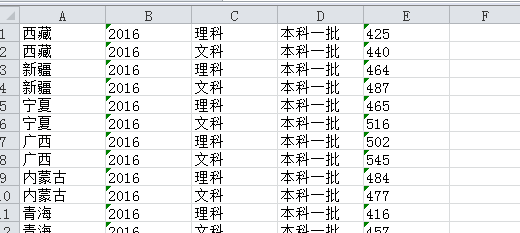
我是被这模拟抓取的龟速折磨的够心累的,所以,经大牛们指点,找到了处理这类问题的另一个方法——直接清求json文件获取数据!这个放到下面再写。
爬虫再探实战(三)———爬取动态加载页面——selenium的更多相关文章
- Python+Selenium爬取动态加载页面(2)
注: 上一篇<Python+Selenium爬取动态加载页面(1)>讲了基本地如何获取动态页面的数据,这里再讲一个稍微复杂一点的数据获取全国水雨情网.数据的获取过程跟人手动获取过程类似,所 ...
- Python+Selenium爬取动态加载页面(1)
注: 最近有一小任务,需要收集水质和水雨信息,找了两个网站:国家地表水水质自动监测实时数据发布系统和全国水雨情网.由于这两个网站的数据都是动态加载出来的,所以我用了Selenium来完成我的数据获取. ...
- 爬虫再探实战(四)———爬取动态加载页面——请求json
还是上次的那个网站,就是它.现在尝试用另一种办法——直接请求json文件,来获取要抓取的信息. 第一步,检查元素,看图如下: 过滤出JS文件,并找出包含要抓取信息的js文件,之后就是构造request ...
- Scrapy 框架 使用 selenium 爬取动态加载内容
使用 selenium 爬取动态加载内容 开启中间件 DOWNLOADER_MIDDLEWARES = { 'wangyiPro.middlewares.WangyiproDownloaderMidd ...
- C#使用phantomjs,爬取AJAX加载完成之后的页面
1.开发思路:入参根据apiSetting配置文件,分配静态文件存储地址,可实现不同站点的静态页生成功能.静态页生成功能使用无头浏览器生成,生成之后的字符串进行正则替换为固定地址,实现本地正常访问. ...
- ExtJS 4.1 TabPanel动态加载页面并执行脚本【转】
ExtJS 4.1 TabPanel动态加载页面并执行脚本 按照官方示例,可以动态加载页面,可是脚本不执行,于是查SDK.google,发现scripts需要设置为true,于是设置该属性,整个代码如 ...
- 记录Js动态加载页面.append、html、appendChild、repend添加元素节点不生效以及解决办法
今天再优化blog页面的时候添加了个关注按钮和图片,但是页面上这个按钮和图片时有时无,本来是搞后端的,被这个前端的小问题搞得抓耳挠腮的! 网上各种查询解决方案,把我解决问题的艰辛历程分享出来,希望大家 ...
- div动态加载页面
div动态加载页面 /* /// method 1 var url="<%=basePath%>/qne.do?p=pessegerCountSet"; $.post( ...
- Python 爬虫实例(8)—— 爬取 动态页面
今天使用python 和selenium爬取动态数据,主要是通过不停的更新页面,实现数据的爬取,要爬取的数据如下图 源代码: #-*-coding:utf-8-*- import time from ...
随机推荐
- [ssc] 数据库管理工具——SQuirreL SQL Client使用入门
简单介绍: SQuirrel SQL Client是一个用Java写的数据库客户端,用JDBC统一数据库访问接口以后,可以通过一个统一的用户界面来操作MySQL PostgreSQL MSSQL Or ...
- html 标签总结
<q>标签,短文本引用 例如“聪明秀出为之英,胆略过人为之雄.” <blockquote>标签,长文本引用 <blockquote>标签的解析是缩进样式. 没有HT ...
- datagridview 中添加了一个button类型的列,怎么写button的事件
using System; using System.Collections.Generic; using System.ComponentModel; using System.Data; usin ...
- 给文本标签UILabel添加长按复制功能
http://www.111cn.net/sj/iOS/104236.htm http://blog.csdn.net/lrenjun/article/details/12582927 自定义一个可复 ...
- OC 继承子类对象调用方法机制 子类对象访问父类中的实例变量
在继承中,子类对象如何调用到正确方法的机制 每一个Objective - C对象都有一个隐藏的指针指向类的代码,当向一个对象发送消息的时候,当前的对象会首先在当前类里去查找相应的方法,如果找到的话,直 ...
- json2.js 使用
参考:http://www.cnblogs.com/youring2/archive/2013/03/01/2938850.html github地址:https://github.com/dougl ...
- Java 集合系列 12 TreeMap
java 集合系列目录: Java 集合系列 01 总体框架 Java 集合系列 02 Collection架构 Java 集合系列 03 ArrayList详细介绍(源码解析)和使用示例 Java ...
- smartGit30天试用过期
Windows: %APPDATA%\syntevo\SmartGit\OS X: ~/Library/Preferences/SmartGit/Unix/Linux: ~/.smartgit ...
- 【转】数据库范式(1NF 2NF 3NF BCNF)详解一
以下内容转自:http://jacki6.iteye.com/blog/774866 --------------------------------------------分割线---------- ...
- table表格
表格是一种组织整理的数据的手段,在div布局还未流行是,也用来布局,一个表格包含了表格整体.表格头部.每个表格均有若干行,每行被分为若干单元格. 在HTML中表格使用table标签来定义,行由< ...