
Deep Linear Networks with Arbitrary Loss: All Local Minima Are Global
问题
这篇文章是关于深度学习的一些理论分析.
假设这么一个网络:
\]
其中\(x\)是输入,\(W_k\)是第\(k\)层的权重,而\(\hat{y}\)是最后的输出. 没错,这篇文章研究的是深度线性网络的性质(没有激活函数). 当然,这样子,无论有多少层,这个网络最后是一个普通线性函数,所以,作者的本意应该只是借此来窥探深度学习的一些性质.
作者证明了,在满足一定条件下,这个深度线性网络,任何局部最优解都是全局最优解.
假设和重要结果
损失函数如此表示:
\]
假设
- \(d_k\)表示第\(k+1\)层的神经元个数,即\(d_0\)表示输入层的维度,\(W_k \in \mathbb{R}^{d_{k-1} \times d_k}\), \(d_L\)表示输出层的维度,
- \(d_k \ge \min \{d_0, d_L\}, 0 < k < L\),
- 损失函数关于\(\hat{y}\)凸且可微.
定理1:满足上面假设的深度线性网络,任意局部最优都是全局最优.
考虑下面问题p(2):
\]
并记\(A=W_LW_{L-1}\cdots W_1\).
则:
定理3:
假设\(f(A)\)是任意的可微函数,且满足:
\]
则关于p(2)的任意的极小值点\((\hat{W}_1, \ldots, \hat{W}_L)\),都将满足:
\]
证明
注意到, 可表示成:
\]
则\(f(A)\)是关于\(A\)的凸的可微函数(注意是关于\(A\)), 所以,当\(\nabla f(\hat{A})=0\)的时候,\(\hat{A}\)便是\(f\),即\(\mathcal{L}\)得最小值点. 这意味着,只要我们证明了定理3,也就证明了定理1.
下证定理3:
首先定义:
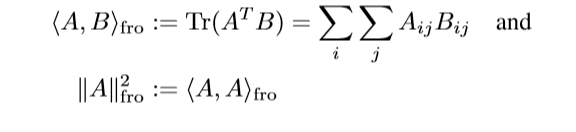
记:
\]
容易证明(这部分论文中也给出了证明,不在此贴出):
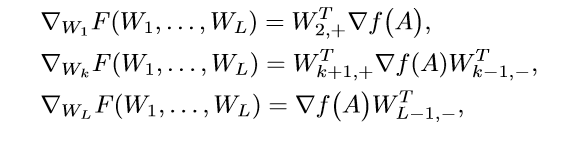
其中:
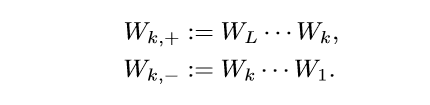
不失一般性,假设\(d_L\ge d_0\), 因为令:
\]
则,\(g\)定义在\(d_0 \times d_L\)之上,且\(A^T\)使得\(f\)为极小值,当且仅当\(A\)使得\(g\)为极小值,所以\(d_0, d_L\)的地位是相同的,我们可以直接假设\(d_L \ge d_0\).
\((\hat{W}_1, \ldots, \hat{W}_L)\)是最小值点,则存在\(\epsilon>0\), 使得满足:
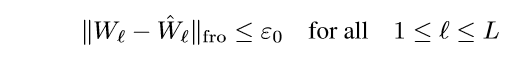
的点满足:
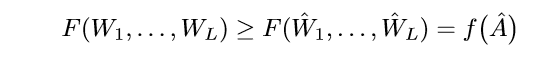
于是:
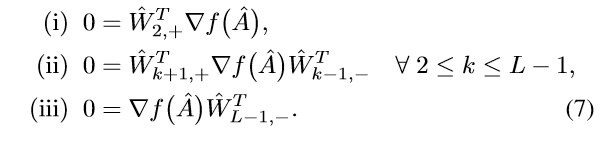
当\(\mathrm{ker}(\hat{W}_{L-1}) = \{0\}\)的时候:
\]
于是只要证明, \(\ker(\hat{W}_{L-1}) = \not \{0\}\)的时候,上式也成立即可.
我们的想法是构造一族极小值点, 满足:
\]
通过一些性质,推出\(\nabla f(\hat{A})=0\).
首先证明,满足:
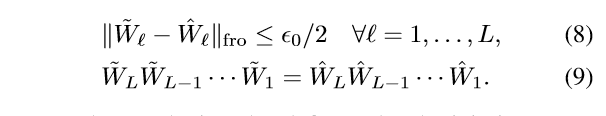
的点都是极小值点.
因为:
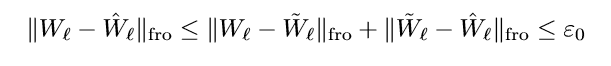
所以:
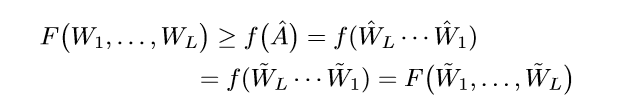
所以\((\tilde{W}_1, \ldots, \tilde{W}_L)\)也是一个极小值点.
那么如何来构造呢?
可知:
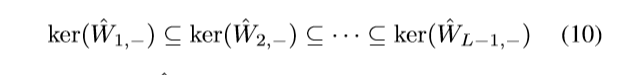
对\(\hat{W}_{k, -}\)进行奇异值分解:
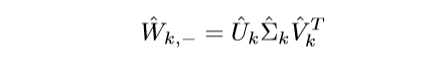
因为\(d_k \ge d_0, k\ge1\), 所以其分解是这样的:
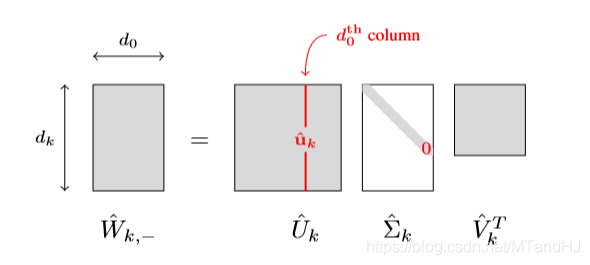
注意到,这里体现了为什么需要\(d_k\ge \min \{d_L, d_0\}\), 否则\(\mathrm{ker}(\hat{W}_{k, -})\)不可能等于\(\{0\}\)(因为其秩永远小于\(d_0\)).
假设\(k_*\)是第一个\(\mathrm{ker}(\hat{W}_{k, -}) = \not\{0\}\)的,则下面的构造便是我们所需要的:
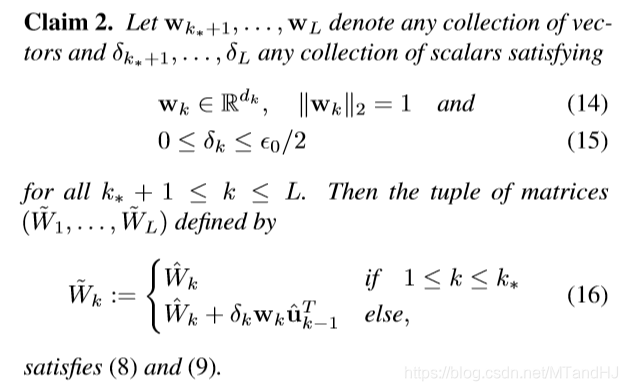
其中\(\hat{u}_{k-1}\)表示\(\hat{W}_{k-1, -}\)奇异值分解\(\hat{U}_{k-1}\)的\(d_0\)列, 很明显,满足\(\hat{u}_{k-1}^T\hat{W}_{k-1,-}=0, k\ge k^* + 1\).
条件(8)容易证明,用数学归纳法证明(9):
第一项成立,假设第\(k\)项也成立, 于是

也成立,所以条件成立.
既然满足其构造方式的所有点都是点都是极小值点,那么:
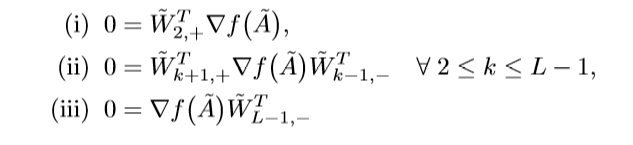
注意,对所有的满足条件的\(\delta_k, w_k\)都成立.
\(k_* > 1\)的时候可得:
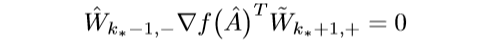
又\(\mathrm{ker}(\hat{W}_{k_*-1,-})=\{0\}\), 所以:
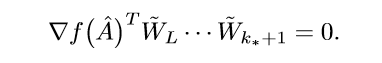
注意到\(k_*=1\)的时候,也有上面的形式.
首先,令\(\delta_{k_*+1}=0\), 则\(\tilde{W}_{k_*+1}=\hat{W}_{k_*+1}\), 于是:
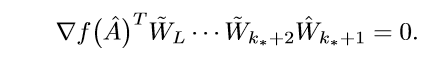
在去任意\(\delta_{k_*+1} > 0\), 与上式作差可得:
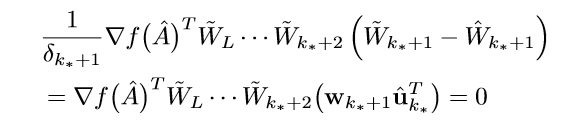
俩边同乘上\(\hat{u}_{k_*}^T\)可得:
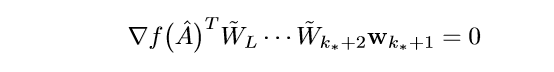
因为\(w_{k_*+1}\)是任意的,所以,左端为0,以此类推,最后可得:
\]
证毕.
注
我没有把定理2放上来.
有一个方向,定理3中的极小值点改成极大值点,似乎定理也成立,即:
假设\(f(A)\)是任意的可微函数,且满足:
\]
则关于p(2)的任意的极大值点\((\hat{W}_1, \ldots, \hat{W}_L)\),都将满足:
\]
我自己仿照论文的证明是可以证明出来的,不过,既然\(\nabla f(\hat{A})=0\), 那么\(\hat{A}\)依然是\(\mathcal{L}\)的最小值点,是不是可以这么认为,\(f\)压根没有存粹的极大值点.
另外作者指出,极小值点不能改为驻点,因为\(A=0\)便是一个驻点,但是没有\(f(0)\)必须为0的规定.
此外作者还说明了,为什么要可微等等原因,详情回见论文.
Deep Linear Networks with Arbitrary Loss: All Local Minima Are Global的更多相关文章
- Must Know Tips/Tricks in Deep Neural Networks
Must Know Tips/Tricks in Deep Neural Networks (by Xiu-Shen Wei) Deep Neural Networks, especially C ...
- Must Know Tips/Tricks in Deep Neural Networks (by Xiu-Shen Wei)
http://lamda.nju.edu.cn/weixs/project/CNNTricks/CNNTricks.html Deep Neural Networks, especially Conv ...
- Training (deep) Neural Networks Part: 1
Training (deep) Neural Networks Part: 1 Nowadays training deep learning models have become extremely ...
- [C4] Andrew Ng - Improving Deep Neural Networks: Hyperparameter tuning, Regularization and Optimization
About this Course This course will teach you the "magic" of getting deep learning to work ...
- Training Deep Neural Networks
http://handong1587.github.io/deep_learning/2015/10/09/training-dnn.html //转载于 Training Deep Neural ...
- Introduction to Deep Neural Networks
Introduction to Deep Neural Networks Neural networks are a set of algorithms, modeled loosely after ...
- Classifying plankton with deep neural networks
Classifying plankton with deep neural networks The National Data Science Bowl, a data science compet ...
- [CVPR 2016] Weakly Supervised Deep Detection Networks论文笔记
p.p1 { margin: 0.0px 0.0px 0.0px 0.0px; font: 13.0px "Helvetica Neue"; color: #323333 } p. ...
- Coursera Deep Learning 2 Improving Deep Neural Networks: Hyperparameter tuning, Regularization and Optimization - week1, Assignment(Initialization)
声明:所有内容来自coursera,作为个人学习笔记记录在这里. Initialization Welcome to the first assignment of "Improving D ...
随机推荐
- Lock锁的使用
在Java多线程中,可以使用synchronized关键字实现线程之间的同步互斥,在jdk1.5后新增的ReentrantLock类同样可达到此效果,且在使用上比synchronized更加灵活. 观 ...
- 一、手把手教你docker搭建fastDFS文件上传下载服务器
在搭建fastDFS文件上传下载服务器之前,你需要准备的有一个可连接的linux服务器,并且该linux服务器上已经安装了docker,若还有没安装docker的,先百度自行安装docker. 1.执 ...
- excel数据导入mySql数据库
1.将excel数据保存好 2.打开数据库,在表上点击右键,选择导入向导 3.点击下图中红色部门,点击下一步 4.选择excel文件的位置,下方的表空间内,会出现excel中的sheet页,选择要导入 ...
- SharedWorker实现多标签页联动计时器
web workers对于每个前端开发者并不陌生,在mdn中的定义:Web Worker为Web内容在后台线程中运行脚本提供了一种简单的方法.线程可以执行任务而不干扰用户界面.此外,他们可以使用XML ...
- Redis cluster 集群命令合集
目录 一.常用命令 二.操作命令 三.redis-trib.rb脚本 一.常用命令 打印集群的信息 CLUSTER INFO 列出集群当前已知的所有节点(node),以及这些节点的相关信息. CLUS ...
- 服务器安装Centos7
目录 一.安装 一.安装 1.开启虚拟机后会出现以下界面 Install CentOS 7 安装CentOS 7 Test this media & install CentOS 7 测试安装 ...
- ORA-31633:unable to create master table "DP.SYS_EXPORT_FULL_11" ORA-01658
问题描述:在进行数据泵进行数据库备份的时候,但是导出命令报错,环境是19C 4节点的rac 一体机.目前磁盘空间需要清理,清理之前先备份一下数据库 ORA-31626:job does not exi ...
- mobile app 与server通信的四种方式
Have you ever wondered how the information gets into the application installed in your mobile device ...
- CF363A Soroban 题解
Content 给出一个数 \(n\),请你用算盘来表示 \(n\). 这里的算盘和普通的算盘一样,只不过竖着摆放罢了.左边只有一个珠子,每个珠子表示 \(5\):右边有四个珠子,每个珠子表示 \(1 ...
- CF699A Launch of Collider 题解
Content 有 \(n\) 辆车在一条数轴上,第 \(i\) 辆车在 \(a_i\) 上,每辆车要么向左,要么向右.开始,它们以 \(1\) 个单位每秒的速度在行驶.问你第一次撞车发生在第几秒的时 ...