
[python]初试页面抓取——抓取沪深股市交易龙虎榜数据
[python]抓取沪深股市交易龙虎榜数据
python 3.5.0下运行
没做自动建立files文件夹,需要手动在py文件目录下建立files文件夹后运行
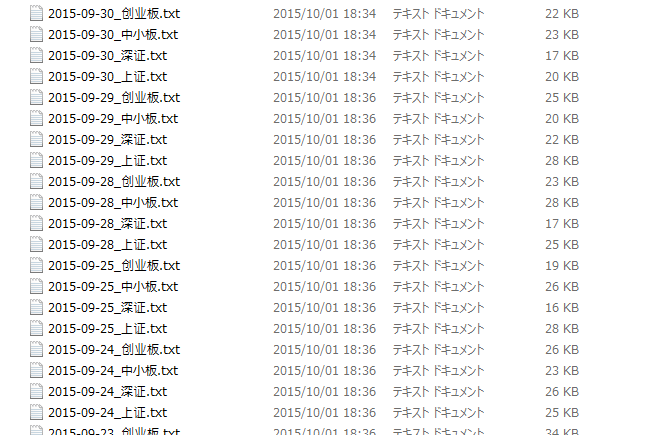
#coding=utf-8

import gzipimport http.cookiejar

import urllib.request

import urllib.parse

import json

import os

import time

import datetime

def getOpener(head):

    # deal with the Cookies

    cj = http.cookiejar.CookieJar()

    pro = urllib.request.HTTPCookieProcessor(cj)

    opener = urllib.request.build_opener(pro)

    header = []

    for key, value in head.items():

        elem = (key, value)

        header.append(elem)

    opener.addheaders = header

    return opener

def ungzip(data):

    try:        # 尝试解压

        print('正在解压.....')

        data = gzip.decompress(data)

        print('解压完毕!')

    except:

        print('未经压缩, 无需解压')

    return datadef writeFile(fname,data):

    filename = r'files/'+fname+'.txt'

    if os.path.exists(filename):

        message = '文件 + '+filename +' 已存在,跳过'

    else:

        message = '文件 + '+filename +' 不存在,新建'

        f=open(filename,'w')

        f.write(data)

        f.close()

    print ('文件:'+fname+' 处理完毕。')

'''

读取抓取数据开始日期

如果不存在该日期,从10日前开始读取

如果存在从文件内日期开始读取

读到今天

'''

header = {

    'Connection': 'Keep-Alive',

    'Accept': '*/*',

    'Accept-Language': 'zh-CN,zh;q=0.8',

    'User-Agent': 'Mozilla/5.0 (Windows NT 6.2) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/40.0.2214.111 Safari/537.36',

    'Accept-Encoding': 'gzip, deflate',

    'Host': '',

    'Referer' : ''

}

shUrl = 'http://query.sse.com.cn/infodisplay/showTradePublicFile.do?dateTx='#2015-09-28

szUrl = ['http://www.szse.cn/szseWeb/common/szse/files/text/jy/jy',#150923.txt

         'http://www.szse.cn/szseWeb/common/szse/files/text/smeTxt/gk/sme_jy',#150708.txt

         'http://www.szse.cn/szseWeb/common/szse/files/text/nmTxt/gk/nm_jy']#150902.txt

startFileName = r'startDay.txt'

endDay = datetime.datetime.now()

if os.path.exists(startFileName):

    print('日期配置文件存在,开始读取')

    f=open(startFileName,'rt')

    s = f.readline()

    f.close()

    if s!='':

        print('将从日期:'+s+' 开始读取')

        timeArray = time.strptime(s, "%Y%m%d")

        timeStamp = int(time.mktime(timeArray))

        fromDay = datetime.datetime.utcfromtimestamp(timeStamp)

    else:

        print('日期配置文件为空,将从10日前日期开始读取')

        fromDay = endDay - datetime.timedelta(days = 10)

else:

    print('日期配置文件不存在,将从10日前日期开始读取')

    fromDay = endDay - datetime.timedelta(days = 10)

endDay = endDay + datetime.timedelta(days = 1)

while fromDay.strftime("%Y%m%d")!=endDay.strftime("%Y%m%d"):

    print(fromDay.strftime("%Y%m%d"))

    '''

    循环上面日期

    抓取上证,深证,中小创交易龙虎榜数据

    如果内容不为空

    文件不存在

    写入文件

    '''

    #抓取上证龙虎榜数据

    url = shUrl + fromDay.strftime("%Y-%m-%d")

    print('读取上证龙虎榜\n'+url)

    header['Host'] = 'query.sse.com.cn'

    header['Referer'] = 'http://www.sse.com.cn/disclosure/diclosure/public/'

    try:

        opener = getOpener(header)

        op = opener.open(url)

        data = op.read()

        data = data.decode()

        jsonData = json.loads(data)

        outData = ''

        if (jsonData['fileContents']!=''):

            for info in jsonData['fileContents']:

                outData= outData+ info+'\n'

            writeFile(fromDay.strftime("%Y-%m-%d")+'_上证',outData)

    except:

        print(fromDay.strftime("%Y-%m-%d")+'跳过')

    #抓取深证,中小创交易龙虎榜数据

    i=1

    for url in szUrl:

        if(i==1):

            name = '深证'

        elif(i==2):

            name = '中小板'

        else:

            name = '创业板'

        url = url + fromDay.strftime("%y%m%d")+'.txt'

        print('读取'+name+'龙虎榜\n'+url)

        header['Host'] = 'www.szse.cn'

        header['Referer'] = 'http://www.szse.cn'

        try:

            opener = getOpener(header)

            op = opener.open(url)

            data = op.read()

            data = ungzip(data)

            data = data.decode('gbk')

            writeFile(fromDay.strftime("%Y-%m-%d")+'_'+name,data)

        except:

            print(fromDay.strftime("%Y-%m-%d")+'跳过')

        i=i+1

    fromDay = fromDay + datetime.timedelta(days = 1)

#最后更新日期为当前日期

print('设置最新日期')

fromDay = fromDay - datetime.timedelta(days = 1)

f=open(startFileName,'w')

f.write(fromDay.strftime("%Y%m%d"))

f.close()

print('读取完成')
[python]初试页面抓取——抓取沪深股市交易龙虎榜数据的更多相关文章
- python调用tushare获取沪深A股票资金流向数据
接口:moneyflow 描述:获取沪深A股票资金流向数据,分析大单小单成交情况,用于判别资金动向 限量:单次最大提取4000行记录,总量不限制 积分:用户需要至少1500积分才可以调取,基础积分有流 ...
- [python]数据整理,将取得的众多的沪深龙虎榜数据整一整
将昨日取得的众多的沪深龙虎榜数据整一整 提取文件夹内所有抓取下来的沪深龙虎榜数据,整理出沪深两市(含中小创)涨幅榜股票及前5大买入卖出资金净值,保存到csv文件 再手动使用数据透视表进行统计 原始数据 ...
- python爬虫beta版之抓取知乎单页面回答(low 逼版)
闲着无聊,逛知乎.发现想找点有意思的回答也不容易,就想说要不写个爬虫帮我把点赞数最多的给我搞下来方便阅读,也许还能做做数据分析(意淫中--) 鉴于之前用python写爬虫,帮运营人员抓取过京东的商品品 ...
- python爬虫之分析Ajax请求抓取抓取今日头条街拍美图(七)
python爬虫之分析Ajax请求抓取抓取今日头条街拍美图 一.分析网站 1.进入浏览器,搜索今日头条,在搜索栏搜索街拍,然后选择图集这一栏. 2.按F12打开开发者工具,刷新网页,这时网页回弹到综合 ...
- Python爬虫实战四之抓取淘宝MM照片
原文:Python爬虫实战四之抓取淘宝MM照片其实还有好多,大家可以看 Python爬虫学习系列教程 福利啊福利,本次为大家带来的项目是抓取淘宝MM照片并保存起来,大家有没有很激动呢? 本篇目标 1. ...
- Python爬虫实战六之抓取爱问知识人问题并保存至数据库
大家好,本次为大家带来的是抓取爱问知识人的问题并将问题和答案保存到数据库的方法,涉及的内容包括: Urllib的用法及异常处理 Beautiful Soup的简单应用 MySQLdb的基础用法 正则表 ...
- 一次Python爬虫的修改,抓取淘宝MM照片
这篇文章是2016-3-2写的,时隔一年了,淘宝的验证机制也有了改变.代码不一定有效,保留着作为一种代码学习. 崔大哥这有篇>>小白爬虫第一弹之抓取妹子图 不失为学python爬虫的绝佳教 ...
- 用python的requests第三方模块抓取王者荣耀所有英雄的皮肤
本文使用python的第三方模块requests爬取王者荣耀所有英雄的图片,并将图片按每个英雄为一个目录存入文件夹中,方便用作桌面壁纸 下面时具体的代码,已通过python3.6测试,可以成功运行: ...
- 利用python脚本(xpath)抓取数据
有人会问re和xpath是什么关系?如果你了解js与jquery,那么这个就很好理解了. 上一篇:利用python脚本(re)抓取美空mm图片 # -*- coding:utf-8 -*- from ...
随机推荐
- This build of Sublime Text 2 has expired
使用一直很好的 sublime 2 最近一直提示: This build of Sublime Text 2 has expired, please update to a newer one fro ...
- Sql Server系列:视图
视图是数据库中的一种虚拟表,与真实的表一样,视图包含一系列带有名称的行和列数据.行和列数据用来自定义视图的查询所引用的表,并且在引用视图时动态生成. 1. 视图的概念 视图是从一个或者多个表中导出的, ...
- 认识AMD、CMD、UMD、CommonJS
0.导言 JavaScript的生态系统一直在稳步增长,当各种组件混合使用时,就可能会发现不是所有的组件都能“和平共处”,为了解决这些问题,各种模块规范就出来了. 1.AMD(Asynchromous ...
- android图片透明度跟缩放大小动画事件
概序 : 动画事件写在xml中,然后用AnimationUtils去加载动画事件,再监听动画结束事件,隐藏imageview. 1. player_double_click_animation.xml ...
- ASP.NET:在一般处理程序中通过 Session 保存验证码却无法显示图片?
using System.Drawing; using System.Web; using System.Web.SessionState; /// <summary> /// Captc ...
- ASP.NET sync over async(异步中同步,什么鬼?)
async/await 是我们在 ASP.NET 应用程序中,写异步代码最常用的两个关键字,使用它俩,我们不需要考虑太多背后的东西,比如异步的原理等等,如果你的 ASP.NET 应用程序是异步到底的, ...
- ASP.NET Web API 创建帮助页
1. 安装 Microsoft.AspNet.WebApi.HelpPage 程序包 Install-Package Microsoft.AspNet.WebApi.HelpPage 2. 注册 Ar ...
- C# 将PowerPoint文件转换成PDF文件
PowerPoint的优势在于对演示文档的操作上,而用PPT查看资料,反而会很麻烦.这时候,把PPT转换成PDF格式保存,再浏览,不失为一个好办法.在日常编程中和开发软件时,我们也有这样的需要.本文旨 ...
- PC网站CSS分享
这里想总结些编写网页的经验,以PC端的为主,前面总结过后台的,今天写些前台的,参考了bootstrap3.3.5.bootstrip2.3.2和模版matrix. 前段时间还写过一篇<前端基础学 ...
- 简析Geoserver中获取图层列表以及各图层描述信息的三种方法
文章版权由作者李晓晖和博客园共有,若转载请于明显处标明出处:http://www.cnblogs.com/naaoveGIS/. 1.背景 实际项目中需要获取到Geoserver中的图层组织以及各图层 ...