
课程回顾-Improving Deep Neural Networks: Hyperparameter tuning, Regularization and Optimization
划分的量
要保证数据来自一个分布
偏差方差分析
如果存在high bias
如果存在high variance
正则化
正则化减少过拟合的intuition
Dropout
dropout分析
其它正则化方法
数据增加(data augmentation)
early stopping
ensemble
归一化输入
归一化可以加速训练
归一化的步骤
归一化应该应用于:训练、验证、测试
梯度消失/爆炸
权重初始化
通过数值近似计算梯度
优化算法
mini-batch
momentum
RMSprop
Adam
调参
顺序
批规范化Batch Normalization
Reference
训练、验证、测试
划分的量
- If size of the dataset is 100 to 1000000 ==> 60/20/20
- If size of the dataset is 1000000 to INF ==> 98/1/1 or 99.5/0.25/0.25
要保证数据来自一个分布
偏差方差分析
如果存在high bias
- 尝试用更大的网络
- 尝试换一个网络模型
- 跑更长的时间
- 换不同的优化算法
如果存在high variance
- 收集更多的数据
- 尝试正则化方法
- 尝试一个不同的模型
如果存在high bias
- 尝试用更大的网络
- 尝试换一个网络模型
- 跑更长的时间
- 换不同的优化算法
如果存在high variance
- 收集更多的数据
- 尝试正则化方法
- 尝试一个不同的模型
一般来说更大的网络更好
正则化
正则化减少过拟合的intuition
太大会导致其为0
Dropout
- 原始的dropout
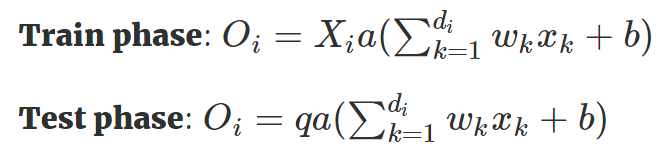
- Inverted Dropout
我们稍微将 Dropout 方法改进一下,使得我们只需要在训练阶段缩放激活函数的输出值,而不用在测试阶段改变什么。这个改进的 Dropout 方法就被称之为 Inverted Dropout 。比例因子将修改为是保留概率的倒数,即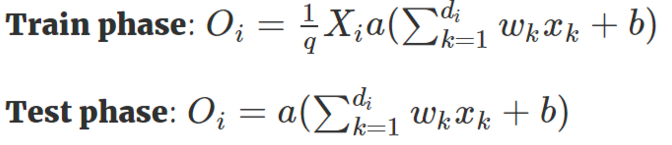
dropout分析
- 因为我们不能够过分依赖一个特征,dropout可以一定程度将权重分出去
- 我们可以在不同的层设置不同的dropout
- 输入层的dropout应该接近1,因为我们需要从中学习信息
- CNN中dropout广泛应用
- dropout带来的问题是调试困难,通常我们需要关掉dropout调试,确认无误再继续用dropout
其它正则化方法
数据增加(data augmentation)
我们稍微将 Dropout 方法改进一下,使得我们只需要在训练阶段缩放激活函数的输出值,而不用在测试阶段改变什么。这个改进的 Dropout 方法就被称之为 Inverted Dropout 。比例因子将修改为是保留概率的倒数,即
数据增加(data augmentation)
就是通过一些变换得到新的图片(这种其实是在图像领域最为广泛应用,但是思想可以推广)
early stopping
就是在迭代中选择验证错误不再降低的点
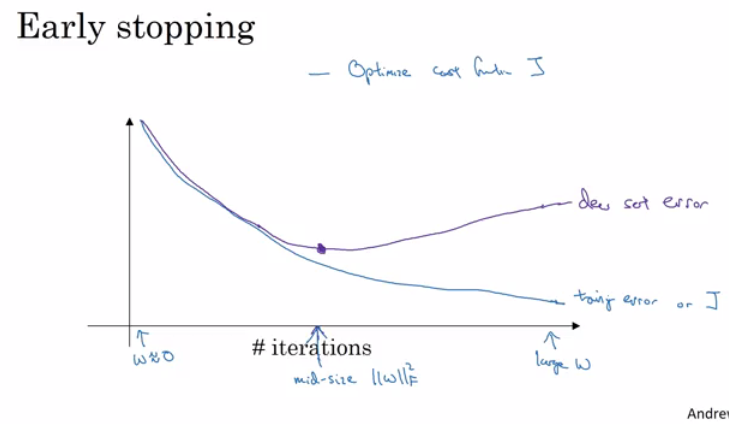
好处是不用调超参,坏处是it makes us think about something else more than optimize W's and b's.
ensemble
训练多个模型,组合
可以带来2%左右的提升,减少泛化误差
归一化输入
归一化可以加速训练
归一化的步骤
- 计算均值
- 所有数据减去均值
- 计算方差
x/=variance
归一化应该应用于:训练、验证、测试
梯度消失/爆炸
x/=variance这是训练深度学习难的一个点
权重初始化
是解决梯度消失/爆炸的一个部分的解决方案
对于sigmoid和tanh
np.random.rand(shape)*np.sqrt(1/n[l-1]) 对于relu
np.random.rand(shape)*np.sqrt(2/n[l-1]) #n[l-1] In the multiple layers.一个方差是1/Nx" role="presentation" style="font-size: 100%; display: inline-block; position: relative;">1/Nx,另一个是2/Nx" role="presentation" style="font-size: 100%; display: inline-block; position: relative;">2/Nx
通过数值近似计算梯度
- 注意添加正则项的损失函数
优化算法
mini-batch
- 为了利用向量化,batch大小应该是2的指数
- 注意CPU/GPU内存大小
momentum
mini-batch
- 为了利用向量化,batch大小应该是2的指数
- 注意CPU/GPU内存大小
momentum
计算权重的指数加权平均
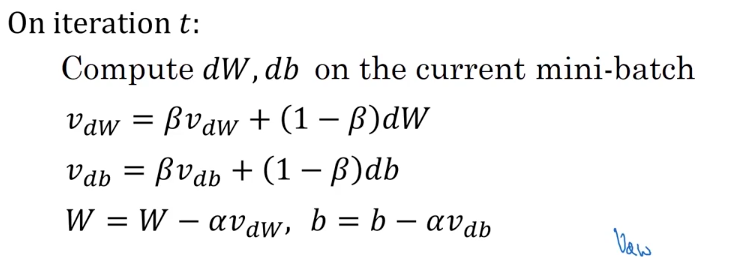
RMSprop
Root mean square prop

使用这个算法可以选择较大的学习率
Adam
Adaptive Momentum Estimation。其实就是把rmsprop和momentem放一起了,另加了一个纠正
其中推荐β1=0.9" role="presentation" style="font-size: 100%; display: inline-block; position: relative;">β1=0.9, β2=0.999" role="presentation" style="font-size: 100%; display: inline-block; position: relative;">β2=0.999, ϵ=10−8" role="presentation" style="font-size: 100%; display: inline-block; position: relative;">ϵ=10−8
深度神经网络中的主要问题不是局部最小点,因为在高维空间中出现局部最优的可能性很小,但是很容易出现鞍点,鞍点会导致训练很慢,所以上面的几个方法会很有用
调参
顺序
Learning rate.
Mini-batch size.
No. of hidden units.
Momentum beta.
No. of layers.
Use learning rate decay?
Adam beta1 & beta2
regularization lambda
Activation functions
批规范化Batch Normalization
可以加速训练
和前面的对于输入数据的处理不一样,这里考虑的是对于隐层,我们能否对A[l]进行操作,使得训练加快。
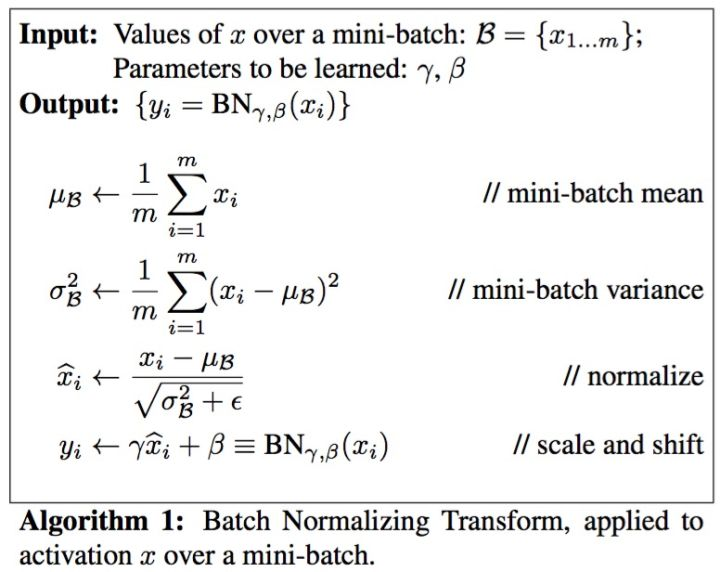
这里γ" role="presentation" style="font-size: 100%; display: inline-block; position: relative;">γ和β" role="presentation" style="font-size: 100%; display: inline-block; position: relative;">β是参数
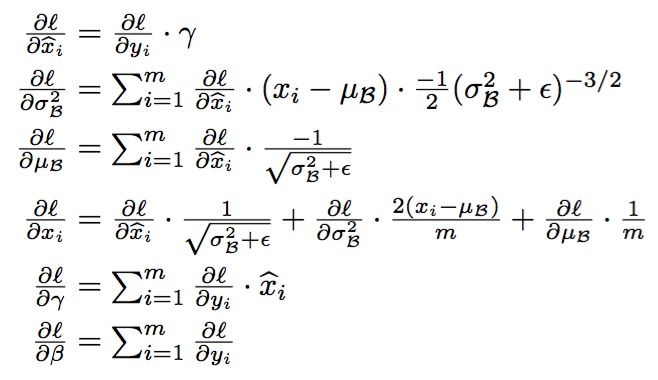
解决了梯度弥散的问题
批规范化其实做了一点正则化的工作,如果你希望减弱这种效果可以增大批大小。
测试用需要估计均值和方差
Reference
https://github.com/mbadry1/DeepLearning.ai-Summary
课程回顾-Improving Deep Neural Networks: Hyperparameter tuning, Regularization and Optimization的更多相关文章
- 课程二(Improving Deep Neural Networks: Hyperparameter tuning, Regularization and Optimization),第二周(Optimization algorithms) —— 2.Programming assignments:Optimization
Optimization Welcome to the optimization's programming assignment of the hyper-parameters tuning spe ...
- 课程二(Improving Deep Neural Networks: Hyperparameter tuning, Regularization and Optimization),第三周(Hyperparameter tuning, Batch Normalization and Programming Frameworks) —— 2.Programming assignments
Tensorflow Welcome to the Tensorflow Tutorial! In this notebook you will learn all the basics of Ten ...
- 课程二(Improving Deep Neural Networks: Hyperparameter tuning, Regularization and Optimization),第一周(Practical aspects of Deep Learning) —— 4.Programming assignments:Gradient Checking
Gradient Checking Welcome to this week's third programming assignment! You will be implementing grad ...
- 《Improving Deep Neural Networks:Hyperparameter tuning, Regularization and Optimization》课堂笔记
Lesson 2 Improving Deep Neural Networks:Hyperparameter tuning, Regularization and Optimization 这篇文章其 ...
- Coursera Deep Learning 2 Improving Deep Neural Networks: Hyperparameter tuning, Regularization and Optimization - week1, Assignment(Initialization)
声明:所有内容来自coursera,作为个人学习笔记记录在这里. Initialization Welcome to the first assignment of "Improving D ...
- [C4] Andrew Ng - Improving Deep Neural Networks: Hyperparameter tuning, Regularization and Optimization
About this Course This course will teach you the "magic" of getting deep learning to work ...
- Coursera Deep Learning 2 Improving Deep Neural Networks: Hyperparameter tuning, Regularization and Optimization - week2, Assignment(Optimization Methods)
声明:所有内容来自coursera,作为个人学习笔记记录在这里. 请不要ctrl+c/ctrl+v作业. Optimization Methods Until now, you've always u ...
- Coursera, Deep Learning 2, Improving Deep Neural Networks: Hyperparameter tuning, Regularization and Optimization - week1, Course
Train/Dev/Test set Bias/Variance Regularization 有下面一些regularization的方法. L2 regularation drop out da ...
- Coursera Deep Learning 2 Improving Deep Neural Networks: Hyperparameter tuning, Regularization and Optimization - week1, Assignment(Gradient Checking)
声明:所有内容来自coursera,作为个人学习笔记记录在这里. Gradient Checking Welcome to the final assignment for this week! In ...
随机推荐
- win10与虚拟机fedora14使用samba文件共享
参考路径:http://blog.sina.com.cn/s/blog_ae9507be01017tyz.html 最近需要配置samba,试了好多次,终于搞定.奉上配置及共享文件的过程,以供参考. ...
- Game Theory
HDU 5795 || 3032 把x个石子的堆分成非空两(i, j)或三堆(i, j, k)的操作->(sg[i] ^ sg[j])或(sg[i] ^ sg[j] ^ sg[k])是x的后继 ...
- gson的特殊用法
1.gson包在处理 字符串转 Map 或者 List 的方法. List memberList = gson.fromJson(str,new TypeToken<List>() {}. ...
- Effective Java 【考虑实现Comparable接口】
Effective Java --Comparable接口 compareTo方法是Comparable接口的唯一方法.类实现了Comparable接口,表明它的实例具有内在的排序关系. 自己实现co ...
- VS2017 带参数启动调式程序
有些程序,比如FFPlay,需要传递命令行参数才能运行想要的功能,比如字幕, ffplay -vf subtitles=mv.mkv mv.mkv 参数是 -vf subtitles=mv.mkv m ...
- 线程中的setDaemon方法
setDaemon方法必须在start方法前定义.t1.setDaemon(True),该语句的意思是:将主线程A设置为子线程t1的守护线程.也就是在执行程序时,t1会随着主线程A的退出而退出,不论t ...
- Unity3D编辑器扩展(二)——定义自己的窗口
上一篇我们讲了如何定义菜单按钮 https://www.cnblogs.com/xiaoyulong/p/10115053.html 这一篇我们讲如何定义自己的窗口. 定义窗口我们需要继承 Edito ...
- 如何从本地远程访问虚拟机内的Mysql服务器?
假设重装了操作系统,则本地的很多软件可能都需要重新安装,比如数据库.但是,假设我们把一些重要的软件安装在虚拟机当中,则在重装操作系统之前,数据库服务器可以和虚拟机一起进行备份.重装操作系统之后,原先的 ...
- 使用vmware vconverter从物理机迁移系统到虚拟机P2V(多图)
zhuan:https://segmentfault.com/a/1190000002697929 本文完整记录了如何从物理服务器,保持所有环境配置信息,纹丝不动的迁移到虚拟机上,俗称 P2V .采用 ...
- POI对Excel的操作
1. 先导包 commons-io-2.6.jar包,用于对文件的操作. 下载地址:http://commons.apache.org/proper/commons-io/download_io.cg ...