
一起学Hadoop——TotalOrderPartitioner类实现全局排序
- SplitSampler 分片采样器,从数据分片中采样数据,该采样器不适合已经排好序的数据
- RandomSampler随机采样器,按照设置好的采样率从一个数据集中采样
- IntervalSampler间隔采样机,以固定的间隔从分片中采样数据,对于已经排好序的数据效果非常好。
 public class TotalSortMap extends Mapper<Text, Text, Text, IntWritable> {

     @Override

     protected void map(Text key, Text value,

                        Context context) throws IOException, InterruptedException {

         context.write(key, new IntWritable(Integer.parseInt(key.toString())));

     }

 }
 public class TotalSortReduce extends Reducer<Text, IntWritable, IntWritable, NullWritable> {

     @Override

     protected void reduce(Text key, Iterable<IntWritable> values,

                           Context context) throws IOException, InterruptedException {

         for (IntWritable value : values)

             context.write(value, NullWritable.get());

     }

 }
入口类:
 public class TotalSort extends Configured implements Tool{

     //实现一个Kye比较器,用于比较两个key的大小,将key由字符串转化为Integer,然后进行比较。

     public static class KeyComparator extends WritableComparator {

         protected KeyComparator() {

             super(Text.class, true);

         }

         @Override

         public int compare(WritableComparable writableComparable1, WritableComparable writableComparable2) {

             int num1 = Integer.parseInt(writableComparable1.toString());

             int num2 = Integer.parseInt(writableComparable2.toString());

             return num1 - num2;

         }

     }

     @Override

     public int run(String[] args) throws Exception {

         Configuration conf = new Configuration();

         conf.set("mapreduce.totalorderpartitioner.naturalorder", "false");

         Job job = Job.getInstance(conf, "Total Sort app");

         job.setJarByClass(TotalSort.class);

         //设置读取文件的路径,都是从HDFS中读取。读取文件路径从脚本文件中传进来

         FileInputFormat.addInputPath(job,new Path(args[0]));

         //设置mapreduce程序的输出路径,MapReduce的结果都是输入到文件中

         FileOutputFormat.setOutputPath(job,new Path(args[1]));

         job.setInputFormatClass(KeyValueTextInputFormat.class);

         //设置比较器,用于比较数据的大小,然后按顺序排序,该例子主要用于比较两个key的大小

         job.setSortComparatorClass(KeyComparator.class);

         job.setNumReduceTasks(3);//设置reduce数量

         job.setMapOutputKeyClass(Text.class);

         job.setMapOutputValueClass(IntWritable.class);

         job.setOutputKeyClass(IntWritable.class);

         job.setOutputValueClass(NullWritable.class);

         //设置保存partitions文件的路径

         TotalOrderPartitioner.setPartitionFile(job.getConfiguration(), new Path(args[2]));

         //key值采样,0.01是采样率,

         InputSampler.Sampler<Text, Text> sampler = new InputSampler.RandomSampler<>(0.01, 1000, 100);

         //将采样数据写入到分区文件中

         InputSampler.writePartitionFile(job, sampler);

         job.setMapperClass(TotalSortMap.class);

         job.setReducerClass(TotalSortReduce.class);

         //设置分区类。

         job.setPartitionerClass(TotalOrderPartitioner.class);

         return job.waitForCompletion(true) ? 0 : 1;

     }

     public static void main(String[] args)throws Exception{

         int exitCode = ToolRunner.run(new TotalSort(), args);

         System.exit(exitCode);

     }

 }
 #!/bin/bash

 do

 for k in $(seq  )

 echo $RANDOM;

 done
sh create_data.sh > test_data.txt
hadoop fs -put test_data.txt /data/
 /usr/local/src/hadoop-2.6./bin/hadoop jar TotalSort.jar \

 hdfs://hadoop-master:8020/data/test_data1.txt \

 hdfs://hadoop-master:8020/total_sort_output \

 hdfs://hadoop-master:8020/total_sort_partitions
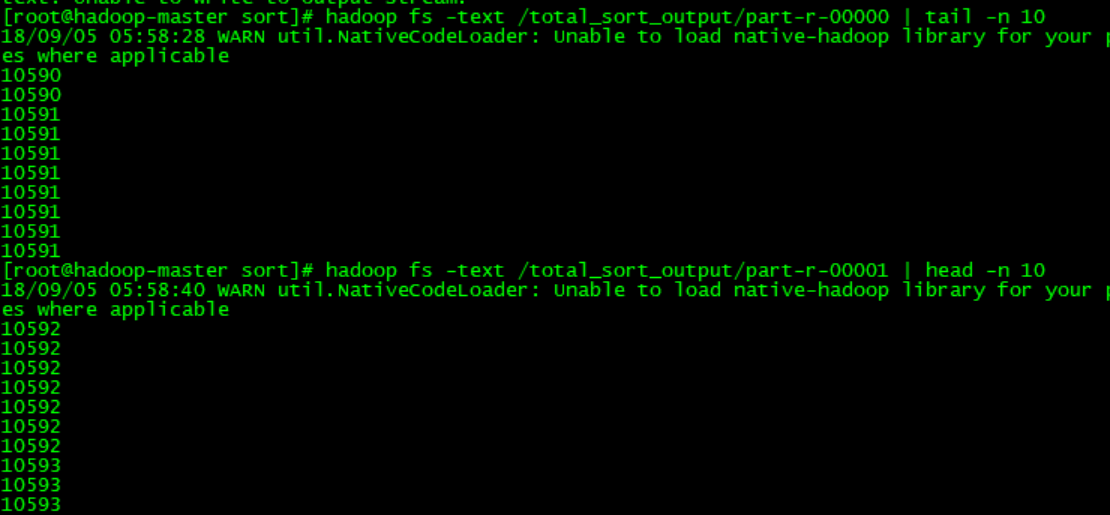
下面有几个坑要注意,大家不要踩:
- 数据的输入类型必须使用KeyValueTextInputFormat类而不是TextInputFormat类,因为hadoop采样器是对key值采样,而TextInputFormat的key是位置偏移量,value存放的是每行的输入数据,对该key采样没有任何意义。KeyValueTextInputFormat的key存放的是输入数据,对key采样才能更好的划分分区。用法:
job.setInputFormatClass(KeyValueTextInputFormat.class);
- 使用代码conf.set("mapreduce.totalorderpartitioner.naturalorder", "false")设置分区的排序策略,否则是每个分区内有序,而不是全局有序。
- 采样器只能是Text,Text类型:InputSampler.Sampler<Text, Text>,否则会报Exception in thread "main" java.io.IOException: wrong key class: org.apache.hadoop.io.Text is not class org.apache.hadoop.io.LongWritable这个错误。
- job.setMapOutputKeyClass(Text.class)和job.setMapOutputValueClass(IntWritable.class)这两行代码必须在InputSampler.Sampler<Text, Text> sampler = new InputSampler.RandomSampler<>(0.01, 1000, 100);这行代码之前调用,否则会报Exception in thread "main" java.io.IOException: wrong key class: org.apache.hadoop.io.Text is not class org.apache.hadoop.io.LongWritable错误。
- 调用setSortComparatorClass方法设置排序类,对key进行排序。job.setSortComparatorClass(KeyComparator.class);类似例子中的KeyComparator类。否则是按照字典序进行排序。MapReduce默认输出的key是字符类型时,默认是按照字典序排序。
一起学Hadoop——TotalOrderPartitioner类实现全局排序的更多相关文章
- Hadoop对文本文件的快速全局排序
一.背景 Hadoop中实现了用于全局排序的InputSampler类和TotalOrderPartitioner类,调用示例是org.apache.hadoop.examples.Sort. 但是当 ...
- MapReduce TotalOrderPartitioner 全局排序
我们知道Mapreduce框架在feed数据给reducer之前会对map output key排序,这种排序机制保证了每一个reducer局部有序,hadoop 默认的partitioner是Has ...
- 三种方法实现Hadoop(MapReduce)全局排序(1)
我们可能会有些需求要求MapReduce的输出全局有序,这里说的有序是指Key全局有序.但是我们知道,MapReduce默认只是保证同一个分区内的Key是有序的,但是不保证全局有序.基于此,本文提供三 ...
- 一起学Hadoop——使用自定义Partition实现hadoop部分排序
排序在很多业务场景都要用到,今天本文介绍如何借助于自定义Partition类实现hadoop部分排序.本文还是使用java和python实现排序代码. 1.部分排序. 部分排序就是在每个文件中都是有序 ...
- Hadoop的partitioner、全排序
按数值排序 示例:按气温字段对天气数据集排序问题:不能将气温视为Text对象并以字典顺序排序正统做法:用顺序文件存储数据,其IntWritable键代表气温,其Text值就是数据行常用简单做法:首先, ...
- MapReduce怎么优雅地实现全局排序
思考 想到全局排序,是否第一想到的是,从map端收集数据,shuffle到reduce来,设置一个reduce,再对reduce中的数据排序,显然这样和单机器并没有什么区别,要知道mapreduce框 ...
- [大牛翻译系列]Hadoop(6)MapReduce 排序:总排序(Total order sorting)
4.2.2 总排序(Total order sorting) 有的时候需要将作业的的所有输出进行总排序,使各个输出之间的结果是有序的.有以下实例: 如果要得到某个网站中最受欢迎的网址(URL),就需要 ...
- Mapreduce的排序(全局排序、分区加排序、Combiner优化)
一.MR排序的分类 1.部分排序:MR会根据自己输出记录的KV对数据进行排序,保证输出到每一个文件内存都是经过排序的: 2.全局排序: 3.辅助排序:再第一次排序后经过分区再排序一次: 4.二次排序: ...
- 大数据mapreduce全局排序top-N之python实现
a.txt.b.txt文件如下: a.txt hadoop hadoop hadoop hadoop hadoop hadoop hadoop hadoop hadoop hadoop hadoop ...
随机推荐
- UVALive 8519 Arrangement for Contests 2017西安区域赛H 贪心+线段树优化
题意 等价于给一个数列,每次对一个长度为$K$的连续区间减一 为最多操作多少次 题解: 看样例猜的贪心,10分钟敲了个线段树就交了... 从1开始,找$[i,i+K]$区间的最小值,然后区间减去最小值 ...
- su命令
作用: 切换 用户 选项: -:可以更改当前目录为切换用户的家目录 使用: # 切换用户,当前所在用户目录不变 su 用户名 # 切换用户,当前所在目录改为切换对象的家目录 /home/用户名 su ...
- ubuntu18.04安装xmind8
1.先去官网下载:https://www.xmind.net/download/xmind8/ 2.默认下载到/home/guojihai/下载/目录下然后把xmind-8-update8-linux ...
- elasticsearch索引自动清理
一 es 基本操作 查看所有的索引文件: curl -XGET http://localhost:9200/_cat/indices?v GET /_cat/indices?v DELETE /fi ...
- GoLand使用
# 不定期更新 什么是GoLand GoLand是JetBrains出品的一个Go语言IDE,JB的IDE有多好用我想很多程序员都知道,个人感觉唯一的缺点就是比较大(因为功能多) 希望大家多多支持正版 ...
- python-面向对象之继承
一.继承介绍 继承是一种新建类的方式,新建的类称之为子类或者派生类,被继承的类称为父类/基类/超类 python中继承的特点: 1.子类可以遗传/重用父类的属性 2.子类可以有多个父类 3.Pytho ...
- Linux 的 OOM 终结者(Out Of Memory killer)
现在是早晨6点钟.已经醒来的我正在总结到底是什么事情使得我的起床闹铃提前了这么多.故事刚开始的时候,手机铃声恰好停止.又困又烦躁的我看了下手机,看看是不是我自己疯了把闹钟调得这么早,居然是早晨5点.然 ...
- 信息摘要算法之四:SHA512算法分析与实现
前面一篇中我们分析了SHA256的原理,并且实现了该算法,在这一篇中我们将进一步分析SHA512并实现之. 1.SHA简述 尽管在前面的篇章中我们介绍过SHA算法,但出于阐述的完整性我依然要简单的说明 ...
- Ubuntu16.04安装MySQL
本篇教程在示例步骤中使用了以下版本的软件.操作时,请您以实际软件版本为准. 操作系统:Ubuntu 16.04.3 LTS (GNU/Linux 4.4.0-105-generic x86_64) ...
- 银联支付Java开发
注:原来来源于: < 银联支付Java开发 > 银联的demo写的不错,基本上可以直接使用. 首先是对acp_sdk.properties的内容修改,注意这个文件的文件名不能进行修改. ...