
Self Organizing Maps (SOM): 一种基于神经网络的聚类算法
自组织映射神经网络, 即Self Organizing Maps (SOM), 可以对数据进行无监督学习聚类。它的思想很简单,本质上是一种只有输入层--隐藏层的神经网络。隐藏层中的一个节点代表一个需要聚成的类。训练时采用“竞争学习”的方式,每个输入的样例在隐藏层中找到一个和它最匹配的节点,称为它的激活节点,也叫“winning neuron”。 紧接着用随机梯度下降法更新激活节点的参数。同时,和激活节点临近的点也根据它们距离激活节点的远近而适当地更新参数。
所以,SOM的一个特点是,隐藏层的节点是有拓扑关系的。这个拓扑关系需要我们确定,如果想要一维的模型,那么隐藏节点依次连成一条线;如果想要二维的拓扑关系,那么就行成一个平面,如下图所示(也叫Kohonen Network):
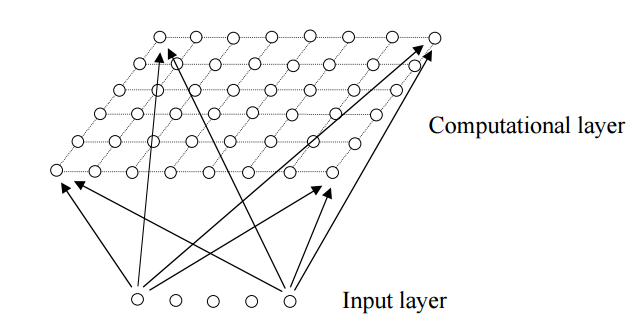
既然隐藏层是有拓扑关系的,所以我们也可以说,SOM可以把任意维度的输入离散化到一维或者二维(更高维度的不常见)的离散空间上。 Computation layer里面的节点与Input layer的节点是全连接的。
拓扑关系确定后,开始计算过程,大体分成几个部分:
1) 初始化:每个节点随机初始化自己的参数。每个节点的参数个数与Input的维度相同。
2)对于每一个输入数据,找到与它最相配的节点。假设输入时D维的, 即 X={x_i, i=1,...,D},那么判别函数可以为欧几里得距离:

3) 找到激活节点I(x)之后,我们也希望更新和它临近的节点。令S_ij表示节点i和j之间的距离,对于I(x)临近的节点,分配给它们一个更新权重:

简单地说,临近的节点根据距离的远近,更新程度要打折扣。
4)接着就是更新节点的参数了。按照梯度下降法更新:

迭代,直到收敛。
与K-Means的比较
同样是无监督的聚类方法,SOM与K-Means有什么不同呢?
(1)K-Means需要事先定下类的个数,也就是K的值。 SOM则不用,隐藏层中的某些节点可以没有任何输入数据属于它。所以,K-Means受初始化的影响要比较大。
(2)K-means为每个输入数据找到一个最相似的类后,只更新这个类的参数。SOM则会更新临近的节点。所以K-mean受noise data的影响比较大,SOM的准确性可能会比k-means低(因为也更新了临近节点)。
(3) SOM的可视化比较好。优雅的拓扑关系图 。
参考文献:http://www.cs.bham.ac.uk/~jxb/NN/l16.pdf
Self Organizing Maps (SOM): 一种基于神经网络的聚类算法的更多相关文章
- DBSCAN聚类︱scikit-learn中一种基于密度的聚类方式
一.DBSCAN聚类概述 基于密度的方法的特点是不依赖于距离,而是依赖于密度,从而克服基于距离的算法只能发现"球形"聚簇的缺点. DBSCAN的核心思想是从某个核心点出发,不断向密 ...
- 【机器学习】DBSCAN Algorithms基于密度的聚类算法
一.算法思想: DBSCAN(Density-Based Spatial Clustering of Applications with Noise)是一个比较有代表性的基于密度的聚类算法.与划分和层 ...
- 简单易学的机器学习算法—基于密度的聚类算法DBSCAN
简单易学的机器学习算法-基于密度的聚类算法DBSCAN 一.基于密度的聚类算法的概述 我想了解下基于密度的聚类算法,熟悉下基于密度的聚类算法与基于距离的聚类算法,如K-Means算法之间的区别. ...
- 简单易学的机器学习算法——基于密度的聚类算法DBSCAN
一.基于密度的聚类算法的概述 最近在Science上的一篇基于密度的聚类算法<Clustering by fast search and find of density peaks> ...
- 基于K-means Clustering聚类算法对电商商户进行级别划分(含Octave仿真)
在从事电商做频道运营时,每到关键时间节点,大促前,季度末等等,我们要做的一件事情就是品牌池打分,更新所有店铺的等级.例如,所以的商户分入SKA,KA,普通店铺,新店铺这4个级别,对于不同级别的商户,会 ...
- 聚类:层次聚类、基于划分的聚类(k-means)、基于密度的聚类、基于模型的聚类
一.层次聚类 1.层次聚类的原理及分类 1)层次法(Hierarchicalmethods)先计算样本之间的距离.每次将距离最近的点合并到同一个类.然后,再计算类与类之间的距离,将距离最近的类合并为一 ...
- 基于ReliefF和K-means算法的医学应用实例
基于ReliefF和K-means算法的医学应用实例 数据挖掘方法的提出,让人们有能力最终认识数据的真正价值,即蕴藏在数据中的信息和知识.数据挖掘 (DataMiriing),指的是从大型数据库或数据 ...
- 一种新型聚类算法(Clustering by fast search and find of density peaksd)
最近在学习论文的时候发现了在science上发表的关于新型的基于密度的聚类算法 Kmean算法有很多不足的地方,比如k值的确定,初始结点选择,而且还不能检测费球面类别的数据分布,对于第二个问题,提出了 ...
- 数据挖掘案例:基于 ReliefF和K-means算法的应用
数据挖掘案例:基于 ReliefF和K-means算法的应用 数据挖掘方法的提出,让人们有能力最终认识数据的真正价值,即蕴藏在数据中的信息和知识.数据挖掘(DataMiriing),指的是从大型数据库 ...
随机推荐
- 推送(PUSH)
一.本地推送 1.建立本地推送 UILocalNotification *notification = [[UILocalNotification alloc] init]; //推送的内容 noti ...
- 使用OLE DB读写Excel
说明: 使用这种技术的好处是无需引用对象,坏处是无法处理类似合并单元格这样的复杂情况 一些更新: 为了使用Office 2010,需要安装Microsoft Access 2010 数据库引擎可再发行 ...
- 换新 iPhone 前要做的 9 件事
iPhone 6 以及 iPhone 6 Plus 终于在众人的期盼下发布了,是不是很多朋友都跃跃欲试,想入手新的 iPhone 呢?若你手中持有旧款 iPhone 的话,其实更换成新机后,还有不少事 ...
- ipad横竖屏尺寸(转载)
iPad在横屏模式下,界面区域元素主要由下图所示构成: 横屏主要尺寸:宽度:1024px高度:768px状态栏(Status Bar)高度:20px导航条(Nav Bar)高度:44px主内容区域(M ...
- python中列表和元组以及字符串的操作
python中列表是非常好用的.不过有一些使用小细节还需要注意一下. tag[32:-4] 从index为32到tag的倒数第4个字符. 如果索引为32的值在倒数第4个字符的右边,那么将输出为空.只要 ...
- Hadoop系列之(一):Hadoop单机部署
1. Hadoop介绍 Hadoop是一个能够对海量数据进行分布式处理的系统架构. Hadoop框架的核心是:HDFS和MapReduce. HDFS分布式文件系统为海量的数据提供了存储, MapRe ...
- 如何解决分布式系统数据事务一致性问题(HBase加Solr)
如何解决分布式系统数据事务一致性问题 (HBase加Solr) 摘要:对于所有的分布式系统,我想事务一致性问题是极其非常重要的问题,因为它直接影响到系统的可用性.本文以下所述所要解决的问题是:对于入H ...
- C语言的函数
"函数"在英文的翻译是"function",无论在自然科学还是计算机科学都是这个词,而"function"的本意是"功能" ...
- bootstrap学习总结-css样式设计(二)
首先,很感谢各位园友对我的支持,关于bootstrap的学习总结,我会持续更新,如果有写的不对的地方,麻烦各位给我指正出来哈.关于上篇文章,固定布局和流式布局很关键,如果还不太清楚的可以再看看我写的h ...
- Java语法基础(一)----关键字、标识符、常量、变量
一.关键字: 关键字:被Java语言赋予特定含义的单词.组成关键字的字母全部小写.注:goto和const作为保留字存在,目前并不使用.main并不是关键字. 二.标识符: 标识符:就是给类,接口,方 ...