
机器翻译评测——BLEU改进后的NIST算法
◆版权声明:本文出自胖喵~的博客,转载必须注明出处。
转载请注明出处:http://www.cnblogs.com/by-dream/p/7765345.html
上一节介绍了BLEU算的缺陷。NIST(National Institute of standards and Technology)方法是在BLEU方法上的一种改进。最主要的是引入了每个n-gram的信息量(information)的概念。BLEU算法只是单纯的将n-gram的数目加起来,而nist是在得到信息量累加起来再除以整个译文的n-gram片段数目。这样相当于对于一些出现少的重点的词权重就给的大了。
信息量的计算公式是:
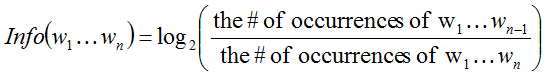
解释一下:分母是n元词在参考译文中出现的次数,分子是对应的n-1元词在参考译文中的出现次数。对于一元词汇,分子的取值就是整个参考译文的长度。这里之所以这样算,应该是考虑到出现次数少的就是重点词这样的一个思路。
计算信息量之后,就可以对每一个共现n元词乘以它的信息量权重,再进行加权求平均得出最后的评分结果:
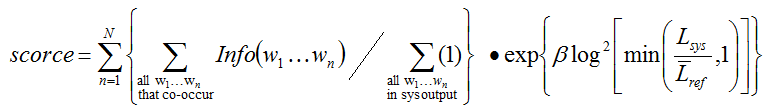
这里注意几个地方:
1、N一般取5
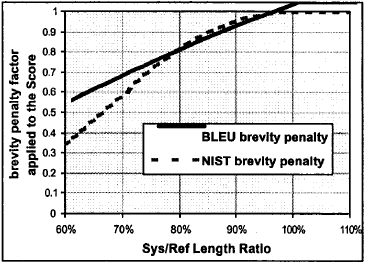
2、β是一个常数,在Lsys/Lref=2/3 时,β使得长度罚分率为0.5,它是个经验值,大概的曲线是:
3、Lref 是参考答案的平均长度(注意L的上方有一个平均符号)
4、Lsys是译文的长度
下面是我费劲千辛万苦找到了计算nist值的工具:
首先进入nist组织的官网:https://www.nist.gov/itl/iad/mig/tools
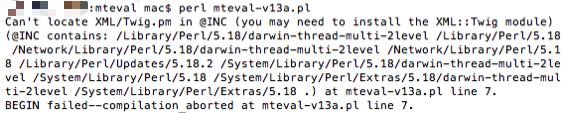
下载第三个,然后我们直接运行,发现因为找不到依赖的库,会出现报错:
Can't locate XML/Twig.pm in @INC (you may need to install the XML::Twig module)
之前也不会perl,这个也折腾了好久。下载XML-Twig 。进入:http://search.cpan.org/~mirod/XML-Twig-3.48/Twig.pm
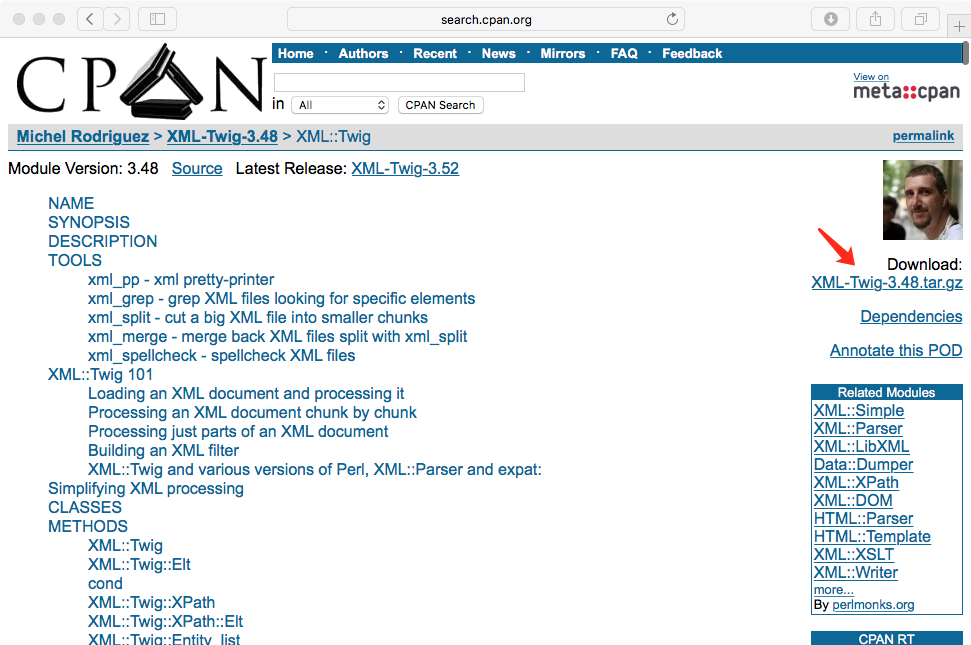
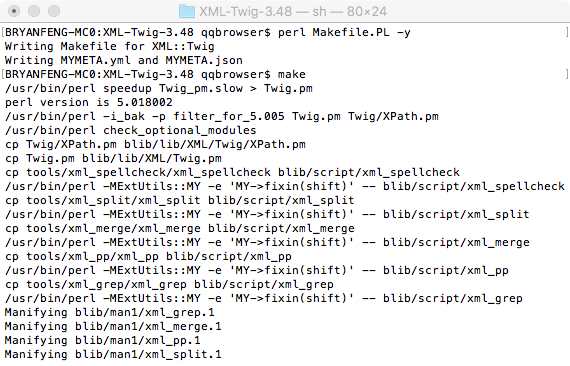
下载成功后,需要三步:
1、perl Makefile.PL -y :这一步在下载下来的readme中有说明,参数还可以指定 -n。
2、make
3、make install:这一步需要root权限,否则会报错
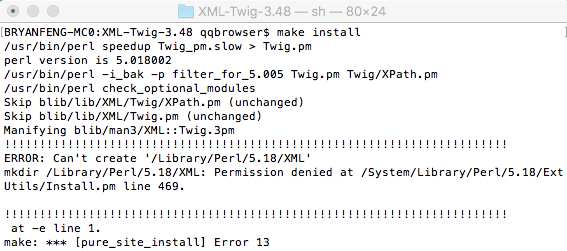
没给root权限,报的错

我们再运行一下,没有再报错了
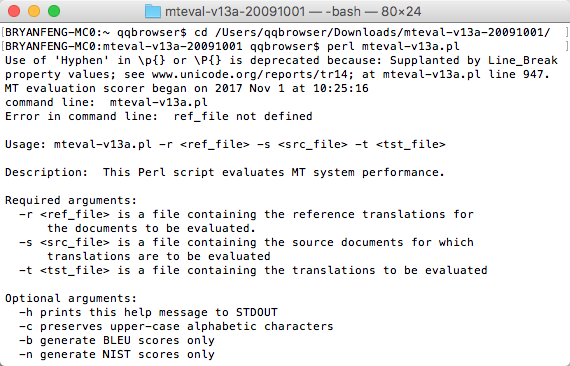
我们用nist提供的example试试,发现算法可以使用:
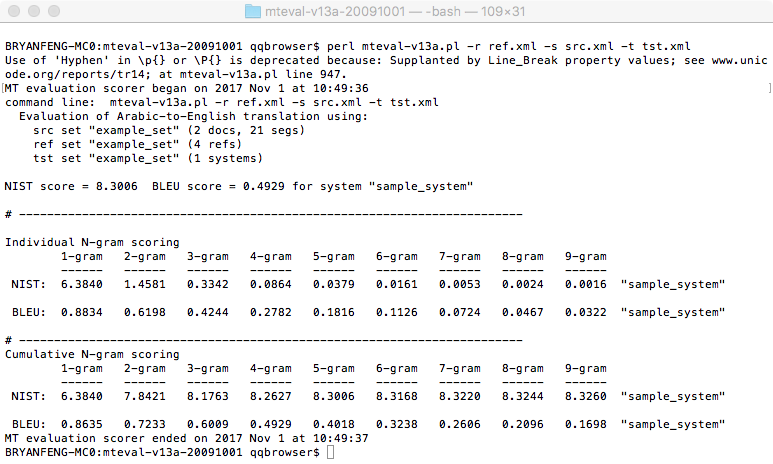
我们看下其他的用法:
BLEU-4(mteval-v13a,官方OpenMT12评估指标)

  调用行: perl mteval-v13a.pl -r REFERENCE_FILE -s SOURCE_FILE -t CANDIDATE_FILE -c -b

  选项-c:区分大小写的得分

  选项-b:仅BLEU得分

IBM BLEU(bleu-1.04a)

  调用行: perl bleu-1.04.pl -r REFERENCE_FILE -t CANDIDATE_FILE

  默认情况下,评分是区分大小写的

NIST(mteval-v13a)

  调用行: perl mteval-v13a.pl -r REFERENCE_FILE -s SOURCE_FILE -t CANDIDATE_FILE -c -n

  选项-c:区分大小写的得分

  选项-n:仅NIST评分

TER(tercom-0.7.25)

  调用行: java -jar tercom.7.25.jar -r REFERENCE_FILE -h CANDIDATE_FILE -N -s

  选项-N:启用归一化

  选项-s:区分大小写的得分

METEOR(气象0.7)

  调用行: perl meteor.pl -s SYSTEM_ID -r REFERENCE_FILE -t CANDIDATE_FILE --modules "exact porter_stem wn_stem wn_synonymy"

  选项--modules "exact porter_stem wn_stem wn_synonymy":按照顺序使用所有四个METEOR匹配模块
这里我们可以看到除了提供nist算法外,还提供BLEU,于是我们用BLEU那篇文章中举例的那句话,我们看看值是否相等。
src.xml:
<?xml version="1.0" encoding="utf-8"?>

<!DOCTYPE mteval SYSTEM "ftp://jaguar.ncsl.nist.gov/mt/resources/mteval-xml-v1.3.dtd">

<mteval>

    <srcset setid="example_set" srclang="Arabic">

        <doc docid="doc1" genre="nw">

            <p>

                <seg id="1">下午去打篮球不?"</seg>

            </p>

        </doc>

    </srcset>

</mteval>
tst.xml:
<?xml version="1.0" encoding="utf-8"?>

<!DOCTYPE mteval SYSTEM "ftp://jaguar.ncsl.nist.gov/mt/resources/mteval-xml-v1.3.dtd">

<mteval>

    <tstset setid="example_set" srclang="Arabic" trglang="English" sysid="sample_system">

        <doc docid="doc1" genre="nw">

            <p>

                <seg id="1">Going to play basketball this afternoon ?</seg>

            </p>

        </doc>

    </tstset>

</mteval>
ref.xml:
<?xml version="1.0" encoding="utf-8"?>

<!DOCTYPE mteval SYSTEM "ftp://jaguar.ncsl.nist.gov/mt/resources/mteval-xml-v1.3.dtd">

<mteval>

    <refset setid="example_set" srclang="Arabic" trglang="English" refid="ref1">

        <doc docid="doc1" genre="nw">

            <p>

                <seg id="1">Going to play basketball in the afternoon ?</seg>

            </p>

        </doc>

    </refset>

</mteval>
运行命令:
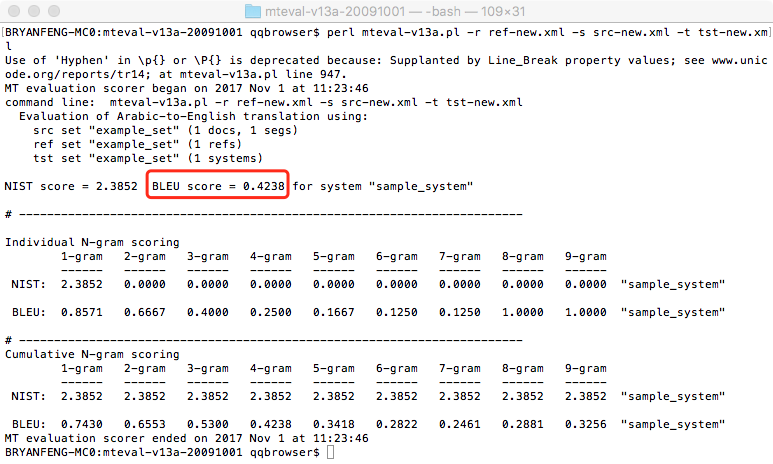
得到的bleu值和我们之前计算的bleu值是一致的。成功~
然后我在后续计算的过程中,发现了nist脚本中的BLEU计算的时候,会把xml中的符号例如“左括号”他会转移为( 进行计算。而(就是左括号的标准转义字符,只不过这里计算的时候刚好给相反了,有点让人想不通。。
最后附上转换xml的脚本,因为之前BLEU计算的时候,不需要xml格式的,因此写了一个批量转化的脚本:
#!/usr/bin/python

#coding=utf8

import sys

import re

import codecs

import os

from xml.etree.ElementTree import ElementTree as etree

from xml.etree.ElementTree import Element, SubElement, ElementTree

reload(sys)

sys.setdefaultencoding( "utf-8" )

# 传入至少5个参数

# 生成译文的xml

# param 1: 要处理的是什么文件,只允许传入 "src","tst","ref"

# param 2:评测集名称

# param 3:源语言

# param 4:目标语言

# param 5..:要处理的文件

# 例如

# 生成原文

# python genXML.py src tmq30 English Chinese tmq30.txt

# 生成译文

# python genXML.py tst tmq English Chinese baidu.txt Google.txt

# 生成ref

# python genXML.py ref tmq English Chinese ref.txt ref2.txt

'''

@ 生成ref的xml

@ param 1: 多份ref的list,list中每一个元素为一个ref的list

@ param 2:评测集名称

@ param 3:源语言

@ param 3:目标语言

'''

def genrefxml(reflists, setid, srclang, trglang):

    mteval = Element('mteval')

    for reflist in reflists:

        sysid = reflist[0]

        set = SubElement(mteval, "refset")

        set.attrib = {"setid":setid, "srclang":srclang, "trglang":trglang, "refid":sysid}

        doc = SubElement(set, "doc")

        doc.attrib = {"docid":"doc1"}

        i = 0

        for sentence in reflist:

            # 第一位存储具体是哪个引擎

            if i != 0:

                p = SubElement(doc, "p")

                seg = SubElement(p, "seg")

                seg.attrib = {"id":str(i)}

                seg.text = sentence

            i = i+1

    tree = ElementTree(mteval)

    tree.write(setid+'_ref.xml', encoding = 'utf-8')

'''

@ 生成译文的xml

@ param 1: 多份译文的list,list中每一个元素为一个译文的list

@ param 2:评测集名称

@ param 3:源语言

@ param 3:目标语言

'''

def gentstxml(tstlists, setid, srclang, trglang):

    mteval = Element('mteval')

    for tstlist in tstlists:

        sysid = tstlist[0]

        set = SubElement(mteval, "tstset")

        set.attrib = {"setid":setid, "srclang":srclang, "trglang":trglang, "sysid":sysid}

        doc = SubElement(set, "doc")

        doc.attrib = {"docid":"doc1"}

        i = 0

        for sentence in tstlist:

            # 第一位存储具体是哪个引擎

            if i != 0:

                p = SubElement(doc, "p")

                seg = SubElement(p, "seg")

                seg.attrib = {"id":str(i)}

                seg.text = sentence

            i = i+1

    tree = ElementTree(mteval)

    tree.write(setid+'_tst.xml', encoding = 'utf-8')

'''

@ 生成原文的xml

@ param 1: 原文内容的list

@ param 2:评测集名称

@ param 3:源语言

'''

def gensrcxml(senlist, setid, srclang):

    mteval = Element('mteval')

    set = SubElement(mteval, "srcset")

    set.attrib = {"setid":setid, "srclang":srclang}

    doc = SubElement(set, "doc")

    doc.attrib = {"docid":"doc1"}

    i = 1

    for sentence in senlist:

        p = SubElement(doc, "p")

        seg = SubElement(p, "seg")

        seg.attrib = {"id":str(i)}

        seg.text = sentence

        i = i+1

    tree = ElementTree(mteval)

    tree.write(setid+'_src.xml', encoding = 'utf-8')

# 调用具体的生成xml

def genxmltree(filetype, setid, srclang, trglang, files):

    if filetype not in ["src","tst","ref"]:

        print "filetype is error"

        return

    # 处理原文

    if filetype == "src":

        srclist = []

        for line in open(files[0]):

            line = line.strip()

            if line:

                srclist.append(line)

        gensrcxml(srclist, setid, srclang)

    # 处理译文

    if filetype == "tst":

        tstslist = []

        for tstfile in files:

            tstlist =[]

            tstlist.append(str(tstfile).strip('.txt'))

            for line in open(tstfile):

                line = line.strip()

                if line:

                    tstlist.append(line)

            tstslist.append(tstlist)

        gentstxml(tstslist, setid, srclang, trglang)

    # 处理ref

    if filetype == "ref":

        reflists = []

        for reffile in files:

            reflist =[]

            reflist.append(str(reffile).strip('.txt'))

            for line in open(reffile):

                line = line.strip()

                if line:

                    reflist.append(line)

            reflists.append(reflist)

        genrefxml(reflists, setid, srclang, trglang)

argv_len = len(sys.argv)

#print argv_len

if argv_len < 6:

    print "param error! src/ref tmq English Chinese 1.txt "

    sys.exit()

filetype = sys.argv[1]

setid = sys.argv[2]

srclang = sys.argv[3]

trglang = sys.argv[4]

files = []

for i in range(5, len(sys.argv)):

    files.append(sys.argv[i])

genxmltree(filetype, setid, srclang, trglang, files)
文中nist算法参考论文《Automatic Evaluation of Machine Translation Quality Using N-gram Co-Occurrence Statistics 》
机器翻译评测——BLEU改进后的NIST算法的更多相关文章
- Python实现改进后的Bi-RRT算法实例
Python实现改进后的Bi-RRT算法实例 1.背景说明 以下代码是参照上海交通大学海洋工程国家重点实验室<基于改进双向RRT的无人艇局部路径规划算法研究>的算法思想实现的. 2.算法流 ...
- 机器翻译评测——BLEU算法详解
◆版权声明:本文出自胖喵~的博客,转载必须注明出处. 转载请注明出处:http://www.cnblogs.com/by-dream/p/7679284.html 前言 近年来,在自然语言研究领域中, ...
- 改进Zhang Suen细化算法的C#实现
本文主要实现了改进Zhang Suen细化算法的C#实现,相关论文 :“牟少敏,杜海洋,苏平,查绪恒,陈光艺.一种改进的快速并行细化算法[J].微电子学与计算机,2013,(第1期)” .这篇论文中关 ...
- 李宏毅机器学习笔记4:Brief Introduction of Deep Learning、Backpropagation(后向传播算法)
李宏毅老师的机器学习课程和吴恩达老师的机器学习课程都是都是ML和DL非常好的入门资料,在YouTube.网易云课堂.B站都能观看到相应的课程视频,接下来这一系列的博客我都将记录老师上课的笔记以及自己对 ...
- 机器翻译评价指标 — BLEU算法
1,概述 机器翻译中常用的自动评价指标是 $BLEU$ 算法,除了在机器翻译中的应用,在其他的 $seq2seq$ 任务中也会使用,例如对话系统. 2 $BLEU$算法详解 假定人工给出的译文为$re ...
- KMP算法(改进后的字符串匹配算法)
转载:http://blog.csdn.net/liu88010988/article/details/50789960 kmp算法完成的任务是:给定两个字符串O和f,长度分别为n和m,判断f是否在O ...
- java词频统计——改进后的单元测试
测试项目 博客文章地址:[http://www.cnblogs.com/jx8zjs/p/5862269.html] 工程地址:https://coding.net/u/jx8zjs/p/wordCo ...
- 关于机器翻译评价指标BLEU(bilingual evaluation understudy)的直觉以及个人理解
最近我在做Natural Language Generating的项目,接触到了BLEU这个指标,虽然知道它衡量的是机器翻译的效果,也在一些文献的experiment的部分看到过该指标,但我实际上经常 ...
- 改进遗传算法之CHC算法简要介绍
简要介绍: CHC算法是Eshelman于1991年提出的一种改进的遗传算法的缩称,第一个C代表跨世代精英选择(Cross generational elitist selection)策略, H代表 ...
随机推荐
- Cookie实现登录记住密码
Cookie实现记住登录密码,用户可以自由选择是否记住密码,或者用户之前选择记住了,但是某一次又不想记住了,需要将之前对应的Cookie删除掉 Cookie相当于map 也是键值对的形式,但是并不相同 ...
- Musical Theme poj1743(后缀数组)
Musical Theme Time Limit: 1000MS Memory Limit: 30000K Total Submissions: 16757 Accepted: 5739 De ...
- mysql客户端(Navicat)远程登录操作遇到问题1142
遇到此问题的原因是:用户user对数据库test 无权限操作. 解决方法:mysql> grant all privileges on test.* to user@'localhost' id ...
- 访问 IIS 元数据库失败
问题: 访问 IIS 元数据库失败.说明: 执行当前 Web 请求期间,出现未处理的异常.请检查堆栈跟踪信息,以了解有关该错误以及代码中导致错误的出处的详细信息. 异常详细信息: System.Web ...
- nodejs后台集成富文本编辑器(ueditor)
1 下载ueditor nodejs版本 2 复制public目录下面的文件 到项目静态资源public文件夹下 3 在项目根目录创建ueditor文件夹 要复制进来的内容为 4 在根目录的 uedi ...
- 使用Travis CI自动部署Hexo到GitHub
原文链接(转载请注明出处):使用Travis CI自动部署Hexo到GitHub 前言 使用 hexo + gitPages 搭建个人博客的人都知道,每当要发表一篇博文,第一步得手动使用 hexo g ...
- win10 uwp 进度条 WaveProgressControl
昨天看到了有个大神做出好看的进度条样式,于是我就去抄袭他的代码,但是发现看不懂,于是本文主要翻译就是大神说这个控件如何做. 本文翻译 https://stackoverflow.com/a/46057 ...
- visual studio 2015 warning MSB3246
在我们很高兴的按下 本地计算机运行 按钮,希望看到我们程序运行的时候,垃圾vs就告诉我们,你的程序出现了问题,问题就是: warning MSB3246: 解析的文件包含错误图像.无元数据或不可访问. ...
- UWP应用程序使用Prism框架构建MVVM
在我们创建的UWP解决方案中选择引用->管理NuGet包程序包 NuGet管理包 2. 搜索Prism.Core,并安装 搜索Prism.Core 3. 搜索Prism.Unity,并安装 搜索 ...
- 关于JavaScript日期类型处理的总结
在任何一门开发语言中,对日期时间类型的处理,必不可少也非常重要,长期以来对于JS的日期类型处理较为苍白.在这里做一个浅显的总结. Date 对象用于处理日期和时间.Date 对象用于处理日期和时间.D ...