
java 爬取 国税局 省市区级联关系
爬取网址 http://www.stats.gov.cn/tjsj/tjbz/tjyqhdmhcxhfdm/2018/index.html
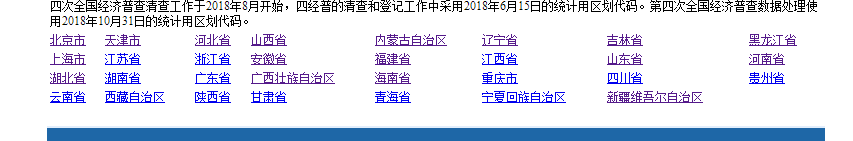
因为数据比较大,存储为一个json,会内存溢出。
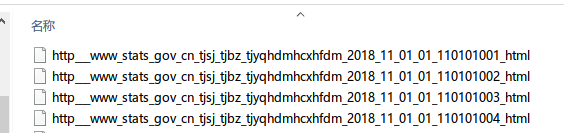
所以按照每个省市进行存储。
同时因为远程访问链接拿取数据,所以会将已经拿到网页进行缓存,以便下次使用。

package com.witwicky.jsoup;

import com.google.gson.Gson;

import com.google.gson.GsonBuilder;

import com.witwicky.vo.CrawlingVo;

import org.jsoup.Jsoup;

import org.jsoup.nodes.Document;

import org.jsoup.nodes.Element;

import org.jsoup.select.Elements;

import java.io.*;

import java.util.ArrayList;

import java.util.List;

import java.util.Random;

public class Crawling {

    private static final String BASE_SAVE_DIR = "E:\\工作\\extract";

    private static final String RESULT_SAVE_DIR = "E:\\工作\\extract_result";

    public static void main(String[] args) throws Exception {

        Gson gsonPretty = new GsonBuilder().setPrettyPrinting().create();

        Gson gsonSimple = new GsonBuilder().create();

        List<CrawlingVo> crawlingVos = new ArrayList<CrawlingVo>();

        Elements select = getElements("index.html", "tr.provincetr > td > a");

        for (Element element : select) {

            List<CrawlingVo> crawlingVos1 = new ArrayList<CrawlingVo>();

            String val = element.attr("href");

            crawlingVos.add(new CrawlingVo(val.substring(0, val.indexOf(".")), element.text(), crawlingVos1));

            String baseUrl = element.attr("href");

            String baseUrlPre = baseUrl.substring(0, baseUrl.indexOf("."));

            Elements ele = getElements(baseUrl, "tr.citytr");

            for (Element nextE : ele) {

                List<CrawlingVo> crawlingVos2 = new ArrayList<CrawlingVo>();

                crawlingVos1.add(new CrawlingVo(nextE.select("td:eq(0) a").text(), nextE.select("td:eq(1) a").text(), crawlingVos2));

                String href = nextE.select("td:eq(1) a").attr("href");

                String substring = href.substring(0, baseUrl.indexOf("."));

                Elements contryElements = getElements(href, "tr.countytr");

                for (Element contryElement : contryElements) {

                    List<CrawlingVo> crawlingVos3 = new ArrayList<CrawlingVo>();

                    crawlingVos2.add(new CrawlingVo(contryElement.select("td:eq(0) a").text(), contryElement.select("td:eq(1) a").text(), crawlingVos3));

                    String href1 = contryElement.select("td:eq(1) a").attr("href");

                    if (!"".equalsIgnoreCase(href1)) {

                        String substring1 = href1.substring(0, baseUrl.indexOf("."));

                        Elements elements = getElements(substring + "/" + href1, "tr.towntr");

                        for (Element element1 : elements) {

                            List<CrawlingVo> crawlingVos4 = new ArrayList<CrawlingVo>();

                            crawlingVos3.add(new CrawlingVo(element1.select("td:eq(0) a").text(), element1.select("td:eq(1) a").text(), crawlingVos4));

                            String href2 = element1.select("td:eq(1) a").attr("href");

                            Elements elements1 = getElements(baseUrlPre + "/" + substring1 + "/" + href2, "tr.villagetr");

                            for (Element element2 : elements1) {

                                crawlingVos4.add(new CrawlingVo(element2.select("td:eq(0)").text(), element2.select("td:eq(2)").text(), new ArrayList<CrawlingVo>()));

                            }

                        }

                    }

                }

            }

            save2File(gsonSimple.toJson(crawlingVos), element.text() + ".json", RESULT_SAVE_DIR);

            save2File(gsonPretty.toJson(crawlingVos), element.text() + "_pretty.json", RESULT_SAVE_DIR);

            System.out.println(element.text() + " is complete!");

        }

    }

    private static Elements getElements(String u, String selector) throws IOException, InterruptedException {

        String url = "http://www.stats.gov.cn/tjsj/tjbz/tjyqhdmhcxhfdm/2018/" + u;

        String cleanUrl = cleanName(url);

        Document select = null;

        File localFile = new File(BASE_SAVE_DIR, cleanUrl);

        if (localFile.exists()) {

            select = Jsoup.parse(localFile, "UTF-8");

        }

        boolean remoteUrl = false;

        if (select == null) {

            int intRd = new Random().nextInt(5) + 1;

            Thread.sleep(intRd * 1000);

            select = Jsoup.connect(url).get();

            remoteUrl = true;

        }

        if (remoteUrl) {

            save2File(select.toString(), cleanName(url), BASE_SAVE_DIR);

        }

        return select.select(selector);

    }

    private static String cleanName(String name) {

        return name

                .replace("\\", "_")

                .replace("/", "_")

                .replace("//", "_")

                .replace(".", "_")

                .replace(":", "_");

    }

    private static void save2File(String content, String fileName, String saveDir) {

        File dir = new File(saveDir);

        if (!dir.exists()) {

            boolean mkdirs = dir.mkdirs();

            if (!mkdirs) {

                return;

            }

        }

        File file = new File(dir, fileName);

        if (file.exists()) {

           return;

        }

        try {

            FileOutputStream outSTr = new FileOutputStream(file);

            BufferedOutputStream Buff = new BufferedOutputStream(outSTr);

            Buff.write(content.getBytes());

            Buff.flush();

            Buff.close();

        } catch (FileNotFoundException e) {

            e.printStackTrace();

        } catch (IOException e) {

            e.printStackTrace();

        }

    }

}
package com.witwicky.vo;

import java.util.List;

public class CrawlingVo {

    private String value;

    private String label;

    private List<CrawlingVo> children;

    public CrawlingVo() {

    }

    public CrawlingVo(String value, String label, List<CrawlingVo> children) {

        this.value = value;

        this.label = label;

        this.children = children;

    }

    public String getValue() {

        return value;

    }

    public void setValue(String value) {

        this.value = value;

    }

    public String getLabel() {

        return label;

    }

    public void setLabel(String label) {

        this.label = label;

    }

    public List<CrawlingVo> getChildren() {

        return children;

    }

    public void setChildren(List<CrawlingVo> children) {

        this.children = children;

    }

}

java 爬取 国税局 省市区级联关系的更多相关文章
- MinerHtmlThread.java 爬取页面线程
MinerHtmlThread.java 爬取页面线程 package com.iteye.injavawetrust.miner; import org.apache.commons.logging ...
- MinerConfig.java 爬取配置类
MinerConfig.java 爬取配置类 package com.iteye.injavawetrust.miner; import java.util.List; /** * 爬取配置类 * @ ...
- Java爬取网络博客文章
前言 近期本人在某云上购买了个人域名,本想着以后购买与服务器搭建自己的个人网站,由于需要筹备的太多,暂时先搁置了,想着先借用GitHub Pages搭建一个静态的站,搭建的过程其实也曲折,主要是域名地 ...
- Java爬取校内论坛新帖
Java爬取校内论坛新帖 为了保持消息灵通,博主没事会上上校内论坛看看新帖,作为爬虫爱好者,博主萌生了写个爬虫自动下载的想法. 嗯,这次就选Java. 第三方库准备 Jsoup Jsoup是一款比较好 ...
- Java爬取B站弹幕 —— Python云图Wordcloud生成弹幕词云
一 . Java爬取B站弹幕 弹幕的存储位置 如何通过B站视频AV号找到弹幕对应的xml文件号 首先爬取视频网页,将对应视频网页源码获得 就可以找到该视频的av号aid=8678034 还有弹幕序号, ...
- java爬取网页内容 简单例子(2)——附jsoup的select用法详解
[背景] 在上一篇博文java爬取网页内容 简单例子(1)——使用正则表达式 里面,介绍了如何使用正则表达式去解析网页的内容,虽然该正则表达式比较通用,但繁琐,代码量多,现实中想要想出一条简单的正则表 ...
- java爬取并下载酷狗TOP500歌曲
是这样的,之前买车送的垃圾记录仪不能用了,这两天狠心买了好点的记录仪,带导航.音乐.蓝牙.4G等功能,寻思,既然有这些功能就利用起来,用4G听歌有点奢侈,就准备去酷狗下点歌听,居然都是需要办会员才能下 ...
- Java爬取并下载酷狗音乐
本文方法及代码仅供学习,仅供学习. 案例: 下载酷狗TOP500歌曲,代码用到的代码库包含:Jsoup.HttpClient.fastJson等. 正文: 1.分析是否可以获取到TOP500歌单 打开 ...
- Java爬取先知论坛文章
Java爬取先知论坛文章 0x00 前言 上篇文章写了部分爬虫代码,这里给出一个完整的爬取先知论坛文章代码. 0x01 代码实现 pom.xml加入依赖: <dependencies> & ...
随机推荐
- 通过Obfuscated ssh避免时不时ssh连接不畅的问题【转】
众所周知的原因,为了能流畅的使用google.使用某些“不存在”的网站,我们一般都是需要通过某些不方便光明正大说明使用用途的技术.比如通过ssh tunnel,这是最简单的,也是用得最多的. 不过,这 ...
- java中的lis数组转为json数据
第一个想到的办法就是 javascript中的replace 也就是先将list数组转为 字符串再对 字符串 replace 但是万万没想到javascript的replace函数在替换数据时, 默 ...
- ReactNative用指定的真机/模拟器运行项目
使用模拟器运行项目: 命令行中React native项目目录下键入react-native run-ios会启动iOS模拟器, 默认是使用iPhone6,如果想要试用其他版本的模拟器则需要在reac ...
- curl: (25) Failed FTP upload: 550 解决方案
ftp的地址一定要以”/”结束.比如:ftp://127.0.0.1/01Dev/
- 自己遇到过的出现java.lang.StackOverflowError的原因
public static JSONArray geth24Weather(String result) {//获取当天24小时以及第二天的天气结果对象 JSONObject fromO ...
- Java 异常 重写抛出异常限制
1 子类在重写父类抛出异常的方法时,要么不抛出异常,要么抛出与父类方法相同的异常或该异常的子类.如果被重写的父类方法只抛出受检异常,则子类重写的方法可以抛出非受检异常.例如,父类方法抛出了一个受检异常 ...
- Egret 获取不到皮肤中的按钮 id
最近Egret开发中遇到的Q,Egret 获取不到皮肤中的按钮 id,也就没法针对按钮进行监听和执行对应操作: 问题的关键就是,exml获取应该出现了差错: 经过查询我发现this.skinName的 ...
- 小甲鱼Python第六讲课后习题
python中被看作假:FALSE none 0 ‘ ’ " " ( ) [ ] { },其他一切都被解释为真 0.Python 的 floor 除法现在使用“//”实现, ...
- poj3069 Saruman's Army(贪心)
https://vjudge.net/problem/POJ-3069 弄清楚一点,第一个stone的位置,考虑左右两边都要覆盖R,所以一般情况下不会在左边第一个(除非前两个相距>R). 一开始 ...
- .NET语言的编译过程:中间语言(IL)和即时编译器(JIT)
.NET语言的编译分为两个阶段.首先高级语言被编译成一种称作IL的中间语言,与高级语言相比,IL更像是机器语言,然而,IL却包含一些抽象概念(比如:类.异常),这也是这种语言被称为中间语言的原因.IL ...