
大数据学习之路又之从csv文件到sql文件的操作过程
根据前几天的测试,简单的做个总结
csv文件的字段说明:
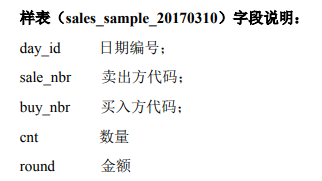
1.将csv文件上传到虚拟机中
在SecureCRT中点击 ,创建目录,直接把文件从本地拖拽进去

我放在了/linmob/data的路径下,所以文件的位置是/linmob/data/sales_sample_20170310.csv
2.在hive命令行中建表,表名要与csv文件中的一一对应,人生建议字段类型都选择varchar
hive
create table sales_sample_20170310(day_id varchar(30),sale_nbr varchar(30),buy_nbr varchar(30),cnt varchar(30),round varchar(30)) row format delimited fields terminated by ',' ;

3.导入数据 其中的路径 '/linmob/data/sales_sample_20170310.csv'和表名 sales_sample_20170310要修改成自己的
load data local inpath '/linmob/data/sales_sample_20170310.csv' overwrite into table sales_sample_20170310;

4.select验证数据是否导入,因为数据量大,一定要limit
select * from sales_sample_20170310 limit 10;
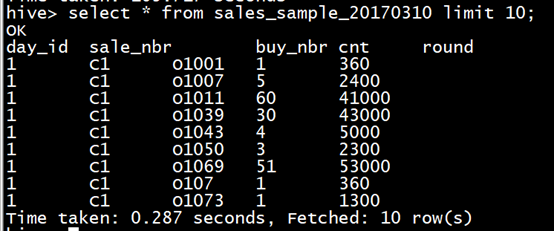
5.退出hive命令行,进入mysql,建表
exit;
mysql -uroot -proot
create table sales_sample_20170310(day_id varchar(30), sale_nbr varchar(30),buy_nbr varchar(30),cnt varchar(30),round varchar(30))charset utf8 collate utf8_general_ci;

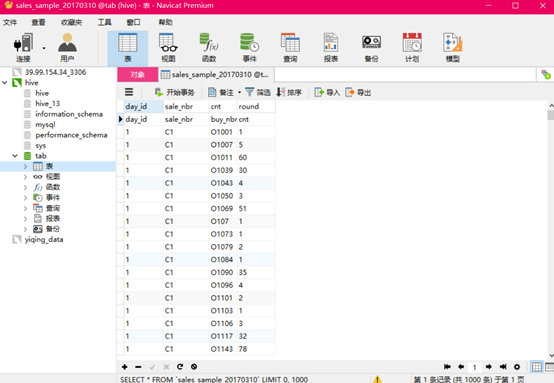
6.退出mqsql,进入sqoop的bin目录下,到出数据到mysql数据库中,其中ip地址192.168.111.100、mysql数据库名tab、mysql用户名和密码root、mysql表名 sales_sample_20170310、hive路径名 /user/hive/warehouse/sales_sample_20170310都要换成自己的
hive路径名不清楚?到9870可以找到
./sqoop export --connect "jdbc:mysql://192.168.111.100:3306/tab?characterEncoding=UTF-8" --username root --password root --table sales_sample_20170310 --export-dir /user/hive/warehouse/sales_sample_20170310 --input-null-string "\\\\N" --input-null-non-string "\\\\N" --input-fields-terminated-by "," --input-lines-terminated-by "\\n" -m 1
7.数据导出
大数据学习之路又之从csv文件到sql文件的操作过程的更多相关文章
- 大数据学习之路又之从小白到用sqoop导出数据
写这篇文章的目的是总结自己学习大数据的经验,以为自己走了很多弯路,从迷茫到清晰,真的花费了很多时间,希望这篇文章能帮助到后面学习的人. 一.配置思路 安装linux虚拟机--->创建三台虚拟机- ...
- 大数据学习之路------借助HDP SANDBOX开始学习
一开始... 一开始知道大数据这个概念的时候,只是感觉很高大上,引起了我的兴趣.当时也不知道,这个东西是做什么的,有什么用,当然现在看来也是很模糊的样子,但是的确比一开始强了不少. 所以学习的过程可能 ...
- 大数据学习之路(1)Hadoop生态体系结构
Hadoop的核心是HDFS和MapReduce,hadoop2.0还包括YARN. Hadoop1.x的生态系统: Hadoop2.x引入YARN: HDFS(Hadoop分布式文件系统)源自于Go ...
- 大数据学习之路之HBASE
Hadoop之HBASE 一.HBASE简介 HBase是一个开源的.分布式的,多版本的,面向列的,半结构化的NoSql数据库,提供高性能的随机读写结构化数据的能力.它可以直接使用本地文件系统,也可以 ...
- 大数据学习之路之Hadoop
Hadoop介绍 一.简介 Hadoop是一个开源的分布式计算平台,用于存储大数据,并使用MapReduce来处理.Hadoop擅长于存储各种格式的庞大的数据,任意的格式甚至非结构化的处理.两个核心: ...
- 大数据学习之路-phoenix
1.phoenix安装 ------------------ 1.安装phoenix a)下载apache-phoenix-4.10.0-HBase-1.2-bin.tar.gz 下载网址:htt ...
- 大数据学习笔记——HDFS理论知识之编辑日志与镜像文件
HDFS文件系统——编辑日志和镜像文件详细介绍 我们知道,启动Hadoop之后,在主节点下会产生Namenode,即名称节点进程,该节点的目录下会保存一份元数据,用来记录文件的索引,而在从节点上即Da ...
- 大数据学习之路-hdfs
1.什么是hadoop hadoop中有3个核心组件: 分布式文件系统:HDFS —— 实现将文件分布式存储在很多的服务器上 分布式运算编程框架:MAPREDUCE —— 实现在很多机器上分布式并行运 ...
- 大数据学习之路——MySQL基础(一)——MySQL的基础知识与常见操作
一.存储引擎 1.含义 存储引擎是数据库底层软件组织,数据库管理系统(DBMS)使用数据引擎进行创建.查询.更新和删除数据.不同的存储引擎提供不同的存储机制.索引技巧.锁定水平等功能,使用不同的存储引 ...
随机推荐
- DPLL 算法(求解k-SAT问题)详解(C++实现)
\(\text{By}\ \mathsf{Chesium}\) DPLL 算法,全称为 Davis-Putnam-Logemann-Loveland(戴维斯-普特南-洛吉曼-洛夫兰德)算法,是一种完备 ...
- 微服务入门三:SpringCloud Alibaba
一.什么是SpringCloud Alibaba 1.简介 1)简介 阿里云未分布式应用开发提供了一站式解决方案.它包含了开发分布式应用程序所需的所有组件,使您可以轻松地使用springcloud开发 ...
- 图解|从根上彻底理解MySQL的索引
这是图解MySQL的第4篇文章,这篇文章会让你 明白什么是索引,彻底理解B+树和索引的关系: 彻底理解主键索引.普通索引.联合索引: 了解什么是HASH索引,InnoDB和MyISAM索引的不同实现方 ...
- think php 公共目录common.php json封装
<?php function getJsonData($code,$massage,$data){ $result=[ 'code'=>$code, 'massage'=>$mass ...
- sklearn.preprocessing.LabelEncoder_标准化标签,将标签值统一转换成range(标签值个数-1)范围内
. LabelEncode(),标签值编码用在将一些类别型的列进行编码,方便用于训练
- 还在写SQL做SAP二开?通过RFC调用NetWeaver,让HANA数据库操作更可靠
相比于从零开始构建全套信息化系统,基于成熟的ERP等行业软件做二次开发是更多中大型企业应对个性化软件需求的首选方案.如何在二开模块中,可靠地对成品软件的数据库进行读写操作,以满足单据自动创建.元数据自 ...
- LGP7840题解
给出一种新的理解方式,本质上和正解是一致的. 首先我们现在已经有了一个森林,我们现在要给他加一条边,加哪一条边是最优的呢? 假设加的边是 \((u,v)\),那么 \(((d[u]+1)^2-d[u] ...
- 详解java接口interface
引言 接口这个词在生活中我们并不陌生. 在中国大陆,我们可以将自己的家用电器的插头插到符合它插口的插座上: 我们在戴尔,惠普,联想,苹果等品牌电脑之间传输数据时,可以使用U盘进行传输. 插座的普适性是 ...
- 在kali中安装两个版本的python
在kali中安装两个版本的python 在kali中已经预装了两个版本的python,但是没有装pip(>︿<). 这时使用python或者python3表示python3:使用pytho ...
- ZYNQ 启动问题 :FSBL
0.ZYNQ外部启动条件 1. 电源要求: 在阶段0 BootROM时,安全模式下PS与PL都是必须上电的:非安全模式PS需要上电,如图: 在阶段1 FSBL时,PS与PL都是必须上电的,因为PL将在 ...