
不care工具,在大数据平台中Hive能自动处理SQL
摘要:有没有更简单的办法,可以直接将SQL运行在大数据平台?
本文分享自华为云社区《Hive执行原理》,作者: JavaEdge 。
MapReduce简化了大数据编程的难度,使得大数据计算不再是高不可攀的技术圣殿,普通工程师也能使用MapReduce开发大数据程序。但是对于经常需要进行大数据计算的人,比如从事研究商业智能(BI)的数据分析师来说,他们通常使用SQL进行大数据分析和统计,MapReduce编程还是有一定的门槛。而且如果每次统计和分析都开发相应的MapReduce程序,成本也确实太高了。
有没有更简单的办法,可以直接将SQL运行在大数据平台?
先看如何用MapReduce实现SQL数据分析。
MapReduce实现SQL的原理
常见的一条SQL分析语句,MapReduce如何编程实现?
SELECT pageid, age, count(1) FROM pv_users GROUP BY pageid, age;
统计分析语句,统计不同年龄用户访问不同网页的兴趣偏好,具体数据输入和执行结果:
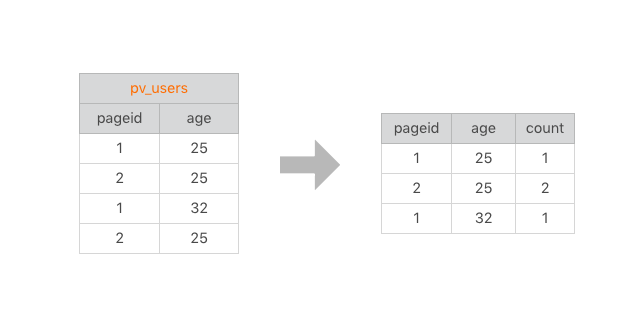
- 左边,要分析的数据表
- 右边,分析结果
把左表相同的行求和,即得右表,类似WordCount计算。该SQL的MapReduce的计算过程,按MapReduce编程模型
- map函数的输入K和V,主要看V
V就是左表中每行的数据,如<1, 25>
- map函数的输出就是以输入的V作为K,V统一设为1
比如<<1, 25>, 1>
map函数的输出经shuffle后,相同的K及其对应的V被放在一起组成一个<K, V集合>,作为输入交给reduce函数处理。比如<<2, 25>, 1>被map函数输出两次,那么到了reduce这里,就变成输入<<2, 25>, <1, 1>>,这里的K是<2, 25>,V集合是<1, 1>。
在reduce函数内部,V集合里所有的数字被相加,然后输出。所以reduce的输出就是<<2, 25>, 2>
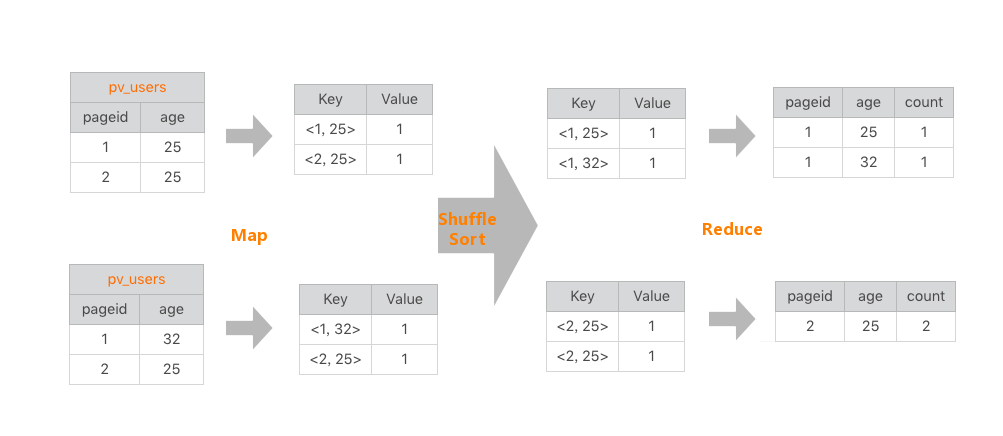
如此,一条SQL就被MapReduce计算好了。
在数据仓库中,SQL是最常用的分析工具,既然一条SQL可以通过MapReduce程序实现,那有无工具能自动将SQL生成MapReduce代码?这样数据分析师只要输入SQL,即可自动生成MapReduce可执行的代码,然后提交Hadoop执行。这就是Hadoop大数据仓库Hive。
Hive架构
Hive能直接处理我们输入的SQL(Hive SQL语法和数据库标准SQL略不同),调用MapReduce计算框架完成数据分析操作。
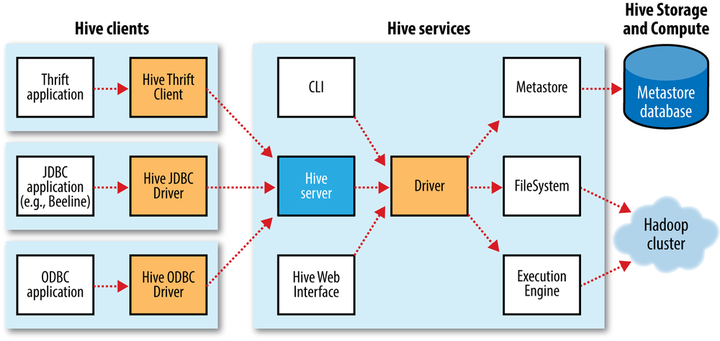
通过Hive Client(Hive的命令行工具,JDBC等)向Hive提交SQL命令:
- 若为DDL,Hive会通过执行引擎Driver将数据表的信息记录在Metastore元数据组件,该组件通常用一个关系数据库实现,记录表名、字段名、字段类型、关联HDFS文件路径等这些数据库的元信息
- 若为DQL,Driver就会将该语句提交给自己的编译器Compiler进行语法分析、语法解析、语法优化等一系列操作,最后生成一个MapReduce执行计划。然后根据执行计划生成一个MapReduce的作业,提交给Hadoop MapReduce计算框架处理。
对一个简单的SQL命令:
SELECT * FROM status_updates WHERE status LIKE ‘michael jackson’;
其对应的Hive执行计划:
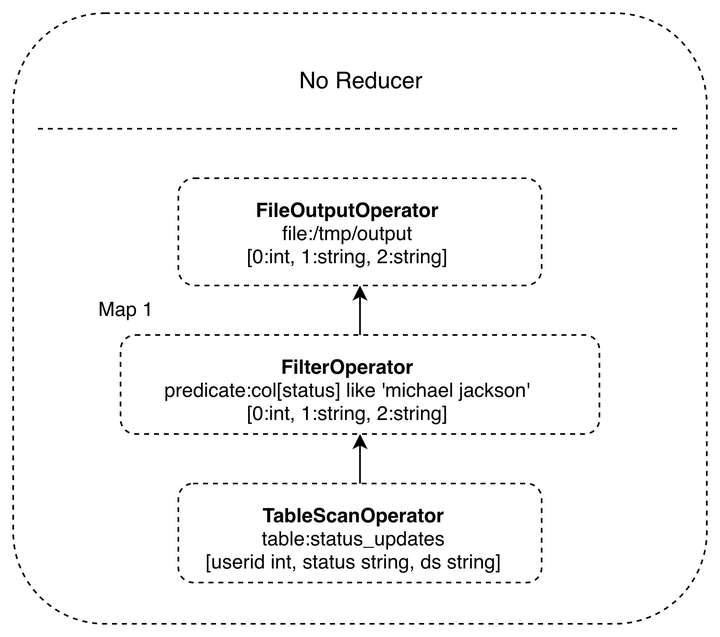
Hive内部预置了很多函数,Hive执行计划就是根据SQL语句生成这些函数的DAG(有向无环图),然后封装进MapReduce的map、reduce函数。该案例中的map函数调用了三个Hive内置函数TableScanOperator、FilterOperator、FileOutputOperator,就完成了map计算,而且无需reduce函数。
Hive如何实现join操作
除了简单的聚合(group by)、过滤(where),Hive还能执行连接(join on)操作。
pv_users表的数据在实际中无法直接得到,因为pageid数据来自用户访问日志,每个用户进行一次页面浏览,就会生成一条访问记录,保存在page_view表中。而age年龄信息则记录在用户表user。
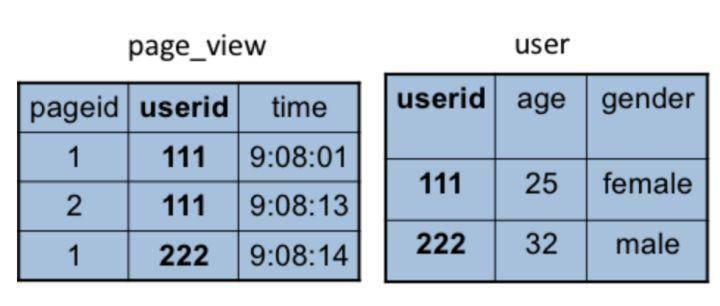
这两张表都有一个相同的字段userid,据该字段可连接两张表,生成前面例子的pv_users表:
SELECT pv.pageid, u.age FROM page_view pv JOIN user u ON (pv.userid = u.userid);
该SQL命令也能转化为MapReduce计算,连接过程如下:
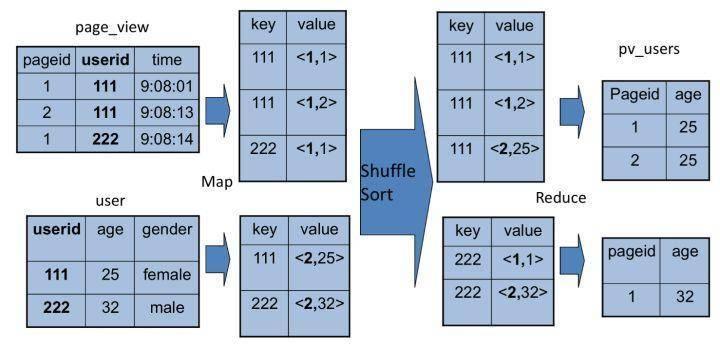
join的MapReduce计算过程和前面的group by稍有不同,因为join涉及两张表,来自两个文件(夹),所以需要在map输出的时候进行标记,比如来自第一张表的输出Value就记录为<1, X>,这里的1表示数据来自第一张表。这样经过shuffle以后,相同的Key被输入到同一个reduce函数,就可以根据表的标记对Value数据求笛卡尔积,用第一张表的每条记录和第二张表的每条记录连接,输出就是join的结果。
所以打开Hive源码,看join相关代码,会看到一个两层for循环,对来自两张表的记录进行连接操作。
总结
开发无需经常编写MapReduce程序,因为网站最主要的大数据处理就是SQL分析,因此Hive在大数据应用很重要。
随Hive普及,我们对在Hadoop上执行SQL的需求越强,对大数据SQL的应用场景也多样化起来,于是又开发了各种大数据SQL引擎。
Cloudera开发了Impala,运行在HDFS上的MPP架构的SQL引擎。和MapReduce启动Map和Reduce两种执行进程,将计算过程分成两个阶段进行计算不同,Impala在所有DataNode服务器上部署相同的Impalad进程,多个Impalad进程相互协作,共同完成SQL计算。在一些统计场景中,Impala可做到ms级计算速度。
后来Spark诞生,也推出自己的SQL引擎Shark,即Spark SQL,将SQL语句解析成Spark的执行计划,在Spark上执行。由于Spark比MapReduce快很多,Spark SQL也相应比Hive快很多,并且随着Spark的普及,Spark SQL也逐渐被人们接受。后来Hive推出了Hive on Spark,将Hive的执行计划转换成Spark的计算模型。
我们还希望在NoSQL执行SQL,毕竟SQL发展几十年,积累庞大用户,很多人习惯用SQL解决问题。于是Saleforce推出了Phoenix,一个执行在HBase上的SQL引擎。
这些SQL引擎只支持类SQL语法,并不能像数据库那样支持标准SQL,特别是数据仓库领域几乎必然会用到嵌套查询SQL:在where条件里面嵌套select子查询,但几乎所有的大数据SQL引擎都不支持。然而习惯于传统数据库的使用者希望大数据也能支持标准SQL。
回到Hive。Hive本身的技术架构其实并没有什么创新,数据库相关的技术和架构已经非常成熟,只要将这些技术架构应用到MapReduce上就得到了Hadoop大数据仓库Hive。但是想到将两种技术嫁接到一起,却是极具创新性的,通过嫁接产生出的Hive极大降低大数据的应用门槛,也使Hadoop得到普及。
参考
https://learning.oreilly.com/library/view/hadoop-the-definitive/9781491901687/ch17.html#TheMetastore
不care工具,在大数据平台中Hive能自动处理SQL的更多相关文章
- 大数据篇:Hive
大数据篇:Hive hive.apache.org Hive是什么? Hive是Facebook开源的用于解决海量结构化日志的数据统计,是基于Hadoop的一个数据仓库工具,可以将结构化的数据文件映射 ...
- 一个大数据平台省了20个IT人力——敦奴数据平台建设案例分享
认识敦奴 敦奴集团创立于1987年,主营服装.酒店.地产,总部位于中国皮都-海宁.浙江敦奴联合实业股份有限公司(以下简称"敦奴")是一家集开发.设计.生产.销售于一体的大型专业服装 ...
- 论各类BI工具的“大数据”特性!
市面上的BI工具形形色色,功能性能包装得十分亮丽,但实际应用中我们往往更关注的是朴实的技术特性和解决方案.对于大数据,未来的应用趋势不可抵挡,很多企业也正存在大数据分析处理展现的需求,以下我们列举市面 ...
- 大数据技术之_19_Spark学习_03_Spark SQL 应用解析 + Spark SQL 概述、解析 、数据源、实战 + 执行 Spark SQL 查询 + JDBC/ODBC 服务器
第1章 Spark SQL 概述1.1 什么是 Spark SQL1.2 RDD vs DataFrames vs DataSet1.2.1 RDD1.2.2 DataFrame1.2.3 DataS ...
- 大数据技术之Hive
第1章 Hive入门 1.1 什么是Hive Hive:由Facebook开源用于解决海量结构化日志的数据统计. Hive是基于Hadoop的一个数据仓库工具,可以将结构化的数据文件映射为一张表,并提 ...
- 《OD大数据实战》Hive环境搭建
一.搭建hadoop环境 <OD大数据实战>hadoop伪分布式环境搭建 二.Hive环境搭建 1. 准备安装文件 下载地址: http://archive.cloudera.com/cd ...
- 大数据量查询优化——数据库设计、SQL语句、JAVA编码
数据库设计方面: 1.对查询进行优化,应尽量避免全表扫描,首先应考虑在 where 及 order by 涉及的列上建立索引. 2.应尽量避免在 where 子句中对字段进行 null 值判断,否则将 ...
- 大数据开发主战场hive (企业hive应用)
hive在大数据套件中占很的地位,分享下个人经验. 1.在hive日常开发中,我们首先面对的就是hive的表和库,因此我要先了解库,表的命名规范和原则 如 dwd_whct_xmxx_m 第1部分为表 ...
- 《OD大数据实战》Hive入门实例
官方参考文档:https://cwiki.apache.org/confluence/display/Hive/LanguageManual 一.命令行和客户端 1. 命令窗口 1)进入命令窗口 hi ...
随机推荐
- TetBrains产品快捷键大全
快捷键大全
- maven国内镜像配置
Maven是当前流行的项目管理工具,但官方的库在国外经常连不上,连上也下载速度很慢.国内oschina的maven服务器很早之前就关了.今天发现阿里云的一个中央仓库,亲测可用. 1 <mirro ...
- cute
环境准备 将靶机导入后将网络设置为NAT kali:192.168.0.102 cute:192.168.0.107 端口扫描 使用nmap对靶机进行端口扫描 nmap –A –p- 192.168. ...
- BLHeli/ BLHeli_S开源无刷电调学习记录
BLHeli的历史轨迹:BLHeli -> BLHeli_S -> BLHeli_32,我们重点学习BLHeli_S版本. 该代码支持常规的1-2ms脉冲宽度输入,以及Oneshot125 ...
- phpstorm+xdebug调试详细教程
对于PHP开发,初来咋到,开发环境的搭建和理解感觉是最烦人的一件事了.不像JAVA,打开一个Eclipse就可以开搞,Php的Debug都要几个插件来配合工作.这些都是死的,好说.但是对于Xdebug ...
- elasticsearch 了解多少,说说你们公司 es 的集群架构,索 引数据大小,分片有多少,以及一些调优手段 。
面试官:想了解应聘者之前公司接触的 ES 使用场景.规模,有没有做过比较大 规模的索引设计.规划.调优. 解答: 如实结合自己的实践场景回答即可. 比如:ES 集群架构 13 个节点,索引根据通道不同 ...
- java-注解相关
注解 概念:说明程序的,给计算机看 注释:用文字描述程序 先了解一些怎么正常javadoc文档 1:给类或者方法添加doc注释 2:通过命令javadoc 执行 类.java文件 新建的类: /** ...
- 攻防世界 easytornado
easytornado 进入环境就这样子 我们逐一访问看看 进入flag.txt提示flag in /fllllllllllllag我们访问fllllllllllllag看看 报了一个error,且在 ...
- poj_1852_Ants(复杂问题简单化)
原题传送门 描述 一群蚂蚁走在长度为l cm的水平细杆上,以1cm/s的匀速.当一只行走的蚂蚁到达杆的一端,它就会掉下去.当两只蚂蚁相遇,它们会掉头像反方向走去.我们知道一只蚂蚁在杆上的初始位置,然而 ...
- JS:数组中push对象,覆盖问题
发现将对象push进数组,后面的值会覆盖前面的值,最后输出的都是最后一次的值.其实这一切都是引用数据类型惹的祸.如果你也有类似问题,可以继续看下去哦.下面代码模拟:将json对象的每个键值对,单独搞成 ...