
hadoop ha集群搭建
集群配置:
jdk1.8.0_161
hadoop-2.6.1
zookeeper-3.4.8
linux系统环境:Centos6.5
3台主机:master、slave01、slave02
Hadoop HA集群搭建(高可用):
设置静态IP地址
为普通用户添加sudo权限
服务器网络设置:NAT模式
域名设置
主机名设置
SSH免登录配置
关闭防火墙
红色步骤主每台主机都要执行,参照上一篇伪分布式集群的搭建
环境变量(每台主机一样):
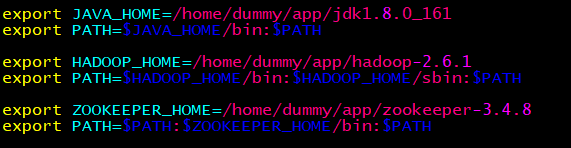
配置文件:
配置core-site.xml
<configuration>
<property>
<!-- 指定hdfs的nameservice为ns1 -->
<name>fs.defaultFS</name>
<value>hdfs://ns1</value>
</property>
<!-- 指定hadoop临时目录 -->
<property>
<name>hadoop.tmp.dir </name>
<value>/home/dummy/app/hadoop-2.6.1/hdpdata</value>
</property>
<!-- 指定zookeeper地址 -->
<property>
<name>ha.zookeeper.quorum</name>
<value>master:2181,slave01:2181,slave02:2181</value>
</property>
</configuration>
配置hdfs-site.xml
<!--指定hdfs的nameservice为ns1,需要和core-site.xml中的保持一致-->
<property>
<name>dfs.nameservices</name>
<value>ns1</value>
</property>
<!-- ns1下面有两个NameNode,分别是nn1,nn2 -->
<property>
<name>dfs.ha.namenodes.ns1</name>
<value>nn1,nn2</value>
</property>
<!-- nn1的RPC通信地址 -->
<property>
<name>dfs.namenode.rpc-address.ns1.nn1</name>
<value>master:9000</value>
</property>
<!-- nn1的http通信地址 -->
<property>
<name>dfs.namenode.http-address.ns1.nn1</name>
<value>master:50070</value>
</property>
<name>dfs.namenode.rpc-address.ns1.nn2</name>
<value>slave01:9000</value>
</property>
<property>
<name>dfs.namenode.http-address.ns1.nn2</name>
<value>slave01:50070</value>
</property>
<!-- 指定NameNode的edits元数据在JournalNode上的存放位置 -->
<property>
<name>dfs.namenode.shared.edits.dir</name>
<value>qjournal://master:8485;slave01:8485;slave02:8485/ns1</value>
</property>
<!-- 指定JournalNode在本地磁盘存放数据的位置 -->
<property>
<name>dfs.journalnode.edits.dir</name>
<value>/home/dummy/app/hadoop-2.6.1/journaldata</value>
</property>
<!-- 开启NameNode失败自动切换 -->
<property>
<name>dfs.ha.automatic-failover.enabled</name>
<value>true</value>
</property>
<!-- 配置失败自动切换实现方式 -->
<property>
<name>dfs.client.failover.proxy.provider.ns1</name>
<value>org.apache.hadoop.hdfs.server.namenode.ha.ConfiguredFailoverPr
oxyProvider</value>
</property>
<!-- 配置隔离机制方法,多个机制用换行分割,即每个机制暂用一行-->
<name>dfs.ha.fencing.methods</name>
<value>
sshfence
shell(/bin/true)
</value>
</property>
<!-- 使用sshfence隔离机制时需要ssh免登陆 -->
<property>
<name>dfs.ha.fencing.ssh.private-key-files</name>
<value>/home/dummy/.ssh/id_rsa</value>
</property>
<!-- 配置sshfence隔离机制超时时间 -->
<property>
<name>dfs.ha.fencing.ssh.connect-timeout</name>
<value>30000</value>
</property>
配置mapred-site.xml
<configuration>
<property>
<name>mapreduce.framework.name</name>
<value>yarn</value>
</property>
</configuration>
配置yarn-site.xml
<name>yarn.resourcemanager.hostname</name>
<value>master</value>
</property>
<name>yarn.nodemanager.aux-services</name>
<value>mapreduce_shuffle</value>
</property>
配置slaves
master
slave01
slave02
HA安装步骤
全新的集群的启动方式:(一定要按步骤执行)
最关键的步骤:把防火墙全部关闭
第一步:启动ZooKeeper集群
第二步:在其中一台修改core-site.xml和hdfs-site.xml的配置文件,修改好后,把它分发到其它的机器
第三步:启动hadoop-daemon.sh start journalnode(三台都启动)
第四步:格式化namenode,然后把格式化的namenode的目录分发到另外一台namenode,分发hdpdata即可
第五步:再到其中一台的namenode上执行命令hdfs zkfc -formatZK
第六步:启动集群
第七步:网页正常访问
非全新的集群的启动方式:
非全新集群模式指的是你之前可能运行过HA或者普通的集群,这个时候,如果是以前运行过HA,但是现在报错,
最简单的方式,先把ZK下面的data里面的数据全部删除,只保留myid,这个时候ZooKeeper就是一个全新的。
并且把hadoop下面的logs和格式化生产的目录全部删除,这个时候保证hadoop是一个全新的。
上面的所有的步骤都是为了保证你重新从一个全新的集群开始搭建HA,可以避免很多问题。
之后的安装参照上面的全新的集群的启动方式进行。
hadoop ha集群搭建的更多相关文章
- hadoop HA集群搭建步骤
NameNode DataNode Zookeeper ZKFC JournalNode ResourceManager NodeManager node1 √ √ √ √ node2 ...
- hadoop HA集群搭建(亲测)
1.hadoop-env.sh 2.core-site.xml <configuration> <!-- 指定hdfs的nameservice为ns1 --> <prop ...
- 大数据-hadoop HA集群搭建
一.安装hadoop.HA及配置journalnode 实现namenode HA 实现resourcemanager HA namenode节点之间通过journalnode同步元数据 首先下载需要 ...
- Hadoop HA集群的搭建
HA 集群搭建的难度主要在于配置文件的编写, 心细,心细,心细! ha模式下,secondary namenode节点不存在... 集群部署节点角色的规划(7节点)------------------ ...
- 基于zookeeper的高可用Hadoop HA集群安装
(1)hadoop2.7.1源码编译 http://aperise.iteye.com/blog/2246856 (2)hadoop2.7.1安装准备 http://aperise.iteye.com ...
- hadoop2.8 ha 集群搭建
简介: 最近在看hadoop的一些知识,下面搭建一个ha (高可用)的hadoop完整分布式集群: hadoop的单机,伪分布式,分布式安装 hadoop2.8 集群 1 (伪分布式搭建 hadoop ...
- Hadoop分布式集群搭建
layout: "post" title: "Hadoop分布式集群搭建" date: "2017-08-17 10:23" catalog ...
- Hadoop+HBase 集群搭建
Hadoop+HBase 集群搭建 1. 环境准备 说明:本次集群搭建使用系统版本Centos 7.5 ,软件版本 V3.1.1. 1.1 配置说明 本次集群搭建共三台机器,具体说明下: 主机名 IP ...
- 全网最详细的Hadoop HA集群启动后,两个namenode都是active的解决办法(图文详解)
不多说,直接上干货! 这个问题,跟 全网最详细的Hadoop HA集群启动后,两个namenode都是standby的解决办法(图文详解) 是大同小异. 欢迎大家,加入我的微信公众号:大数据躺过的坑 ...
随机推荐
- hibernate课程 初探单表映射1-1 第一章
本章内容: 1 什么是orm 2 hibernate简介 3 编写第一个hibernate小例子
- 关于WebStorm,PhpStorm新版本输入中文问题
此文意在记录webstorm,PhpStorm输入中文无提示的问题,对于百忙中的开发无需浏览下面那一段套路话,直接浏览原文链接或者本博客绿色文字解决问题即可. 对于使用过dw,sublime,brac ...
- *.rpm is not signed解决
1.# yum install qemu*报错如下:Package qemu-kvm-tools-0.12.1.2-2.113.el6.x86_64.rpm is not signed2.解决# vi ...
- 【干货】Html与CSS入门学习笔记12-14【完】
十二.HTML5标记 现代HTML html5新增的元素:header nav footer aside section article time 这些新增元素使页面结构更清晰,取代<div i ...
- IOS storyboard(控件器的 生命周期)
@interface NJTwoViewController () @end @implementation NJTwoViewController // 当控制器的view加载完毕就调用 - (vo ...
- 【CF1000C】Covered Points Count(离散化+差分)
点此看题面 大致题意: 给出\(n\)条线段,分别求有多少点被覆盖\(1\)次.\(2\)次...\(n\)次. 正常的算法 好吧,这道题目确实有个很简单的贪心做法(只可惜我做的时候没有想到,结果想了 ...
- python基础一 day17 复习
# 迭代器# 生成器进阶 # 内置函数 # 55个 # 带key的 max min filter map sorted # 思维导图上红色和黄色方法必须会用 # 匿名函数 # lambda 参数,参数 ...
- java基础编程——获取栈中的最小元素
题目描述 定义栈的数据结构,请在该类型中实现一个能够得到栈中所含最小元素的min函数(时间复杂度应为O(1)). 题目代码 /** * Created by YuKai Fan on 2018/9 ...
- java算法面试题:编写一个程序,将a.txt文件中的单词与b.txt文件中的单词交替合并到c.txt文件中,a.txt文件中的单词用回车符分隔,b.txt文件中用回车或空格进行分隔。
package com.swift; import java.io.BufferedReader; import java.io.BufferedWriter; import java.io.File ...
- C#冒泡排序程序
考虑到很多面试可能会考察冒泡排序的用法,所以特地花时间厘清了一下思路.下面说一下我的思路:冒泡排序核心就是比较方法,冒泡排序的比较方法顾名思义就是像气泡一样,最大(或者最小)的数往上冒.普通比较几个数 ...