
hadoop 3.x 完全分布式集群搭建/异常处理/测试
共计三台虚拟机分别为hadoop002(master,存放namenode),hadoop003(workers,datanode以及resourcemanage),hadoop004(workers.datanode,secondarynamenode)
1.搭建前的准备(三台虚拟机均已配置好java以及hadoop环境变量)
可以进行同步及执行命令的分发脚本,关闭防火墙,选定启动的hadoop的账号要能够做到与其他两台虚拟主机免密登录
2.配置hadoop002文件($HADOOP_HOME/etc/hadoop/)
hadoopenv.sh
 export JAVA_HOME=/opt/module/jdk1.8.0_181

 export HADOOP_PID_DIR=/opt/module/hadoop-3.1.1/data/tmp/pids
core-site.xml
 <!-- 指定hadoop运行时产生文件的存储目录 -->

 <property>

   <name>hadoop.tmp.dir</name>

       <value>/opt/module/hadoop-3.1.1/data/tmp</value>

       <!--需要手动创建并修改文件夹属主-->

   <!--<value>/hadoop/tmp</value>-->

 </property>

 <!-- 指定hdfs namenode的缺省路径,可以是ip,也可以是主机名 -->

 <property>

     <name>fs.defaultFS</name>

     <value>hdfs://hadoop002:9000</value>

 </property>
hdfs-site.xml
 <!-- 指定HDFS副本的数量 -->

 <property>

       <name>dfs.replication</name>

       <value>3</value>

 </property>

 <!--配置namenode的web界面-->

 <property>

      <name>dfs.namenode.http-address</name>

      <value>hadoop002:50070</value>

 </property>

 <!--指定secondarynamenode地址-->

 <property>

      <name>dfs.namenode.secondary.http-address</name>

      <value>hadoop004:50090</value>

 </property>
yarn-site.xml(hadoop003上运行ResourceManager)
 <!--resourcemanager address-->

 <property>

         <name>yarn.resourcemanager.hostname</name>

         <value>hadoop003</value>

 </property>

 <!--reduce-->

 <property>

         <name>yarn.nodemanager.aux-services</name>

         <value>mapreduce_shuffle</value>

 </property>
mapred-site.xml
 <!--use yarn-->

 <property>

     <name>mapreduce.framework.name</name>

     <value>yarn</value>

 </property>
workers
 hadoop002

 hadoop003

 hadoop004
3.使用分发脚本同步$HADOOP_HOME/etc/hadoop下的配置文件
分发脚本请参考https://www.cnblogs.com/tele-share/p/9502569.html
在分发脚本同步前,要保证你的hadoop目录下没有存储临时文件的data目录(保险起见也删除logs文件夹),否则同步过去hadoop003与hadoop004的datanode会具有相同的storgeid与datanodeuuid.这样就会导致
启动datanode失败
执行同步命令
xsync.sh /opt/module/hadoop-3.1.1/etc/hadoop/
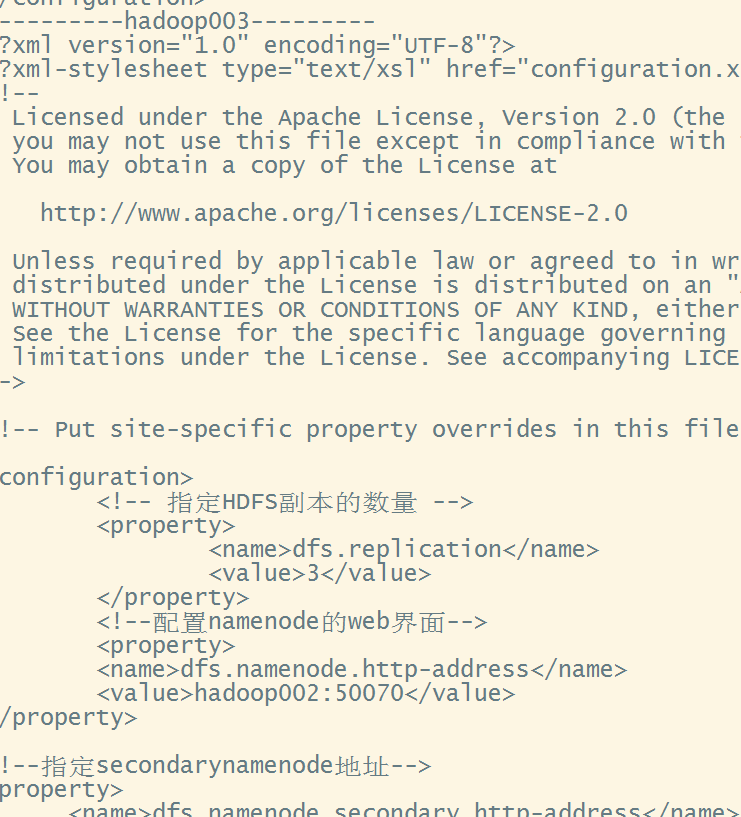
分发完毕后执行分发脚本进行查看
xcall.sh cat /opt/module/hadoop-3.1.1/etc/hadoop/core-site.xml
4.分步启动hadoop
如果你的虚拟机之前没有启动过hadoop,那么第一次启动时还要先进行格式化namenode(hadoop002),格式化namenode时如果出现了yes/no说明你之前的临时存储目录没有清理干净去检查下默认的/tmp是否有残留,没有在执行格式化命令,否则即使成功启动namenode仍然会有问题
hdfs namenode -format
之后在master上即hadoop002启动hdfs
start-dfs.sh
执行这个命令如果出现Permission denied (publickey,gssapi-keyex,gssapi-with-mic,password).是因为没有配置好ssh免密登录,请参考https://www.cnblogs.com/tele-share/p/9503021.html
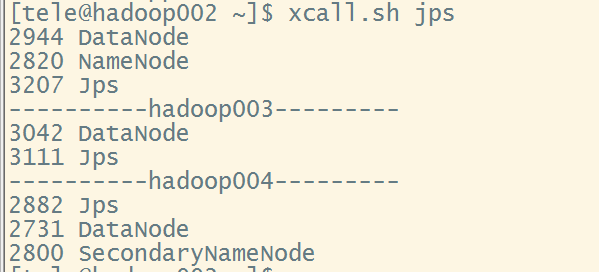
启动成功后xcall.sh jps进行查看,确认三台虚拟机都有了datanode后在hadoop003上(可以在hadoop002上远程连接hadoop003然后启动)启动yarn
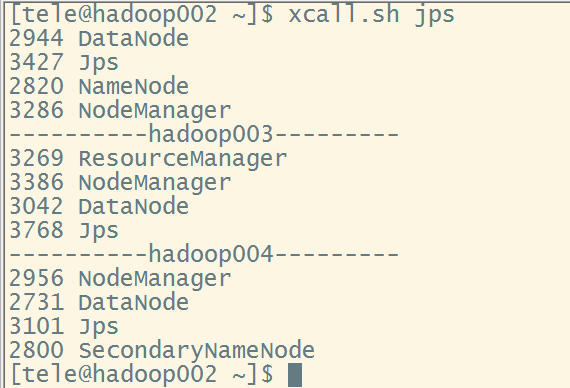
start-yarn.sh,之后在hadoop002上再次查看jps,这里需要注意的是ResourceManager配置在哪台机器上就要在哪台机器上启动yarn
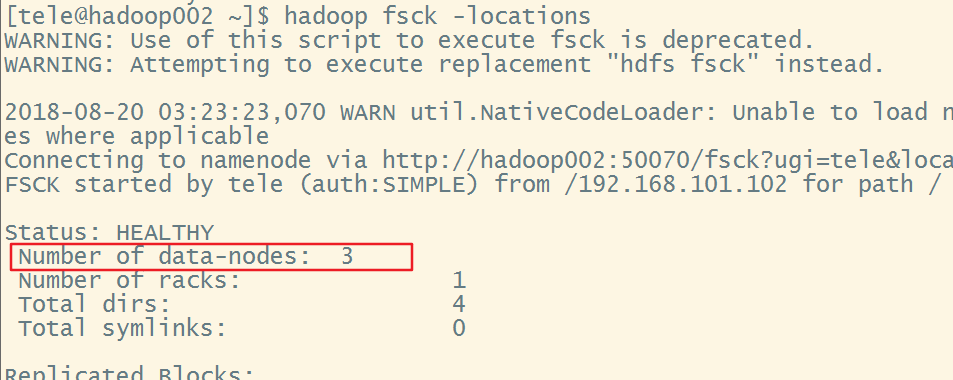
此时已经启动完成,可以执行以下命令查看datanode是否配置正确,否则即使datanode启动了,也不是从属于我们配置的namenode
hadoop fsck -locations(但这个命令并不是判断datanode是否启动的依据,还是要看jps)
再次重申,一定要关闭防火墙如果你只是配置了开放防火墙的某些端口,后面测试文件上传的时候仍然会有问题
5.文件上传测试
创建文件夹
hadoop fs -mkdir -p /usr/tele创建完成后可在hadoop002:50070观察到效果web页面无法打开请参考https://www.cnblogs.com/tele-share/p/9495848.html
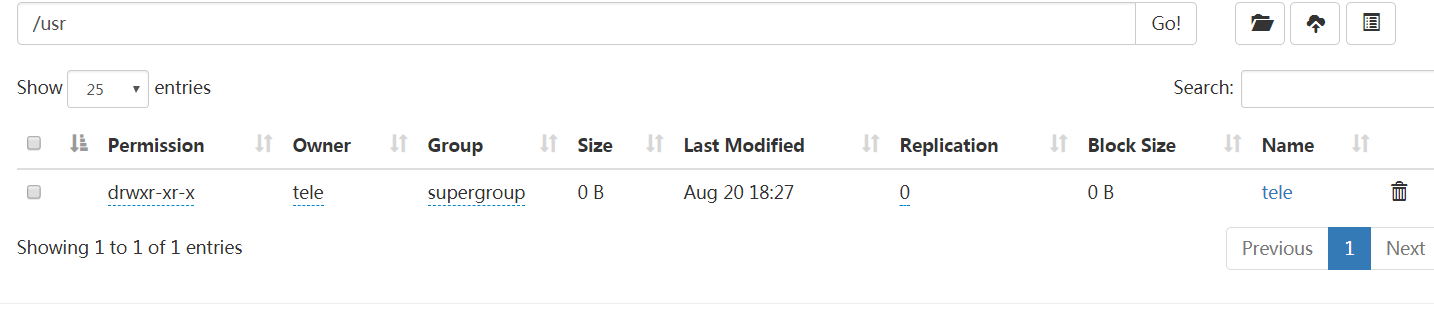
上传文件
hadoop fs -put /opt/software/jdk-8u181-linux-x64.tar.gz /usr/tele
(如果上传失败,请检查文件夹权限,尽量使用普通账号启动hadoop)
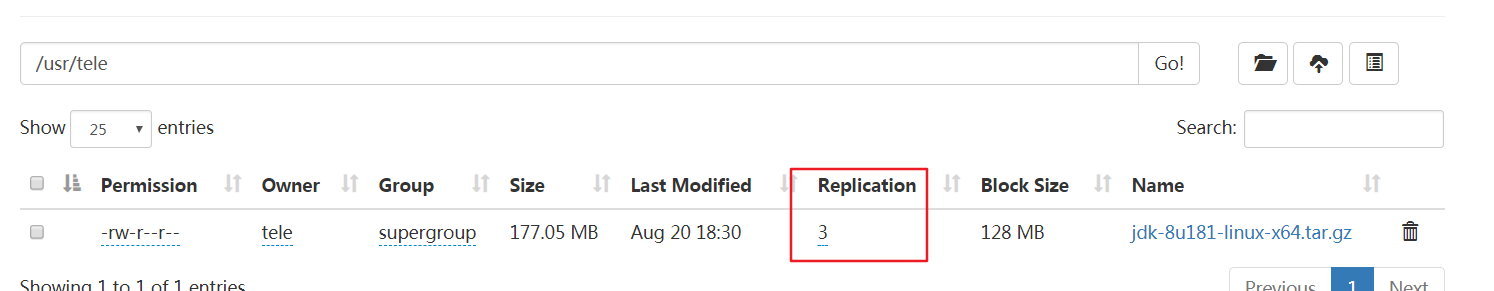
如果发现Replication与Availability不一致,请参考https://www.cnblogs.com/tele-share/p/9504745.html
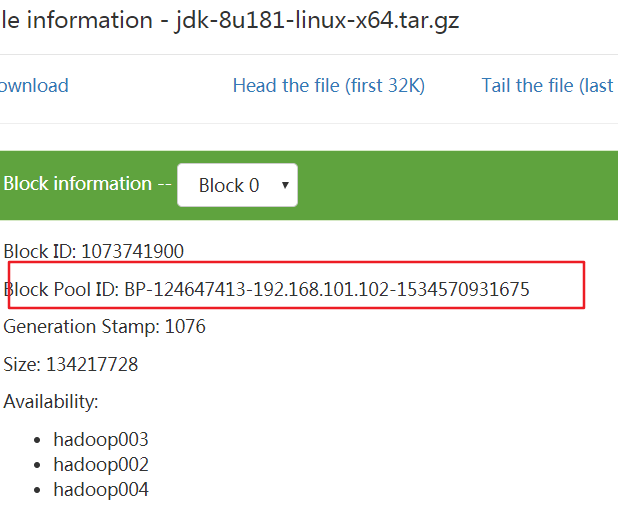
接下来进入hdfds实际在linux上的存储路径,一会要根据Block Pool ID寻找存储的文件,进入以下目录
/opt/module/hadoop-3.1.1/data/tmp/dfs/data/current/BP-124647413-192.168.101.102-1534570931675/current/finalized/subdir0/subdir0
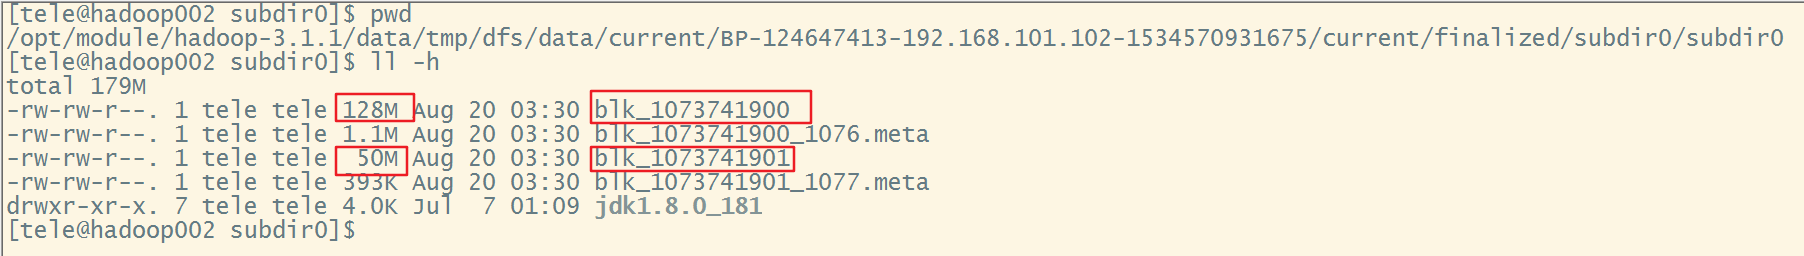
可以看到上传的jdk1.8的压缩包被分成了两个block,接下来对文件进行合并
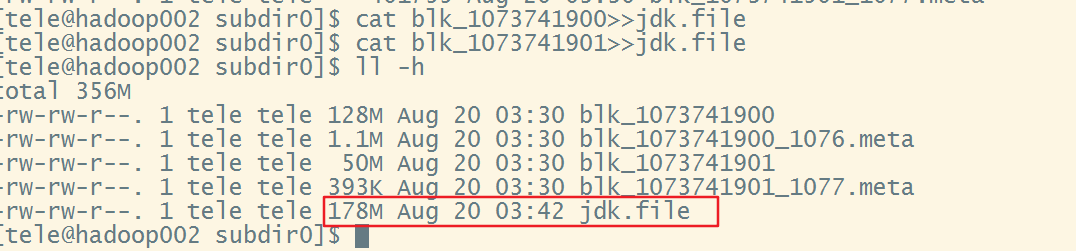
解压这个jdk.file就会得到我们上传的jdk压缩包了tar -zxvf jdk.file
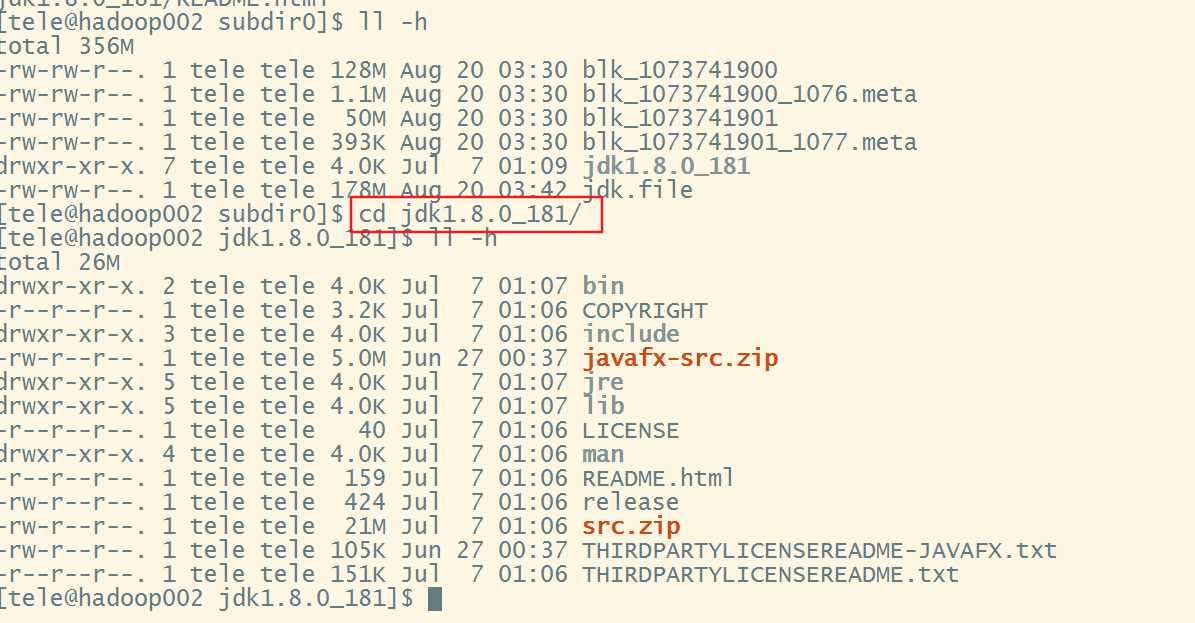
当然也可以使用hadoop fs -get命令进行下载,接下来进入hadoop003与hadoop004分别查看是否有我们的备份
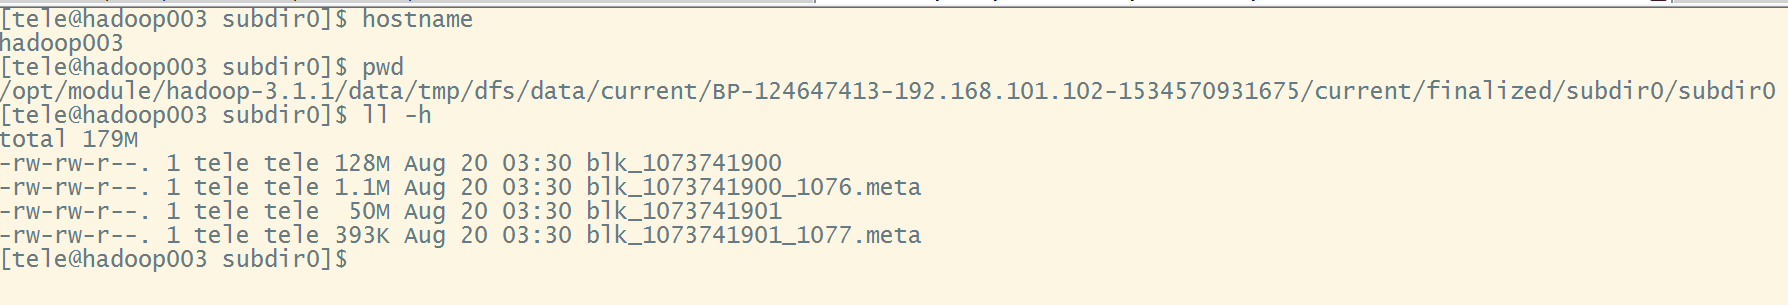
hadoop004的图不再贴了,同样也有备份,到这搭建与测试全部完成了
6.停止
先在hadoop003停止yarn,jps后在hadoop002停止datanode,由于在开头配置hadoop-env.sh时指定了pid的存储目录,所以不用担心pid文件被清理掉
7.总结
①尽量不要使用stop-all.start-all.sh来操作集群,停止与启动都要分步操作,请参考https://www.cnblogs.com/tele-share/p/9508225.html
②datanode与namenode的联系靠的是datanode的clusterID,从属于同一namenode的datanode具有相同的clusterID,当然不同的datanode其storgeid与datanodeuuid是不同的,如果你在启动的过程中发现总是只有一个datanode可以启动,那么你就要考虑datanode的id冲突问题了
③必须在配置ResourceManager的机器上启动yarn
④防火墙必须关闭,只开放部分端口会导致写入副本时报错java.io.IOException: Got error, status=ERROR, status message , ack with firstBadLink as 192.168.101.103:9866查看datanode的日志会有java.net.NoRouteToHostException: No route to host等问题
⑤yarn-site.xml与mapred.xml中尽量不要使用中文注释否则启动的时候会有一个java.lang.RuntimeException: com.ctc.wstx.exc.WstxIOException: Invalid UTF-8 start byte 0xb5 (at char #672, byte #20
⑥修改配置文件前要把hadoop停掉,然后才会生效(个别文件例外,但还是建议停掉hadoop再进行修改)
⑦workers文件对应2,x的slaves,从奴隶变成了工人
⑧3.x中yarn-env.sh与mapred-env.sh已经不再需要配置export JAVA_HOME
hadoop 3.x 完全分布式集群搭建/异常处理/测试的更多相关文章
- Hadoop 3.0完全分布式集群搭建方法(CentOS 7+Hadoop 3.2.0)
本文详细介绍搭建4个节点的完全分布式Hadoop集群的方法,Linux系统版本是CentOS 7,Hadoop版本是3.2.0,JDK版本是1.8. 一.准备环境 1. 在VMware worksta ...
- Hadoop 2.0完全分布式集群搭建方法(CentOS7+Hadoop 2.7.7)
本文详细介绍搭建4个节点的完全分布式Hadoop集群的方法,Linux系统版本是CentOS 7,Hadoop版本是2.7.7,JDK版本是1.8. 一.准备环境 1. 在VMware worksta ...
- Hadoop 2.2 YARN分布式集群搭建配置流程
搭建环境准备:JDK1.6,SSH免密码通信 系统:CentOS 6.3 集群配置:NameNode和ResourceManager在一台服务器上,三个数据节点 搭建用户:YARN Hadoop2.2 ...
- Hadoop上路-01_Hadoop2.3.0的分布式集群搭建
一.配置虚拟机软件 下载地址:https://www.virtualbox.org/wiki/downloads 1.虚拟机软件设定 1)进入全集设定 2)常规设定 2.Linux安装配置 1)名称类 ...
- hadoop伪分布式集群搭建与安装(ubuntu系统)
1:Vmware虚拟软件里面安装好Ubuntu操作系统之后使用ifconfig命令查看一下ip; 2:使用Xsheel软件远程链接自己的虚拟机,方便操作.输入自己ubuntu操作系统的账号密码之后就链 ...
- Hadoop分布式集群搭建
layout: "post" title: "Hadoop分布式集群搭建" date: "2017-08-17 10:23" catalog ...
- 阿里云ECS服务器部署HADOOP集群(二):HBase完全分布式集群搭建(使用外置ZooKeeper)
本篇将在阿里云ECS服务器部署HADOOP集群(一):Hadoop完全分布式集群环境搭建的基础上搭建,多添加了一个 datanode 节点 . 1 节点环境介绍: 1.1 环境介绍: 服务器:三台阿里 ...
- 阿里云ECS服务器部署HADOOP集群(三):ZooKeeper 完全分布式集群搭建
本篇将在阿里云ECS服务器部署HADOOP集群(一):Hadoop完全分布式集群环境搭建的基础上搭建,多添加了一个 datanode 节点 . 1 节点环境介绍: 1.1 环境介绍: 服务器:三台阿里 ...
- Hadoop完全分布式集群搭建
Hadoop的运行模式 Hadoop一般有三种运行模式,分别是: 单机模式(Standalone Mode),默认情况下,Hadoop即处于该模式,使用本地文件系统,而不是分布式文件系统.,用于开发和 ...
随机推荐
- SpringMVC-如何接收各种参数(普通参数,对象,JSON, URL)
在交互的过程中,其中一个关键的节点就是获取到客户端发送过来的请求参数,本篇文章,我们来罗列下SpringMVC对于各种数据的获取方式: 说明:以下重点在讲解如何获取参数上,所以返回的数据不是重点 1, ...
- 最大似然 vs. 最小二乘
有一篇是比较最大似然估计和最小二乘法的: http://www.cnblogs.com/hxsyl/p/5590358.html 最大似然估计:现在已经拿到了很多个样本(你的数据集中所有因变量),这些 ...
- Android 快速下载 Android framework 源码
官网 Android framework源码git地址 github: https://github.com/android/platform_frameworks_base google 官方: h ...
- Altium Designer线如何跟着原件走
- 11.5 Android显示系统框架_Vsync机制_黄油计划_三个方法改进显示系统
5. Vsync机制5.1 黄油计划_三个方法改进显示系统vsync, triple buffering, vsync虚拟化 参考文档:林学森 <深入理解Android内核设计思想>第2版 ...
- 像Bootstrap一样比较热门的前端框架有哪些
像Bootstrap一样比较热门的前端框架有哪些 一.总结 一句话总结:框架大同小异,可以多去各自官网看看效果(比较一下各自的不同点(也就是提供的不同的功能)),然后根据需求选择用哪个.我觉得boot ...
- P2P网贷中的4种理财业务模式
线上3种 直投标:线上理财人直接购买借款人的标,平台只是起个"撮合"作用,收点借款人的服务费. 借款人不还钱,有的平台会帮"借款人"还 ...
- 【习题5-3 UVA-10935】Throwing cards away I
[链接] 我是链接,点我呀:) [题意] 在这里输入题意 [题解] 用STL的queue写 [代码] #include <bits/stdc++.h> using namespace st ...
- ios根据字体大小设置
, , , , , , , , , , , }; //这么多字体,从大到小挨个尝试 ; UIFont *font; ; i < array_length; i++) { font = [font ...
- Codeforces Round #315 (Div. 2) (ABCD题解)
比赛链接:http://codeforces.com/contest/569 A. Music time limit per test:2 seconds memory limit per test: ...