
Python爬虫学习笔记之抓取猫眼的排行榜
代码:
 import json

 import requests

 from requests.exceptions import RequestException

 import re

 import time

 def get_one_page(url):

     try:

         headers = {

             'User-Agent': 'Mozilla/5.0 (Macintosh; Intel Mac OS X 10_13_3) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/65.0.3325.162 Safari/537.36'

         }

         response = requests.get(url, headers=headers)

         if response.status_code == 200:

             return response.text

         return None

     except RequestException:

         return None

 def parse_one_page(html):

     pattern = re.compile('<dd>.*?board-index.*?>(\d+)</i>.*?data-src="(.*?)".*?name"><a'

                          + '.*?>(.*?)</a>.*?star">(.*?)</p>.*?releasetime">(.*?)</p>'

                          + '.*?integer">(.*?)</i>.*?fraction">(.*?)</i>.*?</dd>', re.S)

     items = re.findall(pattern, html)

     for item in items:

         yield {

             'index': item[0],

             'image': item[1],

             'title': item[2],

             'actor': item[3].strip()[3:],

             'time': item[4].strip()[5:],

             'score': item[5] + item[6]

         }

 def write_to_file(content):

     with open('result.txt', 'a', encoding='utf-8') as f:

         f.write(json.dumps(content, ensure_ascii=False) + '\n')

 def main(offset):

     url = 'http://maoyan.com/board/4?offset=' + str(offset)

     html = get_one_page(url)

     for item in parse_one_page(html):

         print(item)

         write_to_file(item)

 if __name__ == '__main__':

     for i in range(10):

         main(offset=i * 10)

         time.sleep(1)
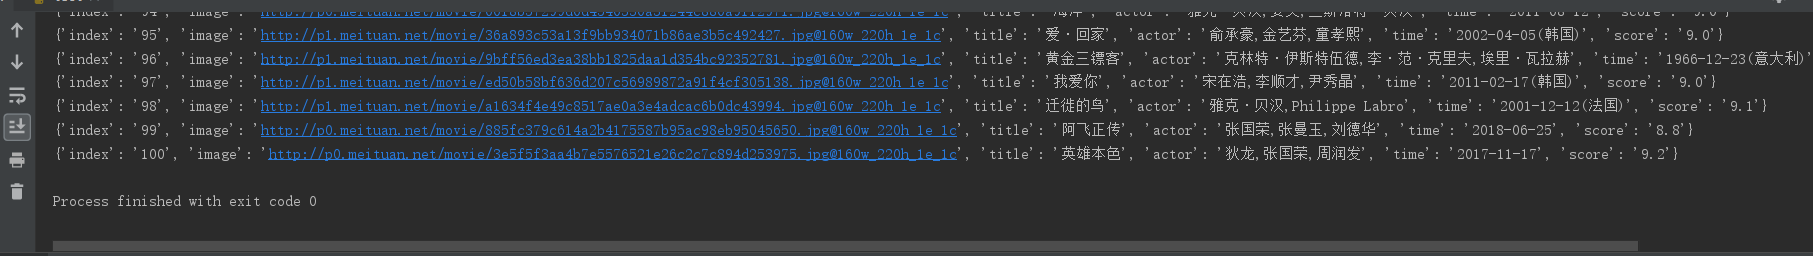
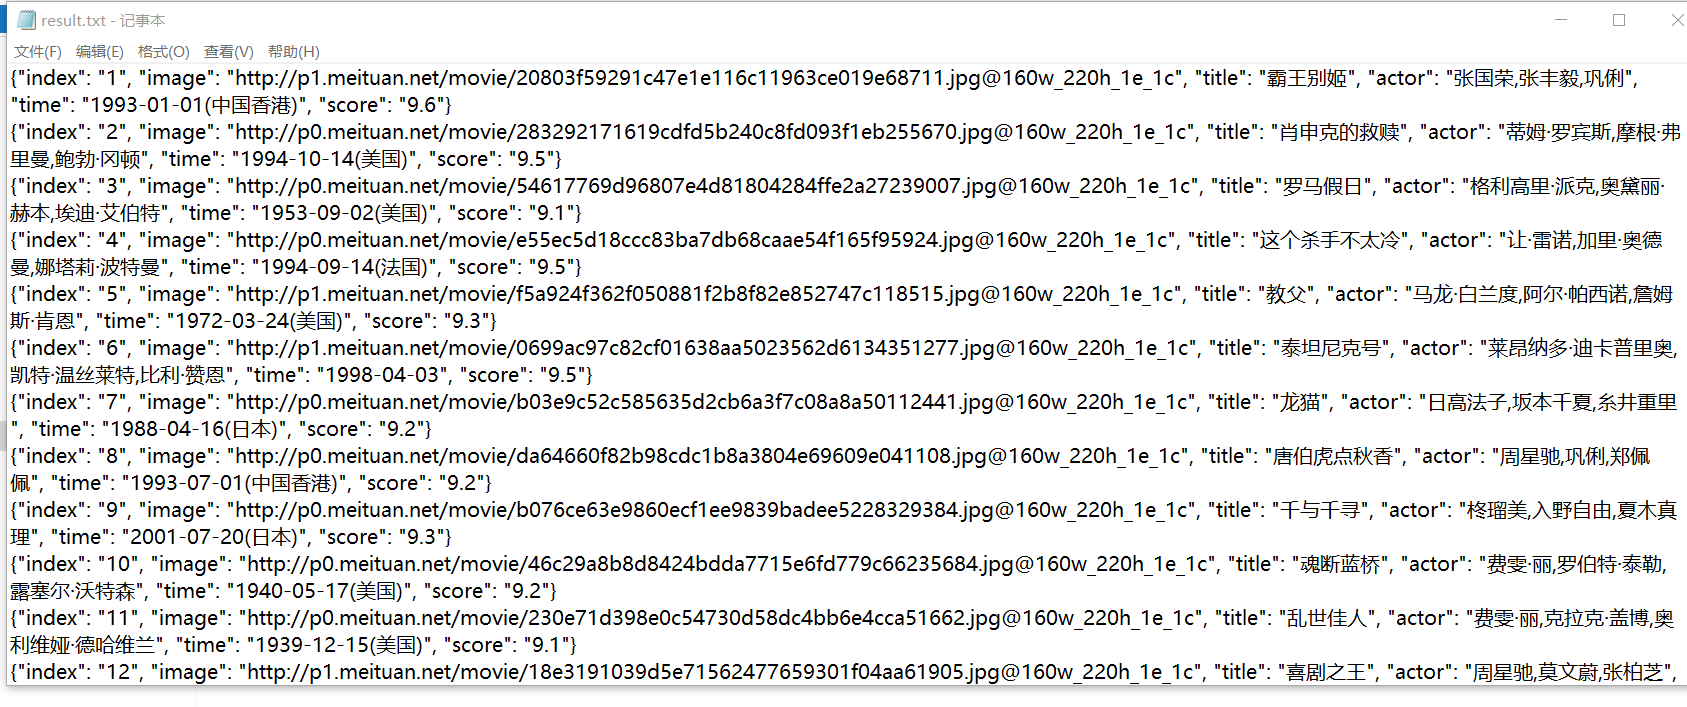
结果:
Python爬虫学习笔记之抓取猫眼的排行榜的更多相关文章
- Python爬虫之requests+正则表达式抓取猫眼电影top100以及瓜子二手网二手车信息(四)
requests+正则表达式抓取猫眼电影top100 一.首先我们先分析下网页结构 可以看到第一页的URL和第二页的URL的区别在于offset的值,第一页为0,第二页为10,以此类推. 二.< ...
- python爬虫学习:分布式抓取
前面的文章都是基于在单机操作,正常情况下,一台机器无论配置多么高,线程开得再多,也总会有一个上限,或者说成本过于巨大.因此,本文将提及分布式的爬虫,让爬虫的效率提高得更快. 构建分布式爬虫首先需要有多 ...
- python爬虫学习(1)__抓取煎蛋图片
#coding=utf-8 #python_demo 爬取煎蛋妹子图在本地文件夹 import requests import threading import time import os from ...
- python爬虫学习(2)__抓取糗百段子,与存入mysql数据库
import pymysql import requests from bs4 import BeautifulSoup#pymysql链接数据库 conn=pymysql.connect(host= ...
- Python爬虫学习笔记之爬取新浪微博
import requests from urllib.parse import urlencode from pyquery import PyQuery as pq from pymongo im ...
- Python爬虫实战四之抓取淘宝MM照片
原文:Python爬虫实战四之抓取淘宝MM照片其实还有好多,大家可以看 Python爬虫学习系列教程 福利啊福利,本次为大家带来的项目是抓取淘宝MM照片并保存起来,大家有没有很激动呢? 本篇目标 1. ...
- Python爬虫实战六之抓取爱问知识人问题并保存至数据库
大家好,本次为大家带来的是抓取爱问知识人的问题并将问题和答案保存到数据库的方法,涉及的内容包括: Urllib的用法及异常处理 Beautiful Soup的简单应用 MySQLdb的基础用法 正则表 ...
- 一次Python爬虫的修改,抓取淘宝MM照片
这篇文章是2016-3-2写的,时隔一年了,淘宝的验证机制也有了改变.代码不一定有效,保留着作为一种代码学习. 崔大哥这有篇>>小白爬虫第一弹之抓取妹子图 不失为学python爬虫的绝佳教 ...
- python爬虫学习01--电子书爬取
python爬虫学习01--电子书爬取 1.获取网页信息 import requests #导入requests库 ''' 获取网页信息 ''' if __name__ == '__main__': ...
随机推荐
- 从0开始 java 网站开发(jsp)【1】
前提:安装java 并配置环境变量 java下载地址: http://www.java.com/zh_CN/ 环境变量配置 本地PC路径: 电脑--属性--高级--环境变量 在系统变量中: 新建 名: ...
- JS 实现随机验证码功能
1.验证码 验证是网页常出现的一个验证点,所谓验证码类型有很多,下面代码只是实现一个简单的验证功能. <div> <input type = "text" id ...
- C# 控制台应用程序输出颜色字体
最佳解决方案的代码: static void Main(string[] args) { Console.ForegroundColor = ConsoleColor.Green; Console.W ...
- VIN码识别:助力汽车后市场转型升级
随着中国汽车市场的成熟,汽车后市场发展迅速,呈“井喷”式增长.据最新数据统计,2015年,中国汽车后市场产值突破8000亿规模,到2018年有望突破万亿. 所谓汽车后市场是指汽车销售以后,围绕汽车使用 ...
- Qt 实现脉搏检测-1-心跳曲线部分
最新的想法就是写一个显示脉搏的东西,主要就是通过串口读取硬件(检测心跳的)传来的数据,在显示一下. 先实现画心跳曲线 如下图 先来电干货, 首先,在这个代码中,第一次用到了list这个东东 所以,关于 ...
- SQL SERVER 的操作复习
一.数据库的创建(SQL语句)CREATE DATABASE AON PRIMARY --主文件组( NAME='A_data',--逻辑文件名 --物理文件名 FILENAME=' ...
- Sleuth+Zipkin+Log
https://blog.csdn.net/sqzhao/article/details/70568637 https://blog.csdn.net/yejingtao703/article/det ...
- Python 套接字的使用 (1)
获取设备名称和IPv4地址 socket.gethostname() socket.gethostbyname(host_name) def print_machine_info(): host_ ...
- Java并发基础--线程安全
一.线程安全 1.线程安全的概念 线程安全:某个类被单个线程,或者多个线程同时访问,所表现出来的行为是一致,则可以说这个类是线程安全的. 2.什么情况下会出现线程安全问题 在单线程中不会出现线程安全问 ...
- [Effective Java] 创建和销毁对象篇
[Effective Java] 创建和销毁对象篇 1. 优先考虑用静态工厂方法代替构造器 优点: - 静态工厂方法相比于构造器,它们有名称 - 不需要每次在使用的时候创建一个对象 - 可以返回原返回 ...