
Python爬虫学习笔记之爬取新浪微博
 import requests

 from urllib.parse import urlencode

 from pyquery import PyQuery as pq

 from pymongo import MongoClient

 base_url = 'https://m.weibo.cn/api/container/getIndex?'

 headers = {

     'Host': 'm.weibo.cn',

     'Referer': 'https://m.weibo.cn/u/2803301701',

     'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/68.0.3440.75 Safari/537.36',

     'X-Requested-With': 'XMLHttpRequest',

 }

 client = MongoClient()

 db = client['weibo']

 collection = db['weibo']

 max_page = 10

 def get_page(page):

     params = {

         'type': 'uid',

         'value': '',

         'containerid': '',

         'page': page

     }

     url = base_url + urlencode(params)

     try:

         response = requests.get(url, headers=headers)

         if response.status_code == 200:

             return response.json(), page

     except requests.ConnectionError as e:

         print('Error', e.args)

 def parse_page(json, page: int):

     if json:

         items = json.get('data').get('cards')

         for index, item in enumerate(items):

             if page == 1 and index == 1:

                 continue

             else:

                 item = item.get('mblog')

                 weibo = {}

                 weibo['id'] = item.get('id')

                 weibo['text'] = pq(item.get('text')).text()

                 weibo['attitudes'] = item.get('attitudes_count')

                 weibo['comments'] = item.get('comments_count')

                 weibo['reposts'] = item.get('reposts_count')

                 yield weibo

 # def save_to_mongo(result):

     # if collection.insert(result):

         # print('Saved to Mongo')

 if __name__ == '__main__':

     for page in range(1, max_page + 1):

         json = get_page(page)

         results = parse_page(*json)

         for result in results:

             print(result)

             # save_to_mongo(result)
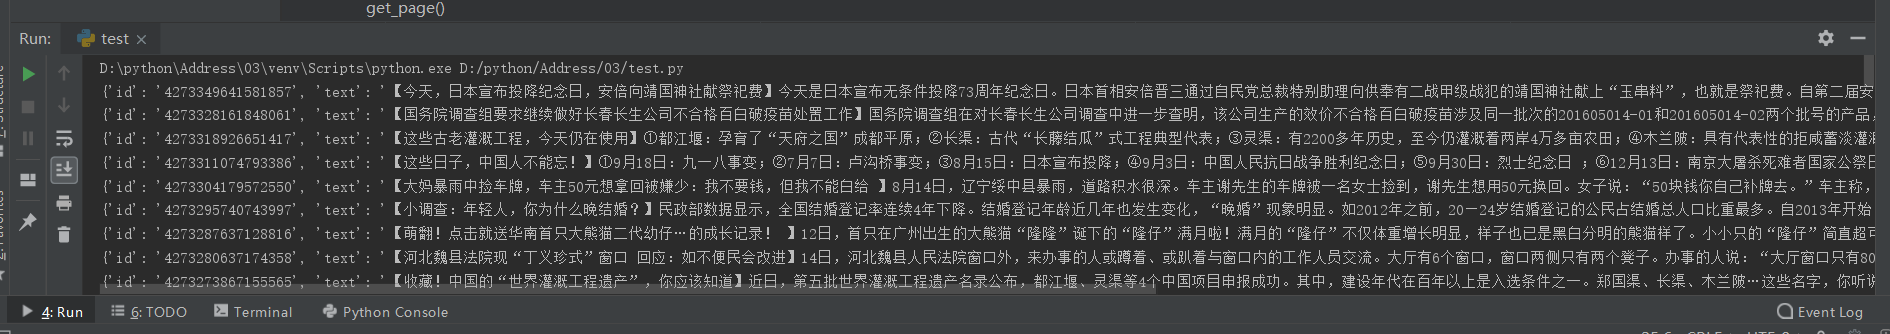
运行结果:
Python爬虫学习笔记之爬取新浪微博的更多相关文章
- python爬虫学习01--电子书爬取
python爬虫学习01--电子书爬取 1.获取网页信息 import requests #导入requests库 ''' 获取网页信息 ''' if __name__ == '__main__': ...
- Python爬虫学习之正则表达式爬取个人博客
实例需求:运用python语言爬取http://www.eastmountyxz.com/个人博客的基本信息,包括网页标题,网页所有图片的url,网页文章的url.标题以及摘要. 实例环境:pytho ...
- Python爬虫学习笔记之抓取猫眼的排行榜
代码: import json import requests from requests.exceptions import RequestException import re import ti ...
- Python爬虫学习笔记之爬今日头条的街拍图片
代码: import requests import os from hashlib import md5 from urllib.parse import urlencode from multip ...
- python爬虫:了解JS加密爬取网易云音乐
python爬虫:了解JS加密爬取网易云音乐 前言 大家好,我是"持之以恒_liu",之所以起这个名字,就是希望我自己无论做什么事,只要一开始选择了,那么就要坚持到底,不管结果如何 ...
- Python爬虫:为什么你爬取不到网页数据
前言: 之前小编写了一篇关于爬虫为什么爬取不到数据文章(文章链接为:Python爬虫经常爬不到数据,或许你可以看一下小编的这篇文章), 但是当时小编也是胡乱编写的,其实里面有很多问题的,现在小编重新发 ...
- Python爬虫实战二之爬取百度贴吧帖子
大家好,上次我们实验了爬取了糗事百科的段子,那么这次我们来尝试一下爬取百度贴吧的帖子.与上一篇不同的是,这次我们需要用到文件的相关操作. 前言 亲爱的们,教程比较旧了,百度贴吧页面可能改版,可能代码不 ...
- Python爬虫实战一之爬取糗事百科段子
大家好,前面入门已经说了那么多基础知识了,下面我们做几个实战项目来挑战一下吧.那么这次为大家带来,Python爬取糗事百科的小段子的例子. 首先,糗事百科大家都听说过吧?糗友们发的搞笑的段子一抓一大把 ...
- 转 Python爬虫实战二之爬取百度贴吧帖子
静觅 » Python爬虫实战二之爬取百度贴吧帖子 大家好,上次我们实验了爬取了糗事百科的段子,那么这次我们来尝试一下爬取百度贴吧的帖子.与上一篇不同的是,这次我们需要用到文件的相关操作. 本篇目标 ...
随机推荐
- spfa专题
SPFA专题 1通往奥格瑞玛的道路 在艾泽拉斯,有n个城市.编号为1,2,3,...,n. 城市之间有m条双向的公路,连接着两个城市,从某个城市到另一个城市,会遭到联盟的攻击,进而损失一定的血量. 每 ...
- lambda, 匿名函数, 变量,传参
lambda: # 无参数函数情况 def delete_one(): pass Button(otherFrame, text="删除", width=4, command=de ...
- 9.Mongodb与python交互
1.与python交互 点击查看官方文档 安装python包 进入虚拟环境 sudo pip install pymongo 或源码安装 python setup.py 引入包pymongo impo ...
- nginx proxy_cache缓存详解
目录 1. 关于缓冲区指令 1.1 proxy_buffer_size 1.2 proxy_buffering 1.3 proxy_buffers 1.4 proxy_busy_buffers_siz ...
- 爬取妹子图(requests + BeautifulSoup)
刚刚入门爬虫,今天先对于单个图集进行爬取,过几天再进行翻页爬取. 使用requests库和BeautifulSoup库 目标网站:妹子图 今天是对于单个图集的爬取,就选择一个进行爬取,我选择的链接为: ...
- Laxcus大数据管理系统2.0(4)- 第一章 基础概述 1.3 节点
1.3 节点 按照我们给Laxcus集群的设计定义,Laxcus集群被分为内部和外部两个网络环境.内部网络由集群的所有权人负责实施和管理,为保证集群能够有效可靠运行,需要遵守一系列的集群部署和管理规定 ...
- 机器学习 (一) 单变量线性回归 Linear Regression with One Variable
文章内容均来自斯坦福大学的Andrew Ng教授讲解的Machine Learning课程,本文是针对该课程的个人学习笔记,如有疏漏,请以原课程所讲述内容为准.感谢博主Rachel Zhang的个人笔 ...
- linux 进程间通信之pipe
在实际开发过程中,程序员必须让拥有依赖关系的进程集协调,这样才能达到进程的共同目标. 每个进程各自有不同的用户地址空间,任何一个进程的全局变量在另一个进程中都看不到,所以进程之间要交换数据必须通过内 ...
- webstorm-前端javascript开发神器中文教程和技巧分享(转)
webstorm是一款前端javascript开发编辑的神器,此文介绍webstorm的中文教程和技巧分享. webstorm8.0.3中文汉化版下载: 百度网盘下载:http://pan.baidu ...
- HDU 2139 Calculate the formula
http://acm.hdu.edu.cn/showproblem.php?pid=2139 Problem Description You just need to calculate the su ...