
SpringCloud学习之sleuth&zipkin【二】
这篇文章我们解决上篇链路跟踪的遗留问题
一、将追踪数据存放到MySQL数据库中
默认情况下zipkin将收集到的数据存放在内存中(In-Memeroy),但是不可避免带来了几个问题:
- 在服务重新启动后,历史数据丢失。
- 在数据量过大的时候容易造成OOM错误
通常做法是与mysql或者ElasticSearch结合使用,那么我们先把收集到的数据先存到Mysql数据库中
1、改造zipkin-server的依赖
gradle配置:
dependencies {

    compile('org.springframework.cloud:spring-cloud-starter-eureka')

    compile('org.springframework.cloud:spring-cloud-starter-config')

  //  compile('io.zipkin.java:zipkin-server')

    compile 'org.springframework.cloud:spring-cloud-starter-sleuth'

    compile('io.zipkin.java:zipkin-autoconfigure-ui')

    runtime('mysql:mysql-connector-java')

    compile('org.springframework.boot:spring-boot-starter-jdbc')

    compile('org.springframework.cloud:spring-cloud-sleuth-zipkin-stream')

    compile('org.springframework.cloud:spring-cloud-stream')

    compile('org.springframework.cloud:spring-cloud-stream-binder-kafka')

}
这里将原先的 io.zipkin.java:zipkin-server 替换为 spring-cloud-sleuth-zipkin-stream 该依赖项包含了对mysql存储的支持,同时添加spring-boot-starter-jdbc与mysql的依赖,顺便把kafka的支持也加进来
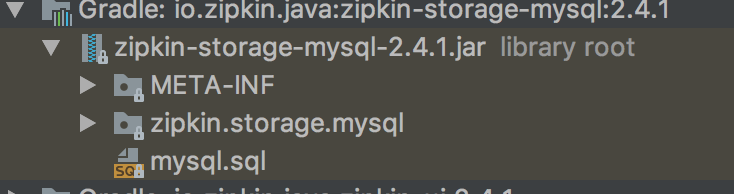
注意:此处脚本最好在数据库中执行一下,当然我们也可以在下面的配置文件中做初始化的相关配置
2、YAML中的关键配置项:
spring:

  datasource:

    username: root

    password: root

    url: jdbc:mysql://localhost:3306/myschool?characterEncoding=utf-8&useSSL=false

    initialize: true

    continue-on-error: true

  kafka:

    bootstrap-servers: localhost:9092

server:

  port: 9000

zipkin:

  storage:

    type: mysql
注意zipkin.storage.type 指定为mysql
3、更改启动类
package com.hzgj.lyrk.zipkin.server;

import org.springframework.boot.SpringApplication;

import org.springframework.boot.autoconfigure.SpringBootApplication;

import org.springframework.cloud.sleuth.zipkin.stream.EnableZipkinStreamServer;

@EnableZipkinStreamServer

@SpringBootApplication

public class ZipkinServerApplication {

    public static void main(String[] args) {

        SpringApplication.run(ZipkinServerApplication.class, args);

    }

}
这里注意将@EnableZipkinServer改成@EnableZipkinStreamServer
二、将收集信息改成异步发送
这步改造主要用以提高性能与稳定性,服务将收集到的span无脑的往消息中间件上丢就可以了,不用管zipkin的地址在哪里。
1、改造Order-Server依赖:
gradle:
    compile('org.springframework.cloud:spring-cloud-starter-eureka-server')

   // compile('org.springframework.cloud:spring-cloud-sleuth-zipkin')

    compile 'org.springframework.cloud:spring-cloud-starter-sleuth'

    compile 'org.springframework.cloud:spring-cloud-sleuth-stream'

    compile('org.springframework.cloud:spring-cloud-starter-config')

    compile('org.springframework.cloud:spring-cloud-stream')

    compile('org.springframework.cloud:spring-cloud-stream-binder-kafka')

    compile('org.springframework.kafka:spring-kafka')

    compile('org.springframework.cloud:spring-cloud-starter-bus-kafka')
这里把原先的spring-cloud-sleuth-zipkin改成spring-cloud-sleuth-stream,不用猜里面一定是基于spring-cloud-stream实现的
2、YAML关键属性配置:
server:

  port: 8100

logging:

  level:

    org.springframework.cloud.sleuth: DEBUG

spring:

  sleuth:

    sampler:

      percentage: 1.0
注意:这里设置低采样率会导致span的丢弃。我们同时设置sleuth的日志输出为debug
3、同理改造其他的微服务
三、验证结果
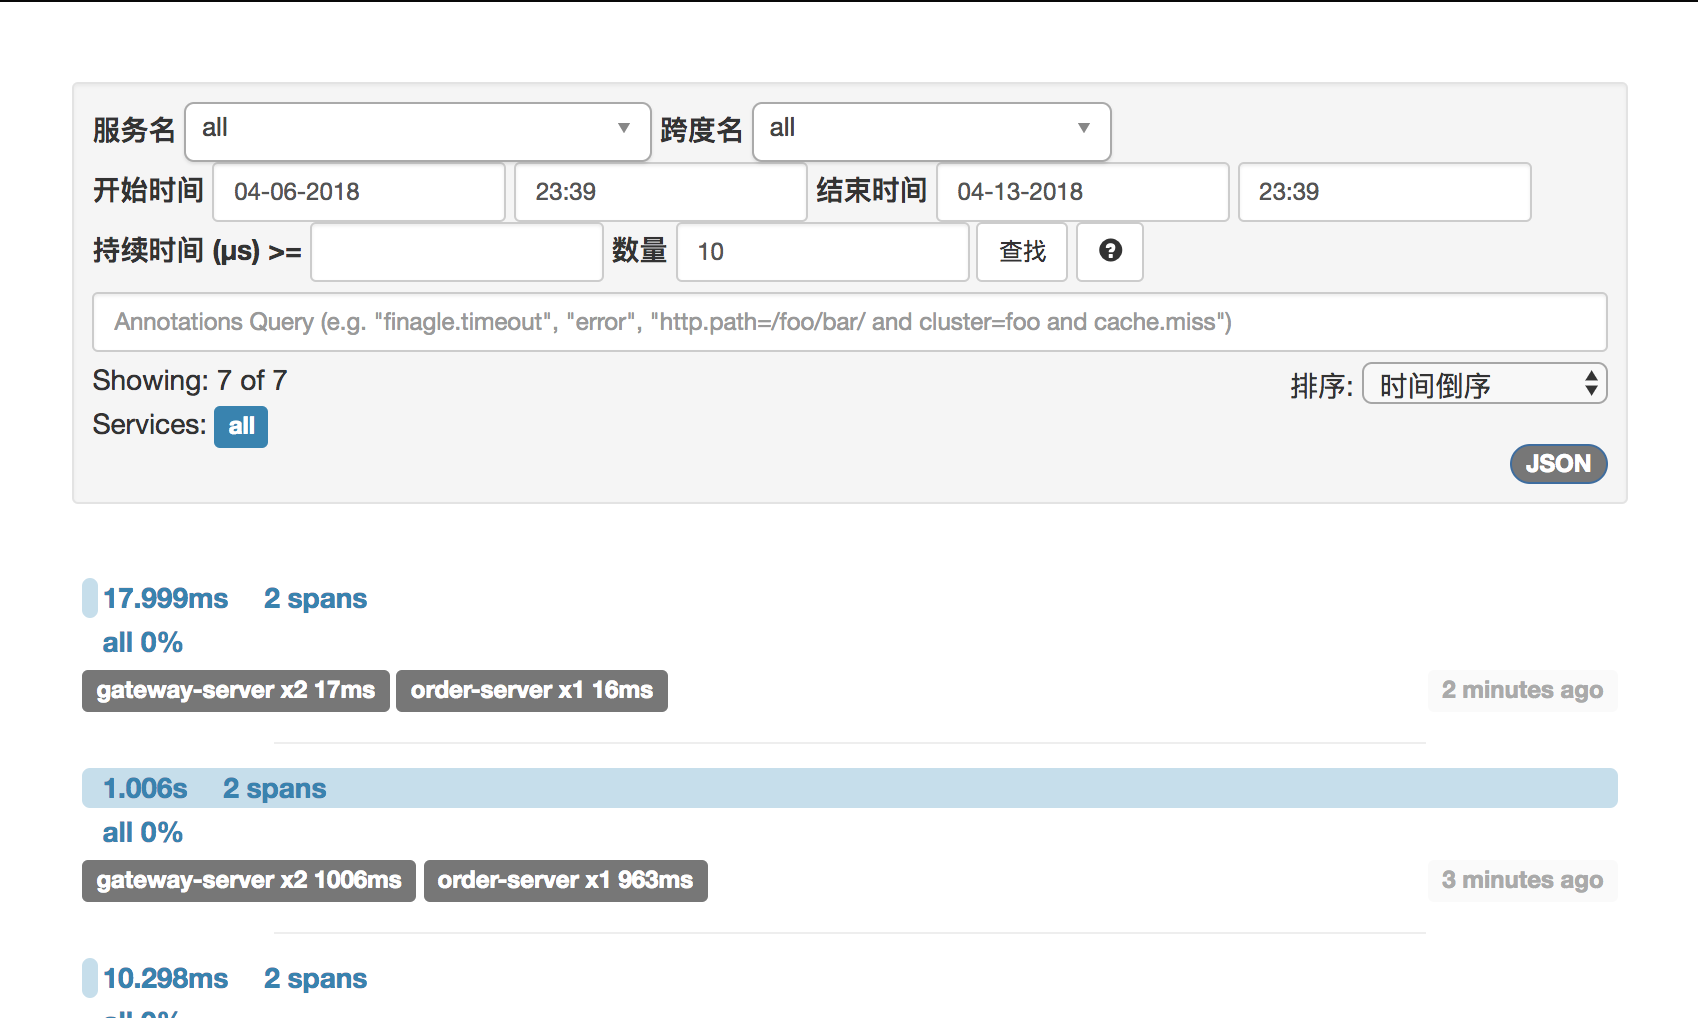
数据库里的相关数据:

SpringCloud学习之sleuth&zipkin【二】的更多相关文章
- SpringCloud学习之sleuth&zipkin
一.调用链跟踪的必要性 首先我们简单来看一下下单到支付的过程,别的不多说,在业务复杂的时候往往服务会一层接一层的调用,当某一服务环节出现响应缓慢时会影响整个服务的响应速度,由于业务调用层次很“深”,那 ...
- SpringCloud学习之Sleuth服务链路跟踪(十二)
一.为什么需要Spring Cloud Sleuth 微服务架构是一个分布式架构,它按业务划分服务单元,一个分布式系统往往有很多个服务单元.由于服务单元数量众多,业务的复杂性,如果出现了错误和异常,很 ...
- spring cloud 学习(8) - sleuth & zipkin 调用链跟踪
业务复杂的微服务架构中,往往服务之间的调用关系比较难梳理,一次http请求中,可能涉及到多个服务的调用(eg: service A -> service B -> service C... ...
- SpringCloud学习成长之十二 断路器监控
在我的第四篇文章断路器讲述了如何使用断路器,并简单的介绍了下Hystrix Dashboard组件,这篇文章更加详细的介绍Hystrix Dashboard. 一.Hystrix Dashboard简 ...
- SpringCloud学习成长之路二 服务客户端(rest+ribbon)
在微服务架构中,业务都会被拆分成一个独立的服务,服务与服务的通讯是基于http restful的. Spring cloud有两种服务调用方式,一种是ribbon+restTemplate,另一种是f ...
- springcloud微服务实战:Eureka+Zuul+Feign/Ribbon+Hystrix Turbine+SpringConfig+sleuth+zipkin
相信现在已经有很多小伙伴已经或者准备使用springcloud微服务了,接下来为大家搭建一个微服务框架,后期可以自己进行扩展.会提供一个小案例: 服务提供者和服务消费者 ,消费者会调用提供者的服务,新 ...
- SpringCloud Sleuth + Zipkin 实现链路追踪
一.Sleuth介绍 为什么要使用微服务跟踪? 它解决了什么问题? 1.微服务的现状? 随着业务的发展,单体架构变为微服务架构,并且系统规模也变得越来越大,各微服务间的调用关系也变得越来越复杂 ...
- SpringCloud学习(二):微服务入门实战项目搭建
一.开始使用Spring Cloud实战微服务 1.SpringCloud是什么? 云计算的解决方案?不是 SpringCloud是一个在SpringBoot的基础上构建的一个快速构建分布式系统的工具 ...
- springcloud -- sleuth+zipkin整合rabbitMQ详解
为什么使用RabbitMQ? 我们已经知道,zipkin的原理是服务之间的调用关系会通过HTTP方式上报到zipkin-server端,然后我们再通过zipkin-ui去调用查看追踪服务之间的调用链路 ...
随机推荐
- 学习UI的总结
学习前端有一段时间了,一直在看书上的理论知识,而实战项目却很少.老师常说,想要知道自己的实力有多少,知识掌握了多少,最好的方法就是去实践了,实践出真知嘛.于是在学习中,总要是通过项目的实践以及理论知识 ...
- UML开发工具Rose ralation的破解安装,
UML开发工具Rose ralation的在windows764破解安装, 安装下载还可以参考:http://www.cnblogs.com/leaven/p/3718361.html 跟大家分享怎么 ...
- GIT入门笔记(11)- 多种撤销修改场景和对策--实战练习
1.检查发现目前没有变化$ git statusOn branch masternothing to commit, working tree clean $ cat lsq.txt2222 2.修改 ...
- ASP.NET CORE系列【一】搭建ASP.NET CORE项目
为什么要使用 ASP.NET Core? NET Core 刚发布的时候根据介绍就有点心里痒痒,微软的尿性都懂的,新东西bug太多,现在2.0也发布很久了,决定研究一下. ASP.NET Core官方 ...
- NOPI实现导入导出泛型List,支持自定义列
概述 业务上需要自定义列的Excel的导入导出,在网上看了好多资料,很多都是有Bug而且都是支持Excel和DataTable的转换,所以自己总结了一下,应用.NET平台上的NPOI封装了支持自定义列 ...
- 记录下项目中常用到的JavaScript/JQuery代码二(大量实例)
记录下项目中常用到的JavaScript/JQuery代码一(大量实例) 1.input输入框监听变化 <input type="text" style="widt ...
- mysql 千万级数据查询效率实践,分析 mysql查询优化实践--本文只做了一部分,仅供参考
数据量, 1300万的表加上112万的表 注意: 本文只做了部分优化,并不全面,仅供参考, 欢迎指点. 请移步tim查看,因为写的时候在tim写的,粘贴过来截图有问题,就直接上链接了. https ...
- 2018 php的flush和ob_flush不起作用 整理解决
2018 php的flush和ob_flush不起作用 整理解决成功解决. 要点 : 使用函数 str_repeat2处配置:检查php.ini.Nginx 中有下面两个设置使用方式:echo str ...
- 【转】Linux下统计当前文件夹下的文件个数、目录个数
1) 统计当前文件夹下文件的个数 复制代码代码如下: ls -l |grep "^-"|wc -l 2) 统计当前文件夹下目录的个数 复制代码代码如下: ls -l |grep & ...
- 爬取IP
import urllib.request import re def url_open(url): req = urllib.request.Request(url,headers={'User-A ...