
Spark-2.0原理分析-shuffle过程
shuffle概览
shuffle过程概览
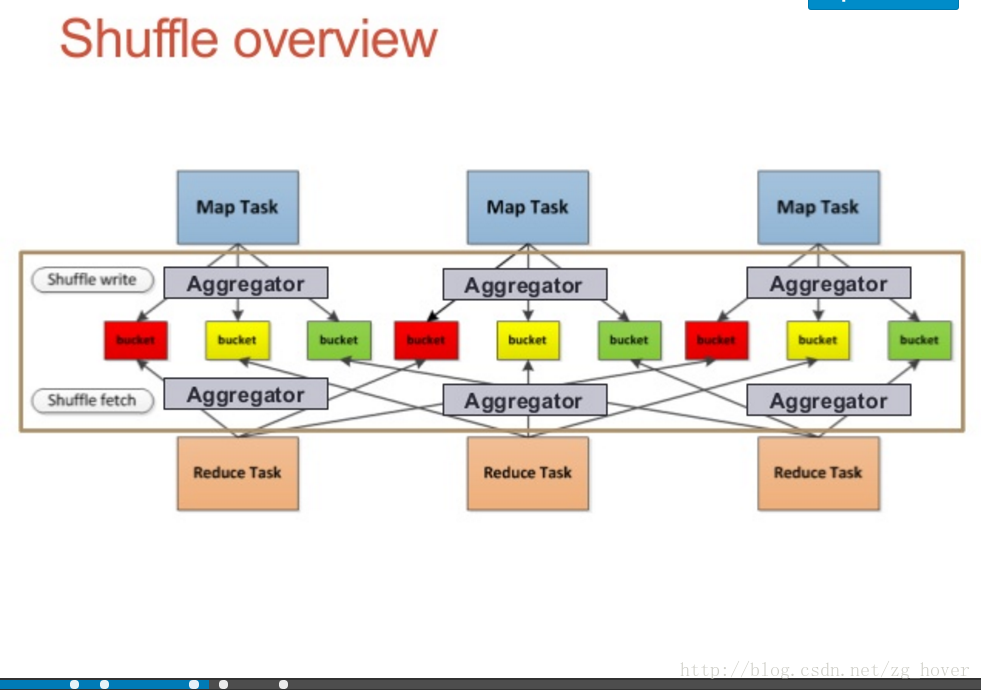
shuffle数据流概览
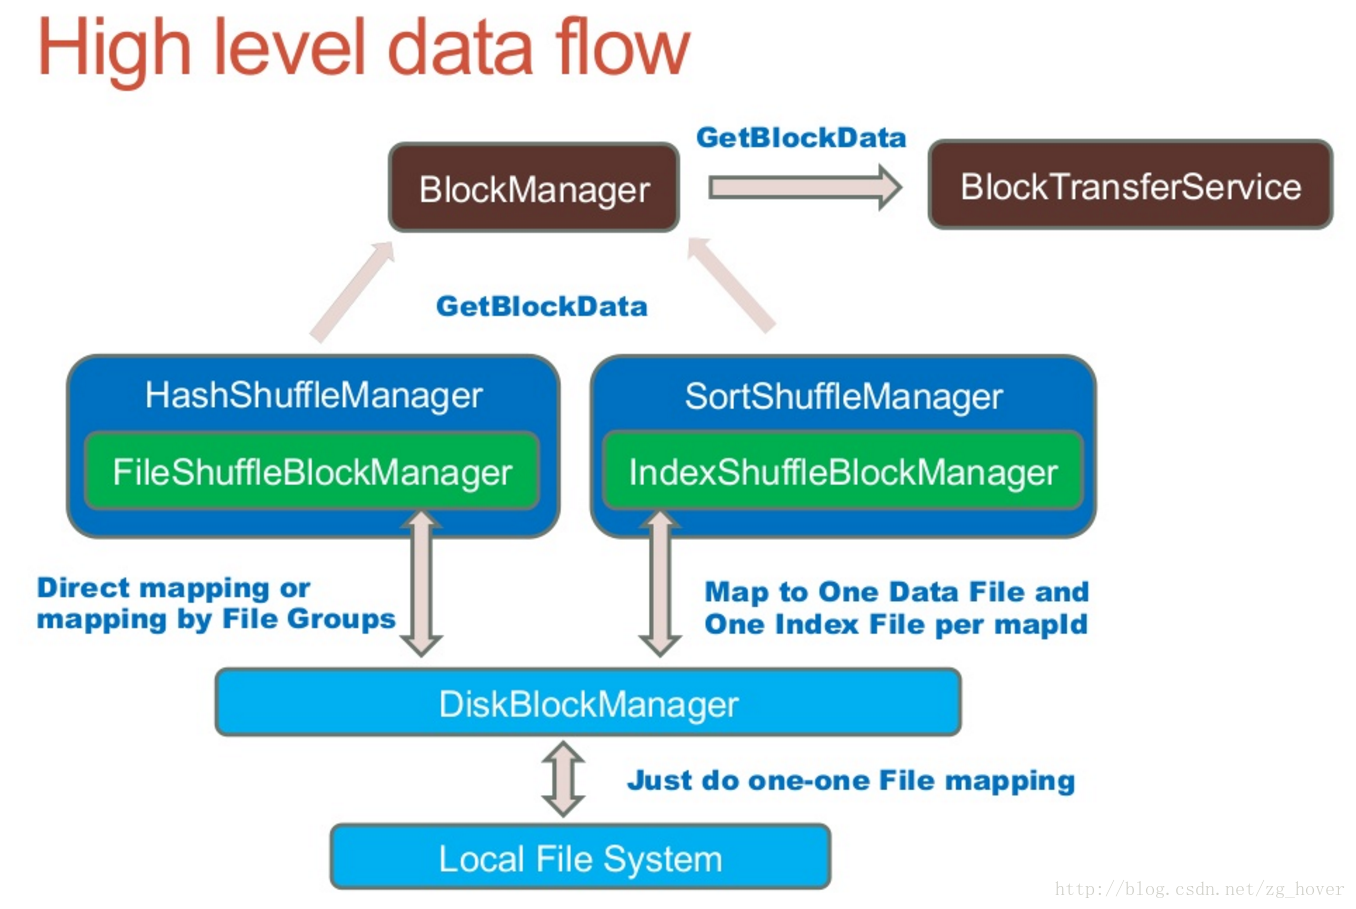
shuffle数据流
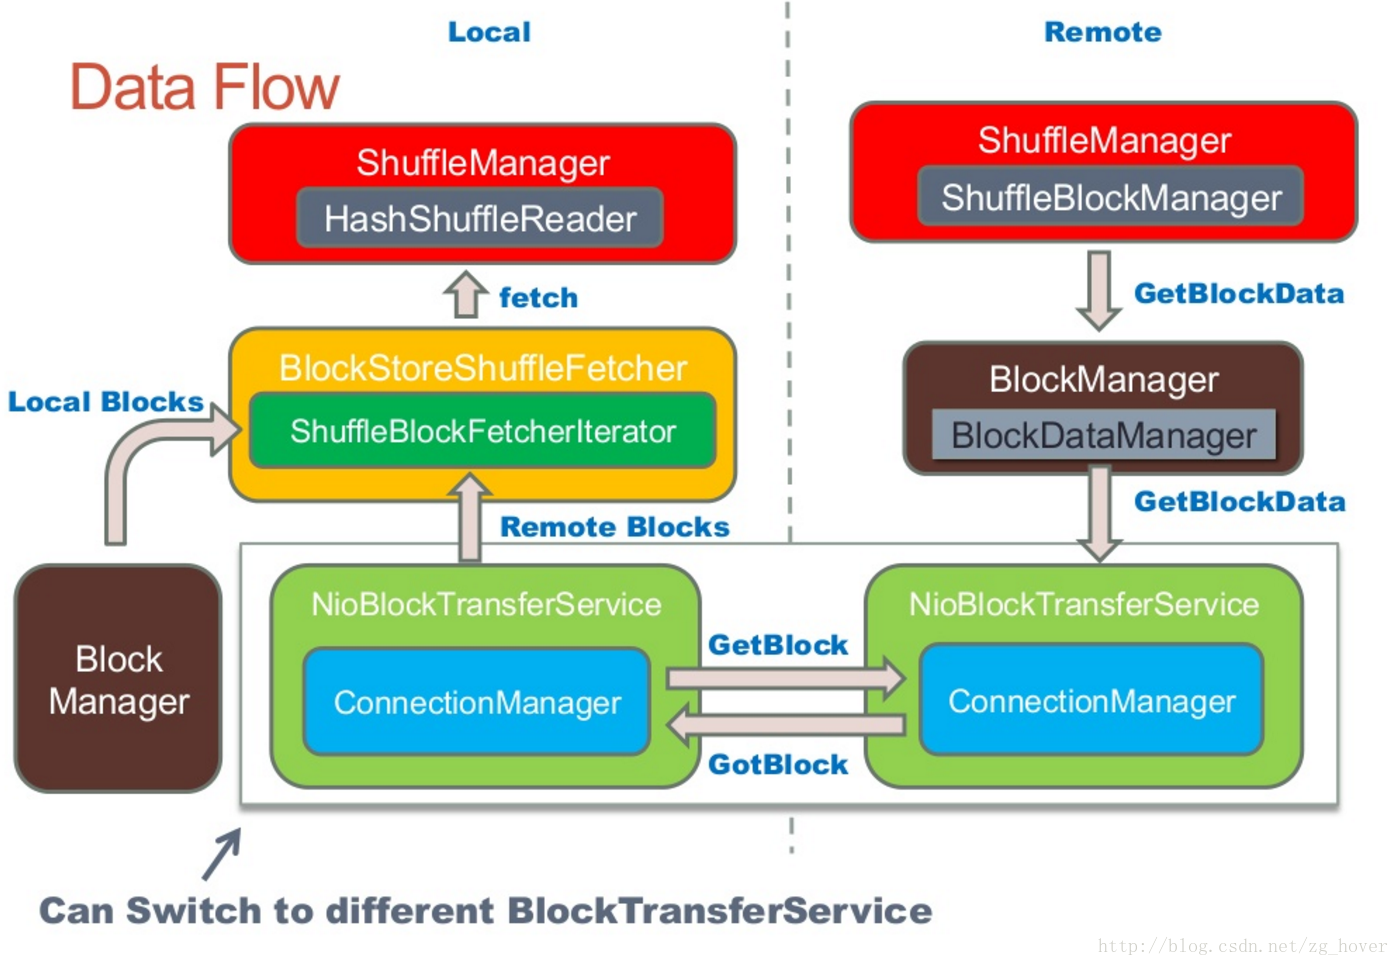
shuffle工作流程
在运行job时,spark是一个stage一个stage执行的。先把任务分成stage,在任务提交阶段会把任务形成taskset,在执行任务。
spark的DAGScheduler根据RDD的ShuffleDependency来构建Stages:
- 例如:ShuffleRDD/CoGroupedRDD有一个ShuffleDependency。
- 很多操作通过钩子函数来创建ShuffleRDD
每个ShuffleDependency会map到spark的job的一个stage,然后会导致一个shuffle过程。
为什么shuffle过程代价很大
这是由于shuffle过程可能需要完成以下过程:
- 重新进行数据分区
- 数据传输
- 数据压缩
- 磁盘I/O
shuffle的体系结构
ShuffleManager接口
shuffleManager是spark的shuffle系统的可插拔接口。ShuffleManager将会在driver和每个executor上的SparkEnv中进行创建。可以通过参数spark.shuffle.manager进行设置。
driver通过ShuffleManager来注册shuffle,并且executor通过它来读取和写入数据。
ShuffleWriter
控制shuffle数据输出逻辑。
ShuffleReader
获取shuffle过程中用于ShuffleRDD的数据。
ShuffleBlockManager
管理抽象的bucket和计算数据块之间的mapping过程。
基于sort的shuffle
sort-based的shuffle,会把输入的记录根据目标分区id(partition ids)进行排序。然后写入单个的map输出文件中。为了读取map的输出部分,Reducers获取此文件的连续区域 。当map输出的数据太大而内存无法存放时,输出的排序子集可以保存到磁盘,这些磁盘文件被合并后,生成最终的输出文件。
sort shuffle有两个不同的输出路径来产生map的输出文件:
- 序列化排序(Serialized sorting)
在使用序列化排序时,需要满足以下3个条件:- shuffle不指定聚合(aggregation)或输出排序方法。
- shuffle的序列化程序支持序列化值的重定位(KryoSerializer和Spark SQL的自定义序列化程序目前支持此操作)。
- shuffle产生小于16777216个输出分区。
- 反序列化排序(Deserialized sorting)
用来处理所有其他情况。
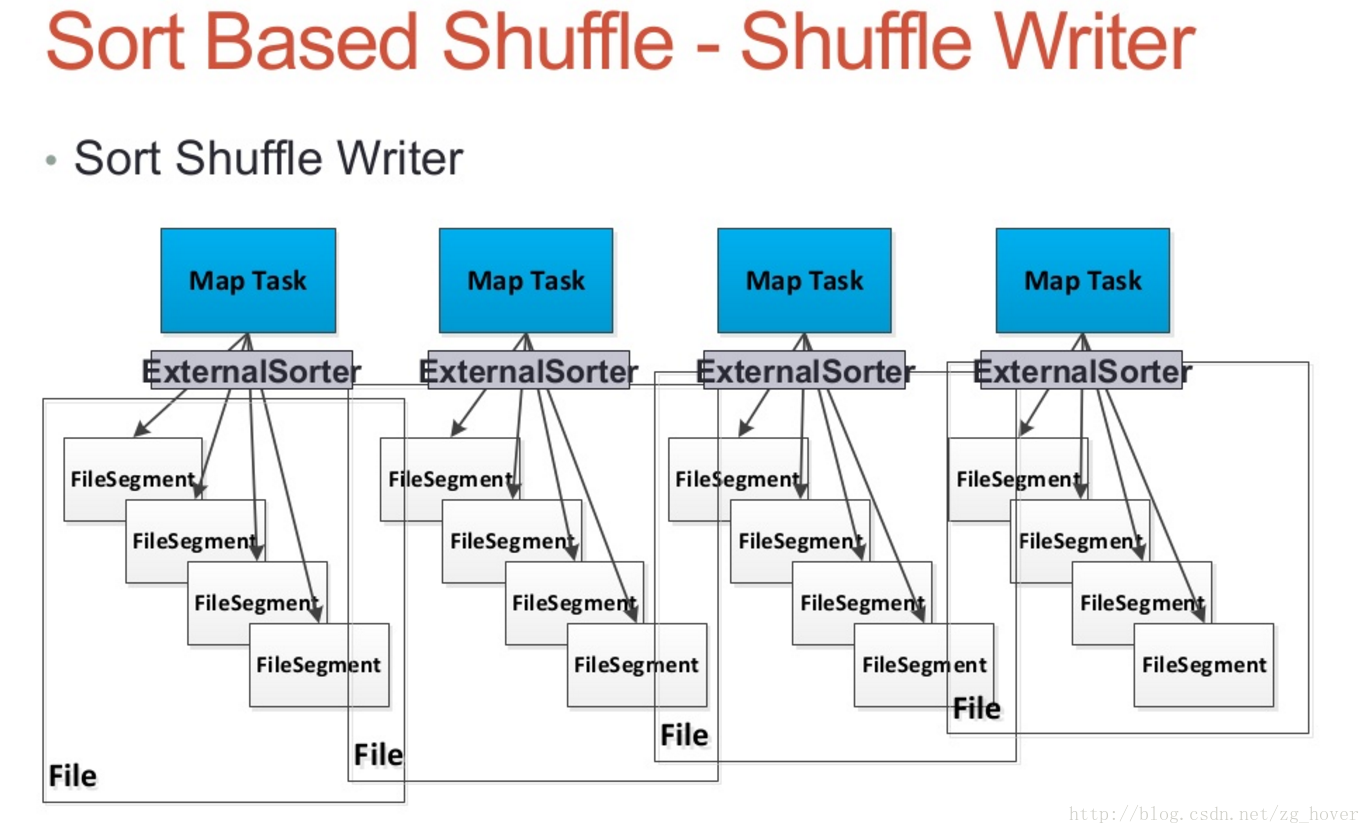
Sort Shuffle Manager
Sort Shuffle Writer
- 每个map任务都会产生一个shuffle数据文件,和一个Index文件
- 通过外部排序类ExternalSorter对数据进行排序
- 若map-side需要进行合并(combine)操作,数据将会按key和分区进行排序,若没有合并操作数据只会根据分区进行排序。
Spark-2.0原理分析-shuffle过程的更多相关文章
- Spark之Task原理分析
在Spark中,一个应用程序要想被执行,肯定要经过以下的步骤: 从这个路线得知,最终一个job是依赖于分布在集群不同节点中的task,通过并行或者并发的运行来完成真正的工作.由此可见 ...
- 小记--------spark的worker原理分析及源码分析
- Struts1.2,struts2.0原理分析
struts1原理: 1.首先我们表单提交到action 2.进入到web.xml 3.web.xml拦截*.do 4.交给ActionServlet 5.找到path属性,获得url 6.找到nam ...
- 小记--------spark内核架构原理分析
首先会将jar包上传到机器(服务器上) 1.在这台机器上会产生一个Application(也就是自己的spark程序) 2.然后通过spark-submit(shell) 提交程序 ...
- 彻底搞懂spark的shuffle过程(shuffle write)
什么时候需要 shuffle writer 假如我们有个 spark job 依赖关系如下 我们抽象出来其中的rdd和依赖关系: E <-------n------, ...
- Spark Shuffle 过程
本文参考:http://www.cnblogs.com/cenyuhai/p/3826227.html 在数据流动的整个过程中,最复杂最影响性能的环节,就是 Shuffle 过程,本文将参考大神的博客 ...
- Hadoop计算中的Shuffle过程(转)
Hadoop计算中的Shuffle过程 作者:左坚 来源:清华万博 时间:2013-07-02 15:04:44.0 Shuffle过程是MapReduce的核心,也被称为奇迹发生的地方.要想理解Ma ...
- spark的shuffle和原理分析
概述 Shuffle就是对数据进行重组,由于分布式计算的特性和要求,在实现细节上更加繁琐和复杂. 在MapReduce框架,Shuffle是连接Map和Reduce之间的桥梁,Map阶段 ...
- Spark的RDD原理以及2.0特性的介绍
转载自:http://www.tuicool.com/articles/7VNfyif 王联辉,曾在腾讯,Intel 等公司从事大数据相关的工作.2013 年 - 2016 年先后负责腾讯 Yarn ...
随机推荐
- window策略设置
gpedit.msc 组策略编辑器 secopl.msc 本地安全设置 共享(不用登录即可访问本地共享)设置: 运行里输入secpol.msc启动“本地安全设置”-“用户权利指派”-将“拒绝从网络访 ...
- 《转》Python学习(16)-python异常
转自 http://www.cnblogs.com/BeginMan/p/3171445.html 一.什么是错误,什么是异常,它们两者区别 这里解释如下:个人觉得很通俗易懂 错误是指在执行代码过程中 ...
- Androidの解决自动旋转导致activity重启问题
记录一下,经常在新建项目的时候就会发生这个问题,正好上次有个群友也问道了这个问题.就是设备屏幕打开自动旋转会导致activity重启,这样会消耗很多资源. 比如在加载listview数据会重新请求数据 ...
- 【Spring Boot&&Spring Cloud系列】Spring Boot中使用数据库之MySql
对于传统关系型数据库来说,Spring Boot使用JPA(Java Persistence API)资源库提供持久化的标准规范,即将Java的普通对象通过对象关系映射(ORM)持久化到数据库中. 项 ...
- UE和UI的区别
UI:User Interface的缩写,是指用户界面,最普遍的应用是在软件开发中,主要是指程序的用户操作界面的设计,随着Web应用的普及,UI也应用在了Web的用户界面规划上了.网站用户界面(Web ...
- Android NDK学习(4)使用cygwin生成.so库文件
转:http://www.cnblogs.com/fww330666557/archive/2012/12/14/2817389.html 简单的示例: makefile文件: LOCAL_PATH: ...
- java(1) 编程基础
1.classpath 环境变量 * 当java虚拟机需要运行一个类时,会在classpath 环境变量中所定义的路径下寻找所需的class文件 2.java 的基本语法 * java 语言是严格区分 ...
- css零零散散的笔记
1.div根据内容自适应大小 效果图: html: <body> <div class="parent"> <div class="chil ...
- GlusterFS六大卷模式說明
GlusterFS六大卷說明 第一,分佈卷 在分布式卷文件被随机地分布在整个砖的体积.使用分布式卷,你需要扩展存储,冗余是重要或提供其他硬件/软件层.(簡介:分布式卷,文件通过hash算法随机的分 ...
- 【黑金原创教程】【FPGA那些事儿-驱动篇I 】实验十三:串口模块② — 接收
实验十三:串口模块② - 接收 我们在实验十二实现了串口发送,然而这章实验则要实现串口接收 ... 在此,笔者也会使用其它思路实现串口接收. 图13.1 模块之间的数据传输. 假设我们不考虑波特率,而 ...