
Hadoop学习笔记——WordCount
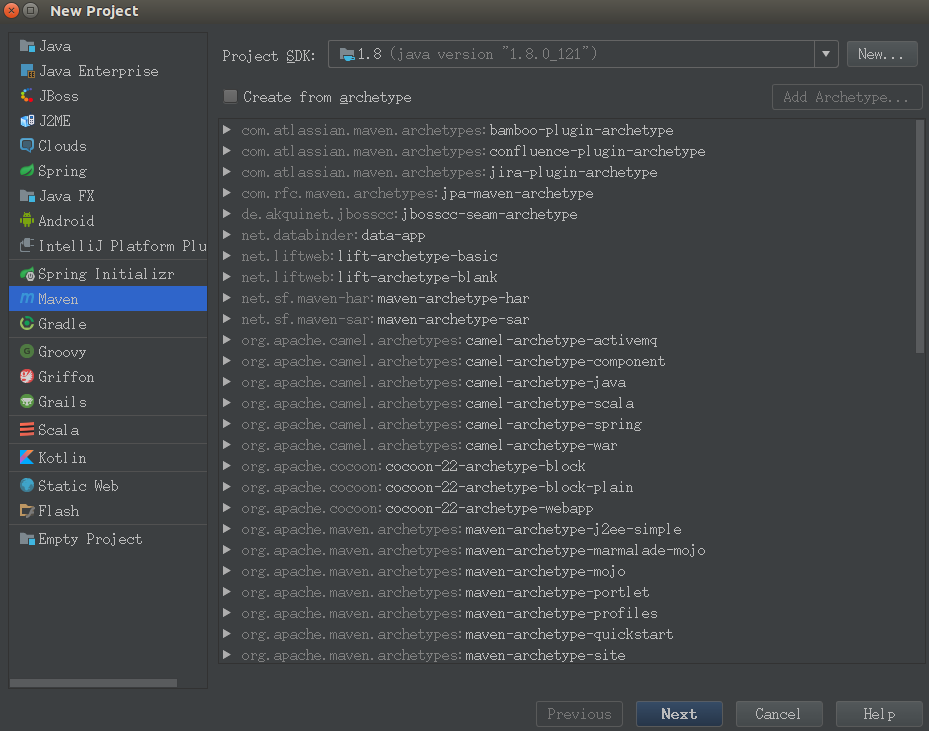
1.在IDEA下新建工程,选择from Mevan
GroupId:WordCount
ArtifactId:com.hadoop.1st
Project name:WordCount
2.pom.xml文件
<?xml version="1.0" encoding="UTF-8"?>

<project xmlns="http://maven.apache.org/POM/4.0.0"

         xmlns:xsi="http://www.w3.org/2001/XMLSchema-instance"

         xsi:schemaLocation="http://maven.apache.org/POM/4.0.0 http://maven.apache.org/xsd/maven-4.0.0.xsd">

    <modelVersion>4.0.0</modelVersion>

    <groupId>WordCount</groupId>

    <artifactId>com.hadoop.1st</artifactId>

    <version>1.0-SNAPSHOT</version>

    <repositories>

        <repository>

            <id>apache</id>

            <url>http://maven.apache.org</url>

        </repository>

    </repositories>

    <dependencies>

        <dependency>

            <groupId>org.apache.hadoop</groupId>

            <artifactId>hadoop-core</artifactId>

            <version>1.2.1</version>

        </dependency>

        <dependency>

            <groupId>org.apache.hadoop</groupId>

            <artifactId>hadoop-common</artifactId>

            <version>2.7.1</version>

        </dependency>

    </dependencies>

    <build>

        <plugins>

            <plugin>

                <artifactId>maven-dependency-plugin</artifactId>

                <configuration>

                    <excludeTransitive>false</excludeTransitive>

                    <stripVersion>true</stripVersion>

                    <outputDirectory>./lib</outputDirectory>

                </configuration>

            </plugin>

        </plugins>

    </build>

</project>
3.main/java目录下新建WordCount.java文件
import org.apache.hadoop.conf.Configuration;

import org.apache.hadoop.fs.Path;

import org.apache.hadoop.io.IntWritable;

import org.apache.hadoop.io.LongWritable;

import org.apache.hadoop.io.Text;

import org.apache.hadoop.mapreduce.Job;

import org.apache.hadoop.mapreduce.Mapper;

import org.apache.hadoop.mapreduce.Reducer;

import org.apache.hadoop.mapreduce.lib.input.FileInputFormat;

import org.apache.hadoop.mapreduce.lib.input.TextInputFormat;

import org.apache.hadoop.mapreduce.lib.output.FileOutputFormat;

import org.apache.hadoop.mapreduce.lib.output.TextOutputFormat;

import java.io.IOException;

import java.util.StringTokenizer;

/**

 * Created by common on 17-3-26.

 */

public class WordCount {

    public static class WordCountMap extends

            Mapper<LongWritable, Text, Text, IntWritable> {

        private final IntWritable one = new IntWritable(1);

        private Text word = new Text();

        public void map(LongWritable key, Text value, Context context)

                throws IOException, InterruptedException {

            String line = value.toString();

            StringTokenizer token = new StringTokenizer(line);

            while (token.hasMoreTokens()) {

                word.set(token.nextToken());

                context.write(word, one);

            }

        }

    }

    public static class WordCountReduce extends

            Reducer<Text, IntWritable, Text, IntWritable> {

        public void reduce(Text key, Iterable<IntWritable> values,

                           Context context) throws IOException, InterruptedException {

            int sum = 0;

            for (IntWritable val : values) {

                sum += val.get();

            }

            context.write(key, new IntWritable(sum));

        }

    }

    public static void main(String[] args) throws Exception {

        Configuration conf = new Configuration();

        Job job = new Job(conf);

        job.setJarByClass(WordCount.class);

        job.setJobName("wordcount");

        job.setOutputKeyClass(Text.class);

        job.setOutputValueClass(IntWritable.class);

        job.setMapperClass(WordCountMap.class);

        job.setReducerClass(WordCountReduce.class);

        job.setInputFormatClass(TextInputFormat.class);

        job.setOutputFormatClass(TextOutputFormat.class);

        FileInputFormat.addInputPath(job, new Path(args[0]));

        FileOutputFormat.setOutputPath(job, new Path(args[1]));

        job.waitForCompletion(true);

    }

}
4.在src同级目录下新建input目录,以及下面的test.segmented文件
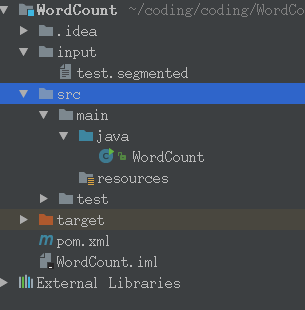
test.segmented文件内容
aa

bb

cc

dd

aa

cc

ee

ff

ff

gg

hh

aa
4.在run configuration下设置运行方式为Application
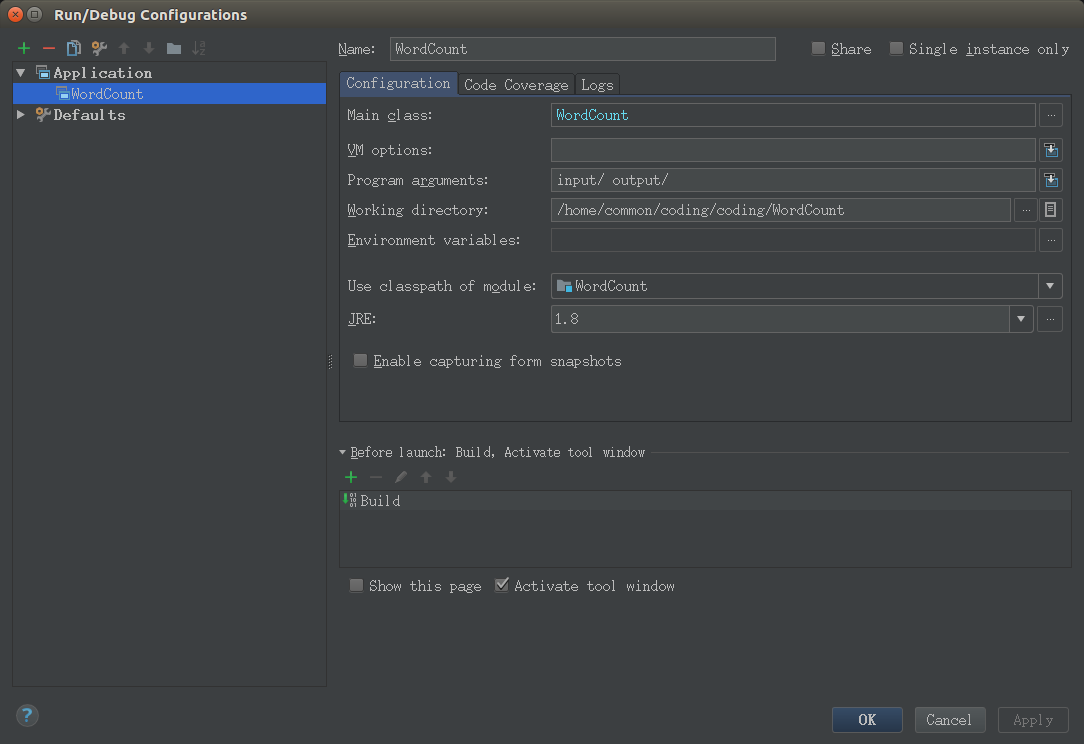
5.运行java文件,将会生成output目录,part-r-00000为运行的结果,下次运行必须删除output目录,否则会报错

Hadoop学习笔记——WordCount的更多相关文章
- Hadoop学习笔记(7) ——高级编程
Hadoop学习笔记(7) ——高级编程 从前面的学习中,我们了解到了MapReduce整个过程需要经过以下几个步骤: 1.输入(input):将输入数据分成一个个split,并将split进一步拆成 ...
- Hadoop学习笔记(6) ——重新认识Hadoop
Hadoop学习笔记(6) ——重新认识Hadoop 之前,我们把hadoop从下载包部署到编写了helloworld,看到了结果.现是得开始稍微更深入地了解hadoop了. Hadoop包含了两大功 ...
- Hadoop学习笔记(2)
Hadoop学习笔记(2) ——解读Hello World 上一章中,我们把hadoop下载.安装.运行起来,最后还执行了一个Hello world程序,看到了结果.现在我们就来解读一下这个Hello ...
- Hadoop学习笔记(5) ——编写HelloWorld(2)
Hadoop学习笔记(5) ——编写HelloWorld(2) 前面我们写了一个Hadoop程序,并让它跑起来了.但想想不对啊,Hadoop不是有两块功能么,DFS和MapReduce.没错,上一节我 ...
- Hadoop学习笔记(2) ——解读Hello World
Hadoop学习笔记(2) ——解读Hello World 上一章中,我们把hadoop下载.安装.运行起来,最后还执行了一个Hello world程序,看到了结果.现在我们就来解读一下这个Hello ...
- Hadoop学习笔记(1) ——菜鸟入门
Hadoop学习笔记(1) ——菜鸟入门 Hadoop是什么?先问一下百度吧: [百度百科]一个分布式系统基础架构,由Apache基金会所开发.用户可以在不了解分布式底层细节的情况下,开发分布式程序. ...
- Hadoop学习笔记(1)(转)
Hadoop学习笔记(1) ——菜鸟入门 Hadoop是什么?先问一下百度吧: [百度百科]一个分布式系统基础架构,由Apache基金会所开发.用户可以在不了解分布式底层细节的情况下,开发分布式程序. ...
- Hadoop学习笔记(4) ——搭建开发环境及编写Hello World
Hadoop学习笔记(4) ——搭建开发环境及编写Hello World 整个Hadoop是基于Java开发的,所以要开发Hadoop相应的程序就得用JAVA.在linux下开发JAVA还数eclip ...
- Hadoop学习笔记—22.Hadoop2.x环境搭建与配置
自从2015年花了2个多月时间把Hadoop1.x的学习教程学习了一遍,对Hadoop这个神奇的小象有了一个初步的了解,还对每次学习的内容进行了总结,也形成了我的一个博文系列<Hadoop学习笔 ...
随机推荐
- 【机器学习】K近邻算法——多分类问题
给定一个训练数据集,对新的输入实例,在训练数据集中找到与该实例最邻近的K个实例,这K个实例的多数属于某个类,就把该类输入实例分为这个类. KNN是通过测量不同特征值之间的距离进行分类.它的的思路是:如 ...
- 轻量级Modal模态框插件cta.js
今天给大家分享一款轻量级Modal模态框插件cta.js.这是一款无需使用jQuery插件,纯js编写的模态框弹出特效.效果图如下: 在线预览 源码下载 实现的代码. html代码: <se ...
- 【转】oracle & 和 ' 特殊字符处理 ( like 'GAC/&_%' escape '&'; 这里面的 / 居然将& 转义了 为什么?)
原文地址:http://blog.csdn.net/gjswxhb/article/details/6083242 今天在导入一批数据到Oracle时,碰到了一个问题:Toad提示(plsql 也一样 ...
- android开发——从相冊中选择图片不裁剪
转载请注明出处:http://blog.csdn.net/zhoubin1992/article/details/46864777 问题: 在郭神的第一行代码中,第8章的从相冊中选择图片这块,从相冊选 ...
- 快速理解RequireJs(转)
RequireJs已经流行很久了,我们在项目中也打算使用它.它提供了以下功能: 声明不同js文件之间的依赖 可以按需.并行.延时载入js库 可以让我们的代码以模块化的方式组织 初看起来并不复杂. 在h ...
- C语言 · 陶陶摘苹果2
算法提高 陶陶摘苹果2 时间限制:1.0s 内存限制:256.0MB 问题描述 陶陶家的院子里有一棵苹果树,每到秋天树上就会结出n个苹果.苹果成熟的时候,陶陶就会跑去摘苹果.陶陶有个 ...
- vnc 登录 Ubuntu gnome 桌面出现 QXcbConnection : Failed to initialize XRandr 错误,然后打不开
现象如下: 解决方法是在 启动的时候加入 -noload Welcome 参数 也可以在 ~/.local/share/applications/DigiaQt-qtcreator-community ...
- pppoe应用概述
PPPOE简述 PPP主要是用来通过拨号或专线方式在两个网络节点之间建立连接.发送数据.PPP是一种分层协议,物理层用来进行实际的点到点连接.由链路控制层(LCP)发起对链路的建立.配置和测试.在LC ...
- QPushButton取消按压后文字下沉效果
1.下沉原因 1.1.QPushButton源码 void QPushButton::initStyleOption(QStyleOptionButton *option) const { if (d ...
- CSS(八):定位属性
一.position属性 1.relative(相对定位) 相对它原来的位置,通过指定偏移,到达新的位置. 扔在标准流中,它对父级盒子和相邻的盒子都没有任何影响. 看下面的例子: <!DOCTY ...