
CUDA学习笔记1:第一个CUDA实例
一、cuda简介
二、运行例子的方法:

建完工程后会有一部分代码

在主函数return 0 之前加入getchar();即可运行,关于此代码后期可慢慢研究,这里不做讲解。
源码为:
#include "cuda_runtime.h"

#include "device_launch_parameters.h"

#include <stdio.h>

cudaError_t addWithCuda(int *c, const int *a, const int *b, unsigned int size);

__global__ void addKernel(int *c, const int *a, const int *b)

{

    int i = threadIdx.x;

    c[i] = a[i] + b[i];

}

int main()

{

    const int arraySize = ;

    const int a[arraySize] = { , , , ,  };

    const int b[arraySize] = { , , , ,  };

    int c[arraySize] = {  };

    // Add vectors in parallel.

    cudaError_t cudaStatus = addWithCuda(c, a, b, arraySize);

    if (cudaStatus != cudaSuccess) {

        fprintf(stderr, "addWithCuda failed!");

        return ;

    }

    printf("{1,2,3,4,5} + {10,20,30,40,50} = {%d,%d,%d,%d,%d}\n",

        c[], c[], c[], c[], c[]);

    // cudaDeviceReset must be called before exiting in order for profiling and

    // tracing tools such as Nsight and Visual Profiler to show complete traces.

    cudaStatus = cudaDeviceReset();

    if (cudaStatus != cudaSuccess) {

        fprintf(stderr, "cudaDeviceReset failed!");

        return ;

    }

    getchar();

    return ;

}

// Helper function for using CUDA to add vectors in parallel.

cudaError_t addWithCuda(int *c, const int *a, const int *b, unsigned int size)

{

    int *dev_a = ;

    int *dev_b = ;

    int *dev_c = ;

    cudaError_t cudaStatus;

    // Choose which GPU to run on, change this on a multi-GPU system.

    cudaStatus = cudaSetDevice();

    if (cudaStatus != cudaSuccess) {

        fprintf(stderr, "cudaSetDevice failed!  Do you have a CUDA-capable GPU installed?");

        goto Error;

    }

    // Allocate GPU buffers for three vectors (two input, one output)    .

    cudaStatus = cudaMalloc((void**)&dev_c, size * sizeof(int));

    if (cudaStatus != cudaSuccess) {

        fprintf(stderr, "cudaMalloc failed!");

        goto Error;

    }

    cudaStatus = cudaMalloc((void**)&dev_a, size * sizeof(int));

    if (cudaStatus != cudaSuccess) {

        fprintf(stderr, "cudaMalloc failed!");

        goto Error;

    }

    cudaStatus = cudaMalloc((void**)&dev_b, size * sizeof(int));

    if (cudaStatus != cudaSuccess) {

        fprintf(stderr, "cudaMalloc failed!");

        goto Error;

    }

    // Copy input vectors from host memory to GPU buffers.

    cudaStatus = cudaMemcpy(dev_a, a, size * sizeof(int), cudaMemcpyHostToDevice);

    if (cudaStatus != cudaSuccess) {

        fprintf(stderr, "cudaMemcpy failed!");

        goto Error;

    }

    cudaStatus = cudaMemcpy(dev_b, b, size * sizeof(int), cudaMemcpyHostToDevice);

    if (cudaStatus != cudaSuccess) {

        fprintf(stderr, "cudaMemcpy failed!");

        goto Error;

    }

    // Launch a kernel on the GPU with one thread for each element.

    addKernel<<<, size>>>(dev_c, dev_a, dev_b);

    // Check for any errors launching the kernel

    cudaStatus = cudaGetLastError();

    if (cudaStatus != cudaSuccess) {

        fprintf(stderr, "addKernel launch failed: %s\n", cudaGetErrorString(cudaStatus));

        goto Error;

    }

    // cudaDeviceSynchronize waits for the kernel to finish, and returns

    // any errors encountered during the launch.

    cudaStatus = cudaDeviceSynchronize();

    if (cudaStatus != cudaSuccess) {

        fprintf(stderr, "cudaDeviceSynchronize returned error code %d after launching addKernel!\n", cudaStatus);

        goto Error;

    }

    // Copy output vector from GPU buffer to host memory.

    cudaStatus = cudaMemcpy(c, dev_c, size * sizeof(int), cudaMemcpyDeviceToHost);

    if (cudaStatus != cudaSuccess) {

        fprintf(stderr, "cudaMemcpy failed!");

        goto Error;

    }

Error:

    cudaFree(dev_c);

    cudaFree(dev_a);

    cudaFree(dev_b);

    return cudaStatus;

}
三、实战代码:
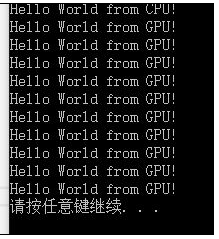
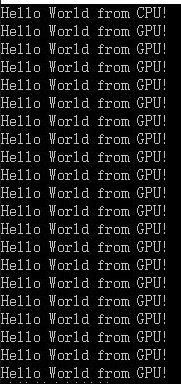
例一:第一个程序hello world
#include "cuda_runtime.h"

#include "device_launch_parameters.h"

#include <stdio.h>

#include <Windows.h>

__global__ void helloFromGPU(void)

{

    printf("Hello World from GPU!\n");

}

int main(void)

{

    // hello from cpu

    cudaError_t cudaStatus;

    printf("Hello World from CPU!\n");

    helloFromGPU << <,  >> > ();

    cudaDeviceReset();//重置CUDA设备释放程序占用的资源

    system("pause");

    return ;

}
无视所有错误直接运行即可。
例二:参数的传入
#include "cuda_runtime.h"

#include "device_launch_parameters.h"

#include <stdio.h>

#include <Windows.h>

__global__ void Add(int i, int j)

{

    int count;

    count = i + j;

    printf("\nNum is %d\n", count);

}

int main(void)

{

    Add << <,  >> >(, );

    cudaDeviceReset();//重置CUDA设备释放程序占用的资源

    system("pause");

    return ;

}
传入参数与一般的c没有什么不一样之处
例三:数据的传入和传出
__global__ void Decrease(int a, int b, int *c)

{

    *c = a - b;

}
#include "cuda_runtime.h"

#include "device_launch_parameters.h"

#include <stdio.h>

#include <Windows.h>

void addWithCuda(int *c);//1.定义传入的函数c

int main(void)

{

    int c;

    c = ;

    addWithCuda(&c);//2.传入参数变量(地址)

    cudaDeviceReset();//6.重置CUDA设备释放程序占用的资源

    printf("Value is %d", c);//7.主机上打印显示数据

    system("pause");

    return ;

}

__global__ void Decrease(int a, int b, int *c)

{

    *c = a - b;

}

void addWithCuda(int *c)

{

    int *dev_c = ;//这个相当于内存和显存有一样的

    //3.请求CUDA设备的内存(显存),执行CUDA函数

    cudaMalloc((void**)&dev_c, sizeof(int));

    Decrease << <,  >> >(, , dev_c);

    //4.等待设备所有线程任务执行完毕

    cudaDeviceSynchronize();

    //5.数据复制到主机,释放占用空间

    cudaMemcpy(c, dev_c, sizeof(int), cudaMemcpyDeviceToHost);

    cudaFree(dev_c);

}
例四:数据的传入和传出Ⅱ
__global__ void Decrease(int *a, int *b, int *c)

{

     *c = *a - *b;

}
void addWithCuda(int *c, int *a, int *b)

{

    int *dev_c = ;

    int *dev_a = ;

    int *dev_b = ;

    //3.请求CUDA设备的内存(显存),执行CUDA函数

    cudaMalloc((void**)&dev_c, sizeof(int));

    cudaMalloc((void**)&dev_a, sizeof(int));

    cudaMalloc((void**)&dev_b, sizeof(int));

    //4.从主机复制数据到设备上

    cudaMemcpy(dev_a, a, sizeof(int), cudaMemcpyHostToDevice);

    cudaMemcpy(dev_b, b, sizeof(int), cudaMemcpyHostToDevice);

    Decrease << < ,  >> >(dev_a, dev_b, dev_c);

    //5.等待设备所有线程任务执行完毕

    cudaDeviceSynchronize();

    //6.数据复制到主机,释放占用空间

    cudaMemcpy(c, dev_c, sizeof(int), cudaMemcpyDeviceToHost);

    cudaFree(dev_c);

    cudaFree(dev_a);

    cudaFree(dev_b);

}
int main(void)

{

    int c;

    int a, b;

    c = ;

    a = ;

    b = ;

    addWithCuda(&c, &a, &b);//2.传入参数变量(地址)

    cudaDeviceReset();//7.重置CUDA设备释放程序占用的资源

    printf("Value is %d", c);//8.主机上打印显示数据

    system("pause");

    return ;

}
5.代码:
#include "cuda_runtime.h"

#include "device_launch_parameters.h"

#include <stdio.h>

#include <Windows.h>

__global__ void Decrease(int *a, int *b, int *c)

{

    *c = *a - *b;

}

void addWithCuda(int *c, int *a, int *b)

{

    int *dev_c = ;

    int *dev_a = ;

    int *dev_b = ;

    //3.请求CUDA设备的内存(显存),执行CUDA函数

    cudaMalloc((void**)&dev_c, sizeof(int));

    cudaMalloc((void**)&dev_a, sizeof(int));

    cudaMalloc((void**)&dev_b, sizeof(int));

    //4.从主机复制数据到设备上

    cudaMemcpy(dev_a, a, sizeof(int), cudaMemcpyHostToDevice);

    cudaMemcpy(dev_b, b, sizeof(int), cudaMemcpyHostToDevice);

    Decrease << < ,  >> >(dev_a, dev_b, dev_c);

    //5.等待设备所有线程任务执行完毕

    cudaDeviceSynchronize();

    //6.数据复制到主机,释放占用空间

    cudaMemcpy(c, dev_c, sizeof(int), cudaMemcpyDeviceToHost);

    cudaFree(dev_c);

    cudaFree(dev_a);

    cudaFree(dev_b);

}

int main(void)

{

    int c;

    int a, b;

    c = ;

    a = ;

    b = ;

    addWithCuda(&c, &a, &b);//2.传入参数变量(地址)

    cudaDeviceReset();//7.重置CUDA设备释放程序占用的资源

    printf("Value is %d", c);//8.主机上打印显示数据

    system("pause");

    return ;

}
最后再放一个程序关于循环可以自行理解
程序实现向量的加法操作,使用了一个block内部的512个线程。
#include <stdio.h>

#include<cuda_runtime.h>

//__global__声明的函数,告诉编译器这段代码交由CPU调用,由GPU执行

__global__ void add(const int *dev_a,const int *dev_b,int *dev_c)

{

    int i=threadIdx.x;

    dev_c[i]=dev_a[i]+dev_b[i];

}

int main(void)

{

    //申请主机内存,并进行初始化

    int host_a[],host_b[],host_c[];

    for(int i=;i<;i++)

    {

        host_a[i]=i;

        host_b[i]=i<<;

    }

    //定义cudaError,默认为cudaSuccess(0)

    cudaError_t err = cudaSuccess;

    //申请GPU存储空间

    int *dev_a,*dev_b,*dev_c;

    err=cudaMalloc((void **)&dev_a, sizeof(int)*);

    err=cudaMalloc((void **)&dev_b, sizeof(int)*);

    err=cudaMalloc((void **)&dev_c, sizeof(int)*);

    if(err!=cudaSuccess)

    {

        printf("the cudaMalloc on GPU is failed");

        return ;

    }

    printf("SUCCESS");

    //将要计算的数据使用cudaMemcpy传送到GPU

    cudaMemcpy(dev_a,host_a,sizeof(host_a),cudaMemcpyHostToDevice);

    cudaMemcpy(dev_b,host_b,sizeof(host_b),cudaMemcpyHostToDevice);

    //调用核函数在GPU上执行。数据较少,之使用一个Block,含有512个线程

    add<<<,>>>(dev_a,dev_b,dev_c);

    cudaMemcpy(&host_c,dev_c,sizeof(host_c),cudaMemcpyDeviceToHost);

    for(int i=;i<;i++)

        printf("host_a[%d] + host_b[%d] = %d + %d = %d\n",i,i,host_a[i],host_b[i],host_c[i]);

    cudaFree(dev_a);//释放GPU内存

    cudaFree(dev_b);//释放GPU内存

    cudaFree(dev_c);//释放GPU内存

    return  ;

}
CUDA学习笔记1:第一个CUDA实例的更多相关文章
- CUDA学习笔记(三)——CUDA内存
转自:http://blog.sina.com.cn/s/blog_48b9e1f90100fm5f.html 结合lec07_intro_cuda.pptx学习 内存类型 CGMA: Compute ...
- CUDA学习笔记(四)——CUDA性能
转自:http://blog.sina.com.cn/s/blog_48b9e1f90100fm5h.html 四.CUDA性能 CUDA中的block被划分成一个个的warp,在GeForce880 ...
- CUDA学习笔记(一)——CUDA编程模型
转自:http://blog.sina.com.cn/s/blog_48b9e1f90100fm56.html CUDA的代码分成两部分,一部分在host(CPU)上运行,是普通的C代码:另一部分在d ...
- CUDA学习笔记(二)——CUDA线程模型
转自:http://blog.sina.com.cn/s/blog_48b9e1f90100fm5b.html 一个grid中的所有线程执行相同的内核函数,通过坐标进行区分.这些线程有两级的坐标,bl ...
- python3.4学习笔记(十四) 网络爬虫实例代码,抓取新浪爱彩双色球开奖数据实例
python3.4学习笔记(十四) 网络爬虫实例代码,抓取新浪爱彩双色球开奖数据实例 新浪爱彩双色球开奖数据URL:http://zst.aicai.com/ssq/openInfo/ 最终输出结果格 ...
- python3.4学习笔记(十一) 列表、数组实例
python3.4学习笔记(十一) 列表.数组实例 #python列表,数组类型要相同,python不需要指定数据类型,可以把各种类型打包进去#python列表可以包含整数,浮点数,字符串,对象#创建 ...
- Spark学习笔记1——第一个Spark程序:单词数统计
Spark学习笔记1--第一个Spark程序:单词数统计 笔记摘抄自 [美] Holden Karau 等著的<Spark快速大数据分析> 添加依赖 通过 Maven 添加 Spark-c ...
- C#.NET学习笔记2---C#.第一个C#程序
C#.NET学习笔记2---C#.第一个C#程序 技术qq交流群:JavaDream:251572072 教程下载,在线交流:创梦IT社区:www.credream.com 6.第一个C#程序: ...
- OGG学习笔记02-单向复制配置实例
OGG学习笔记02-单向复制配置实例 实验环境: 源端:192.168.1.30,Oracle 10.2.0.5 单实例 目标端:192.168.1.31,Oracle 10.2.0.5 单实例 1. ...
- Unity3D学习笔记2——绘制一个带纹理的面
目录 1. 概述 2. 详论 2.1. 网格(Mesh) 2.1.1. 顶点 2.1.2. 顶点索引 2.2. 材质(Material) 2.2.1. 创建材质 2.2.2. 使用材质 2.3. 光照 ...
随机推荐
- linux下C语言实现的内存池【转】
转自:http://blog.chinaunix.net/uid-28458801-id-4254501.html 操作系统:ubuntu10.04 前言: 在通信过程中,无法知道将会接收到的 ...
- 大端小端转换,le32_to_cpu 和cpu_to_le32
字节序 http://oss.org.cn/kernel-book/ldd3/ch11s04.html 小心不要假设字节序. PC 存储多字节值是低字节为先(小端为先, 因此是小端), 一些高级的平台 ...
- [转载]hazard pointer
hazard pointer 转载自: http://hi.baidu.com/rodimus/item/f6539cc179894f2f47d5c0ef 这是用于解决多线程并发下内存的回收,一块内存 ...
- oracle中的符号含义
1.Oracle数据库存储过程中:=是什么意思?答:赋值的意思.举例:str := 'abcd';将字符串abcd赋值给变量str. 2.oracle 存储过程中的 := 和=有什么区别?答::= 是 ...
- 出现ERROR: While executing gem ... (Gem::FilePermissionError)这种错误的解决办法
重新安装ruby即可解决 brew install ruby
- HBase原理解析(转)
本文属于转载,原文链接:http://www.aboutyun.com/thread-7199-1-1.html 前提是大家至少了解HBase的基本需求和组件. 从大家最熟悉的客户端发起请求开始讲 ...
- postman中 form-data、x-www-form-urlencoded、raw、binary的区别 && 下载文件
1.form-data: 就是http请求中的multipart/form-data,它会将表单的数据处理为一条消息,以标签为单元,用分隔符分开.既可以上传键值对,也可以上传文件.当上传的字段是文件 ...
- window7 开启自带 ftp
添加 ftp 用户 在windows里添加一个用户.这个其实是你ftp的用户.当然你可以使用匿名访问,但是这样不怎么安全,要知道ftp外网其实也是可以连进来的.去把密码设一下,标准用户就可以了,不用管 ...
- LightOJ 1370- Bi-shoe and Phi-shoe (欧拉函数)
题目大意:一个竹竿长度为p,它的score值就是比p长度小且与且与p互质的数字总数,比如9有1,2,4,5,7,8这六个数那它的score就是6.给你T组数据,每组n个学生,每个学生都有一个幸运数字, ...
- Codeforces 813B The Golden Age(数学+枚举)
题目大意:如果一个数t=x^a+y^b(a,b都是大于等于0的整数)那就是一个unlucky数字.给你x,y,l,r(2 ≤ x, y ≤ 10^18, 1 ≤ l ≤ r ≤ 10^18),求出l到 ...