
HBase学习之路 (二)HBase集群安装
前提
1、HBase 依赖于 HDFS 做底层的数据存储
2、HBase 依赖于 MapReduce 做数据计算
3、HBase 依赖于 ZooKeeper 做服务协调
4、HBase源码是java编写的,安装需要依赖JDK
版本选择
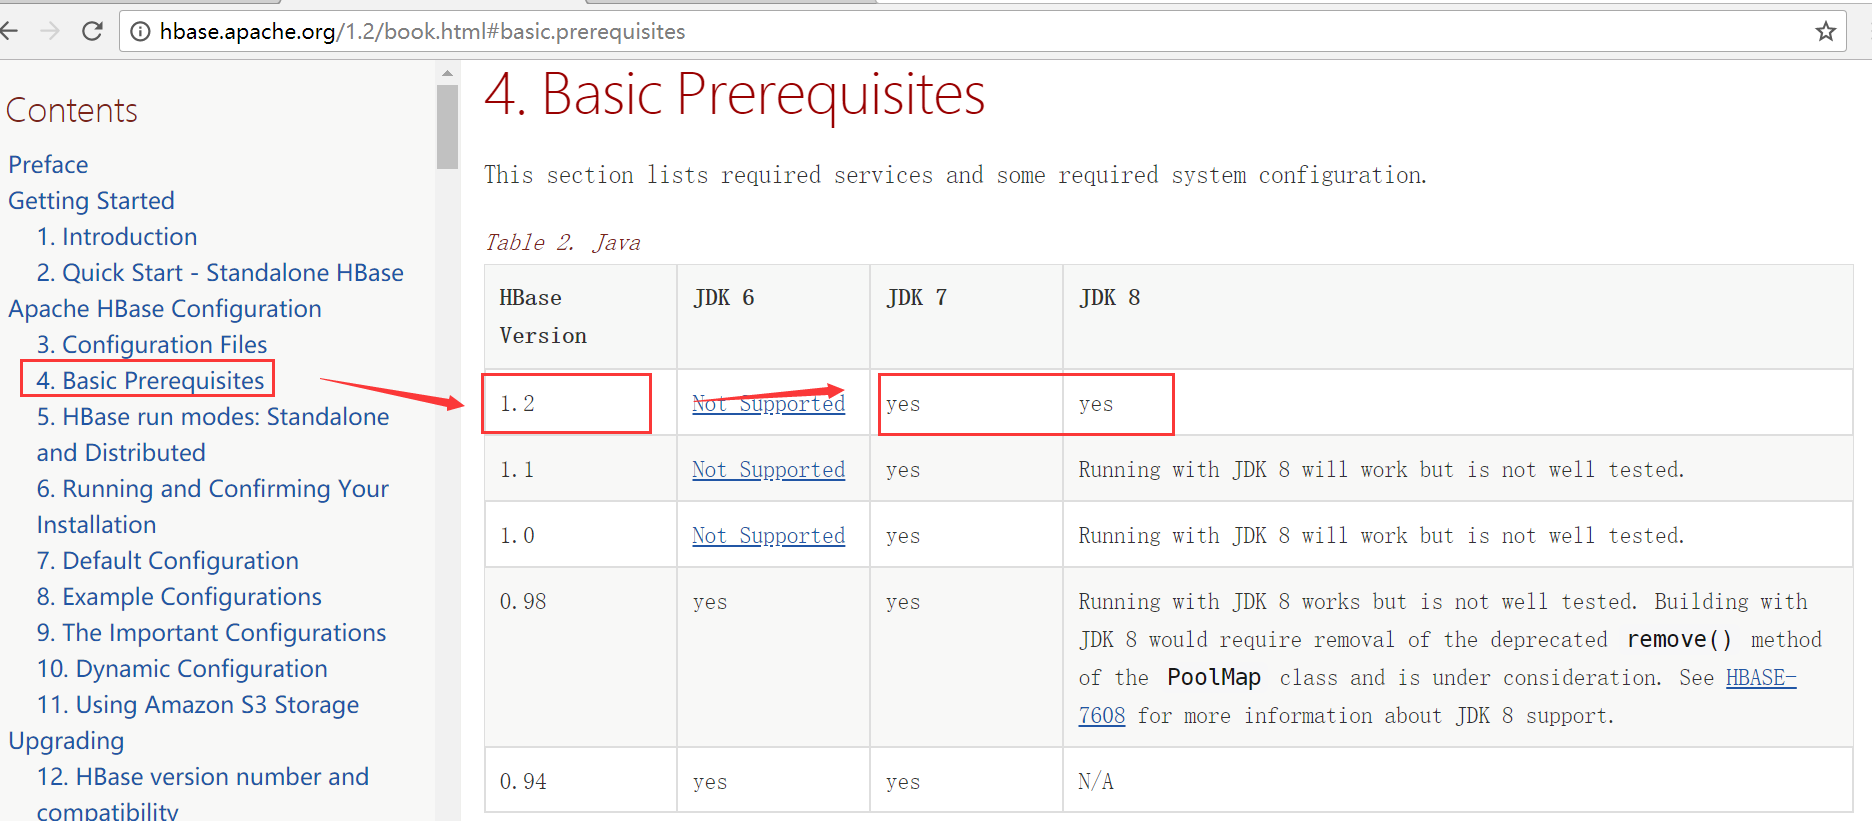
打开官方的版本说明http://hbase.apache.org/1.2/book.html
JDK的选择
Hadoop的选择
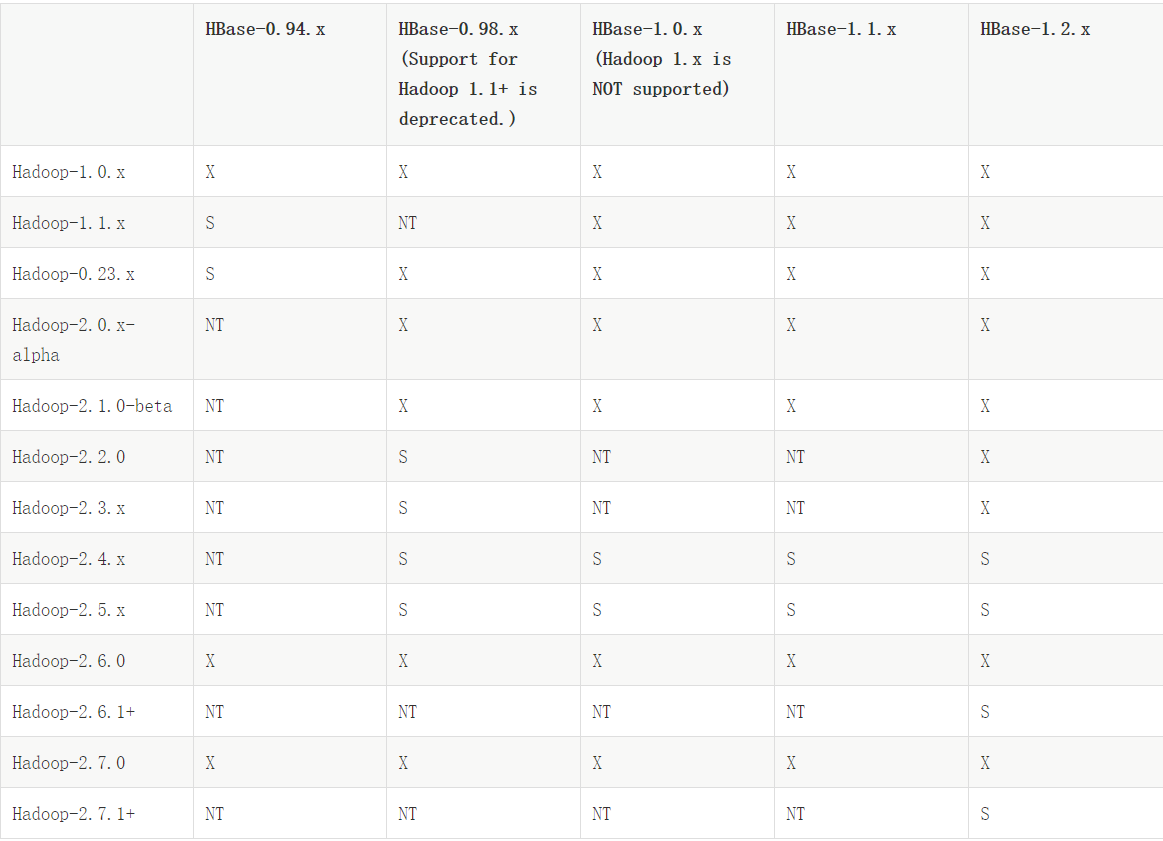
此处我们的hadoop版本用的的是2.7.5,HBase选择的版本是1.2.6
安装
1、zookeeper的安装
参考http://www.cnblogs.com/qingyunzong/p/8619184.html
2、Hadoopd的安装
参考http://www.cnblogs.com/qingyunzong/p/8634335.html
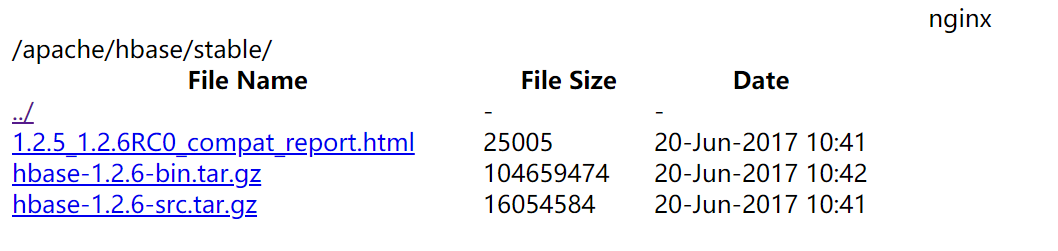
3、下载安装包
找到官网下载 hbase 安装包 hbase-1.2.6-bin.tar.gz,这里给大家提供一个下载地址: http://mirrors.hust.edu.cn/apache/hbase/
4、上传服务器并解压缩到指定目录
[hadoop@hadoop1 ~]$ ls

apps  data  hbase-1.2.-bin.tar.gz  hello.txt  log  zookeeper.out

[hadoop@hadoop1 ~]$ tar -zxvf hbase-1.2.6-bin.tar.gz -C apps/
5、修改配置文件
配置文件目录在安装包的conf文件夹中
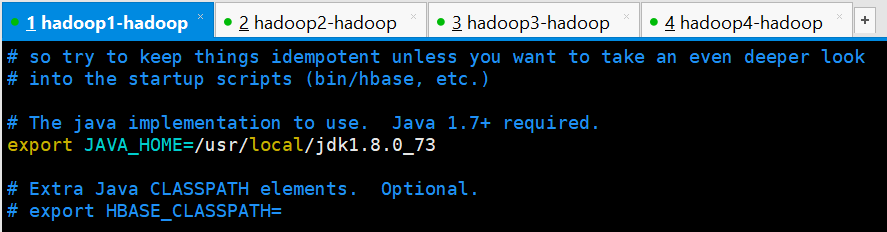
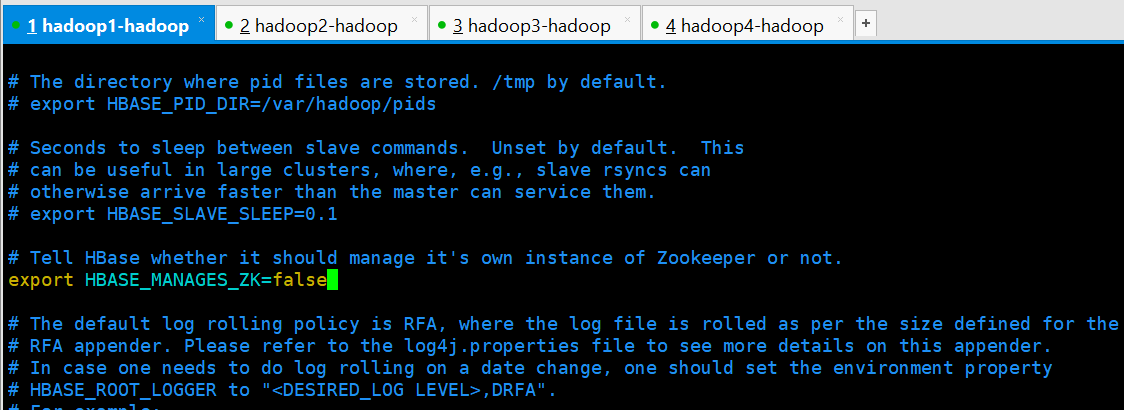
(1)修改hbase-env.sh
[hadoop@hadoop1 conf]$ vi hbase-env.sh
export JAVA_HOME=/usr/local/jdk1..0_73
export HBASE_MANAGES_ZK=false
(2)修改hbase-site.xml
[hadoop@hadoop1 conf]$ vi hbase-site.xml
<configuration>

        <property>

                <!-- 指定 hbase 在 HDFS 上存储的路径 -->

                <name>hbase.rootdir</name>

                <value>hdfs://myha01/hbase126</value>

        </property>

        <property>

                <!-- 指定 hbase 是分布式的 -->

                <name>hbase.cluster.distributed</name>

                <value>true</value>

        </property>

        <property>

                <!-- 指定 zk 的地址,多个用“,”分割 -->

                <name>hbase.zookeeper.quorum</name>

                <value>hadoop1:2181,hadoop2:2181,hadoop3:2181,hadoop4:2181</value>

        </property>

</configuration>
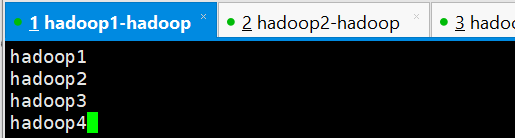
(3)修改regionservers
[hadoop@hadoop1 conf]$ vi regionservers
hadoop1

hadoop2

hadoop3

hadoop4
(4)修改backup-masters
该文件是不存在的,先自行创建
[hadoop@hadoop1 conf]$ vi backup-masters
hadoop4
(5)修改hdfs-site.xml 和 core-site.xml
最重要一步,要把 hadoop 的 hdfs-site.xml 和 core-site.xml 放到 hbase-1.2.6/conf 下
[hadoop@hadoop1 conf]$ cd ~/apps/hadoop-2.7.5/etc/hadoop/

[hadoop@hadoop1 hadoop]$ cp core-site.xml hdfs-site.xml ~/apps/hbase-1.2.6/conf/
6、将HBase安装包分发到其他节点
分发之前先删除HBase目录下的docs文件夹,
[hadoop@hadoop1 hbase-1.2.6]$ rm -rf docs/
在进行分发
[hadoop@hadoop1 apps]$ scp -r hbase-1.2.6/ hadoop2:$PWD

[hadoop@hadoop1 apps]$ scp -r hbase-1.2.6/ hadoop3:$PWD

[hadoop@hadoop1 apps]$ scp -r hbase-1.2.6/ hadoop4:$PWD
7、 同步时间
HBase 集群对于时间的同步要求的比 HDFS 严格,所以,集群启动之前千万记住要进行 时间同步,要求相差不要超过 30s
8、配置环境变量
所有服务器都有进行配置
[hadoop@hadoop1 apps]$ vi ~/.bashrc
#HBase

export HBASE_HOME=/home/hadoop/apps/hbase-1.2.6

export PATH=$PATH:$HBASE_HOME/bin
使环境变量立即生效
[hadoop@hadoop1 apps]$ source ~/.bashrc
启动HBase集群
严格按照启动顺序进行
1、启动zookeeper集群
每个zookeeper节点都要执行以下命令
[hadoop@hadoop1 apps]$ zkServer.sh start

ZooKeeper JMX enabled by default

Using config: /home/hadoop/apps/zookeeper-3.4.10/bin/../conf/zoo.cfg

Starting zookeeper ... STARTED

[hadoop@hadoop1 apps]$
2、启动HDFS集群及YARN集群
如果需要运行MapReduce程序则启动yarn集群,否则不需要启动
[hadoop@hadoop1 apps]$ start-dfs.sh

Starting namenodes on [hadoop1 hadoop2]

hadoop2: starting namenode, logging to /home/hadoop/apps/hadoop-2.7.5/logs/hadoop-hadoop-namenode-hadoop2.out

hadoop1: starting namenode, logging to /home/hadoop/apps/hadoop-2.7.5/logs/hadoop-hadoop-namenode-hadoop1.out

hadoop3: starting datanode, logging to /home/hadoop/apps/hadoop-2.7.5/logs/hadoop-hadoop-datanode-hadoop3.out

hadoop4: starting datanode, logging to /home/hadoop/apps/hadoop-2.7.5/logs/hadoop-hadoop-datanode-hadoop4.out

hadoop2: starting datanode, logging to /home/hadoop/apps/hadoop-2.7.5/logs/hadoop-hadoop-datanode-hadoop2.out

hadoop1: starting datanode, logging to /home/hadoop/apps/hadoop-2.7.5/logs/hadoop-hadoop-datanode-hadoop1.out

Starting journal nodes [hadoop1 hadoop2 hadoop3]

hadoop3: starting journalnode, logging to /home/hadoop/apps/hadoop-2.7.5/logs/hadoop-hadoop-journalnode-hadoop3.out

hadoop2: starting journalnode, logging to /home/hadoop/apps/hadoop-2.7.5/logs/hadoop-hadoop-journalnode-hadoop2.out

hadoop1: starting journalnode, logging to /home/hadoop/apps/hadoop-2.7.5/logs/hadoop-hadoop-journalnode-hadoop1.out

Starting ZK Failover Controllers on NN hosts [hadoop1 hadoop2]

hadoop2: starting zkfc, logging to /home/hadoop/apps/hadoop-2.7.5/logs/hadoop-hadoop-zkfc-hadoop2.out

hadoop1: starting zkfc, logging to /home/hadoop/apps/hadoop-2.7.5/logs/hadoop-hadoop-zkfc-hadoop1.out

[hadoop@hadoop1 apps]$
启动完成之后检查以下namenode的状态
[hadoop@hadoop1 apps]$ hdfs haadmin -getServiceState nn1

standby

[hadoop@hadoop1 apps]$ hdfs haadmin -getServiceState nn2

active

[hadoop@hadoop1 apps]$
3、启动HBase
保证 ZooKeeper 集群和 HDFS 集群启动正常的情况下启动 HBase 集群 启动命令:start-hbase.sh,在哪台节点上执行此命令,哪个节点就是主节点
[hadoop@hadoop1 conf]$ start-hbase.sh

starting master, logging to /home/hadoop/apps/hbase-1.2.6/logs/hbase-hadoop-master-hadoop1.out

Java HotSpot(TM) 64-Bit Server VM warning: ignoring option PermSize=128m; support was removed in 8.0

Java HotSpot(TM) 64-Bit Server VM warning: ignoring option MaxPermSize=128m; support was removed in 8.0

hadoop3: starting regionserver, logging to /home/hadoop/apps/hbase-1.2.6/logs/hbase-hadoop-regionserver-hadoop3.out

hadoop4: starting regionserver, logging to /home/hadoop/apps/hbase-1.2.6/logs/hbase-hadoop-regionserver-hadoop4.out

hadoop2: starting regionserver, logging to /home/hadoop/apps/hbase-1.2.6/logs/hbase-hadoop-regionserver-hadoop2.out

hadoop3: Java HotSpot(TM) 64-Bit Server VM warning: ignoring option PermSize=128m; support was removed in 8.0

hadoop3: Java HotSpot(TM) 64-Bit Server VM warning: ignoring option MaxPermSize=128m; support was removed in 8.0

hadoop4: Java HotSpot(TM) 64-Bit Server VM warning: ignoring option PermSize=128m; support was removed in 8.0

hadoop4: Java HotSpot(TM) 64-Bit Server VM warning: ignoring option MaxPermSize=128m; support was removed in 8.0

hadoop2: Java HotSpot(TM) 64-Bit Server VM warning: ignoring option PermSize=128m; support was removed in 8.0

hadoop2: Java HotSpot(TM) 64-Bit Server VM warning: ignoring option MaxPermSize=128m; support was removed in 8.0

hadoop1: starting regionserver, logging to /home/hadoop/apps/hbase-1.2.6/logs/hbase-hadoop-regionserver-hadoop1.out

hadoop4: starting master, logging to /home/hadoop/apps/hbase-1.2.6/logs/hbase-hadoop-master-hadoop4.out

[hadoop@hadoop1 conf]$
观看启动日志可以看到:
(1)首先在命令执行节点启动 master
(2)然后分别在 hadoop02,hadoop03,hadoop04,hadoop05 启动 regionserver
(3)然后在 backup-masters 文件中配置的备节点上再启动一个 master 主进程
验证启动是否正常
1、检查各进程是否启动正常
主节点和备用节点都启动 hmaster 进程
各从节点都启动 hregionserver 进程
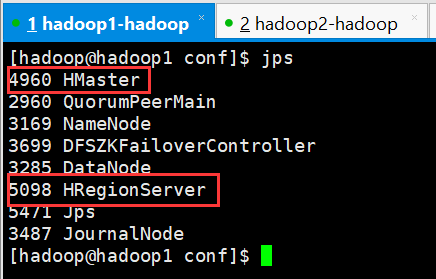
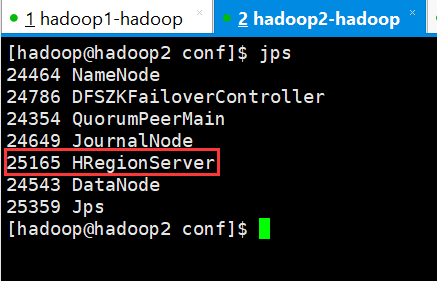
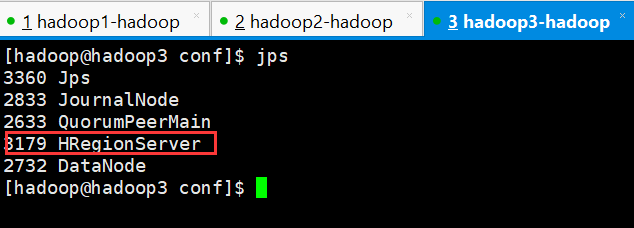
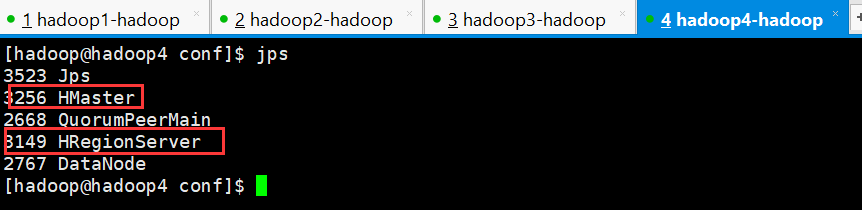
按照对应的配置信息各个节点应该要启动的进程如上图所示
2、通过访问浏览器页面
hadoop1
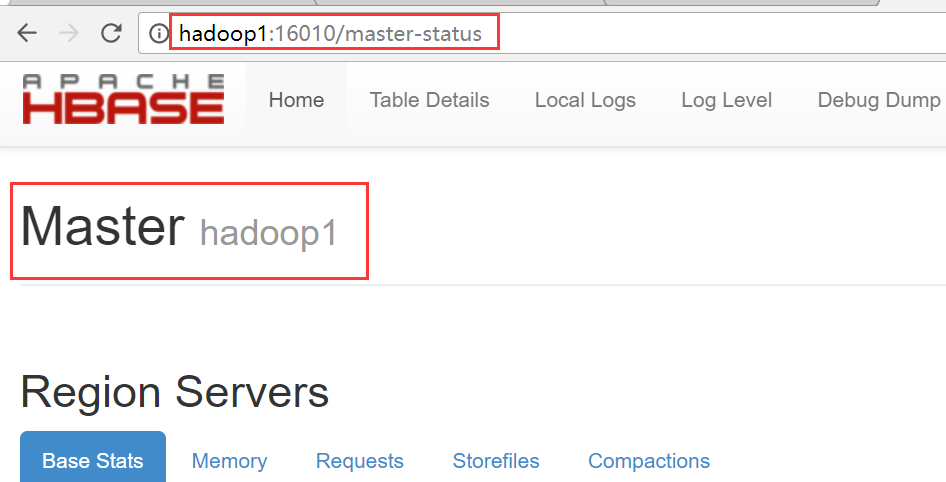
hadop4
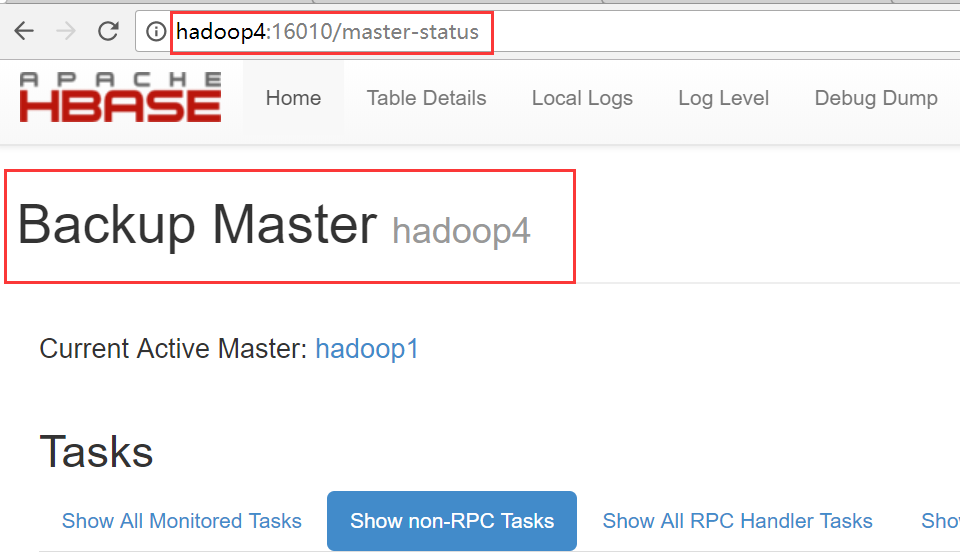
从图中可以看出hadoop4是备用节点
3、验证高可用
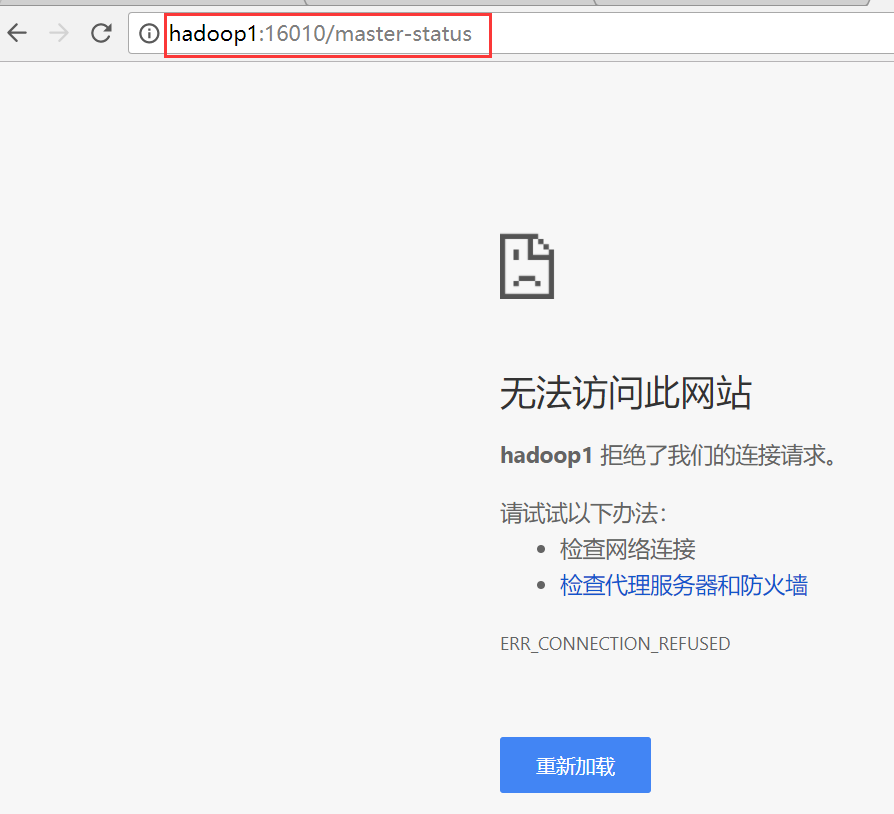
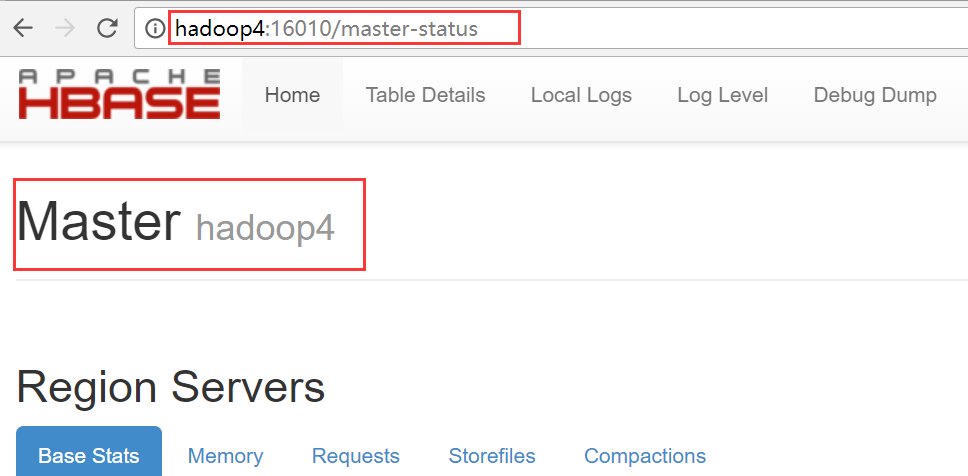
干掉hadoop1上的hbase进程,观察备用节点是否启用
[hadoop@hadoop1 conf]$ jps

4960 HMaster

2960 QuorumPeerMain

3169 NameNode

3699 DFSZKFailoverController

3285 DataNode

5098 HRegionServer

5471 Jps

3487 JournalNode

[hadoop@hadoop1 conf]$ kill -9 4960
hadoop1界面访问不了
hadoop4变成主节点
4、如果有节点相应的进程没有启动,那么可以手动启动
启动HMaster进程
[hadoop@hadoop3 conf]$ jps

3360 Jps

2833 JournalNode

2633 QuorumPeerMain

3179 HRegionServer

2732 DataNode

[hadoop@hadoop3 conf]$ hbase-daemon.sh start master

starting master, logging to /home/hadoop/apps/hbase-1.2.6/logs/hbase-hadoop-master-hadoop3.out

Java HotSpot(TM) 64-Bit Server VM warning: ignoring option PermSize=128m; support was removed in 8.0

Java HotSpot(TM) 64-Bit Server VM warning: ignoring option MaxPermSize=128m; support was removed in 8.0

[hadoop@hadoop3 conf]$ jps

2833 JournalNode

3510 Jps

3432 HMaster

2633 QuorumPeerMain

3179 HRegionServer

2732 DataNode

[hadoop@hadoop3 conf]$
启动HRegionServer进程
[hadoop@hadoop3 conf]$ hbase-daemon.sh start regionserver
HBase学习之路 (二)HBase集群安装的更多相关文章
- HBase 1.2.6 完全分布式集群安装部署详细过程
Apache HBase 是一个高可靠性.高性能.面向列.可伸缩的分布式存储系统,是NoSQL数据库,基于Google Bigtable思想的开源实现,可在廉价的PC Server上搭建大规模结构化存 ...
- hadoop学习之hadoop完全分布式集群安装
注:本文的主要目的是为了记录自己的学习过程,也方便与大家做交流.转载请注明来自: http://blog.csdn.net/ab198604/article/details/8250461 要想深入的 ...
- StreamSets学习系列之StreamSets的集群安装(图文详解)
不多说,直接上干货! 若是集群安装 需要在对应节点执行相同的操作. 见 StreamSets学习系列之StreamSets支持多种安装方式[Core Tarball.Cloudera Parcel . ...
- 一脸懵逼学习基于CentOs的Hadoop集群安装与配置
1:Hadoop分布式计算平台是由Apache软件基金会开发的一个开源分布式计算平台.以Hadoop分布式文件系统(HDFS)和MapReduce(Google MapReduce的开源实现)为核心的 ...
- 一脸懵逼学习基于CentOs的Hadoop集群安装与配置(三台机器跑集群)
1:Hadoop分布式计算平台是由Apache软件基金会开发的一个开源分布式计算平台.以Hadoop分布式文件系统(HDFS)和MapReduce(Google MapReduce的开源实现)为核心的 ...
- 大数据学习之hadoop伪分布式集群安装(一)公众号undefined110
hadoop的基本概念: Hadoop是一个由Apache基金会所开发的分布式系统基础架构. 用户可以在不了解分布式底层细节的情况下,开发分布式程序.充分利用集群的威力进行高速运算和存储. Hadoo ...
- ELK学习实验003:Elasticsearch 集群安装
前面已经介绍了Elasticsearch这个工具,并对单机安装做了简单介绍,现在使用三台机器做一个elasticsearch集群 一 环境准备 1.1 机器准备 1.2 同步时间 [root@node ...
- Oracle 10G RAC集群安装
一,基本环境配置 01,hosts cat /etc/hosts 127.0.0.1 localhost localhost.localdomain localhost4 localhost4.loc ...
- Zookeeper学习之路 (二)集群搭建
ZooKeeper 软件安装须知 鉴于 ZooKeeper 本身的特点,服务器集群的节点数推荐设置为奇数台.我这里我规划为三台, 为别为 hadoop1,hadoop2,hadoop3 ZooKeep ...
- HBase体系架构和集群安装
大家好,今天分享的是HBase体系架构和HBase集群安装.承接上两篇文章<HBase简介>和<HBase数据模型>,点击回顾这2篇文章,有助于更好地理解本文. 一.HBase ...
随机推荐
- [源码] 定义String s="abcd", 求长度
一般会答: s.length() 看源码是如何实现的: /** * Returns the length of this string. * The length is equal to the nu ...
- 为 HTTP/2 头压缩专门设计的 HPACK
HTTP/2 对消息头采用 HPACK 进行压缩传输,能够节省消息头占用的网络的流量.如何理解 HPACK 压缩呢? 如果我们约定将常用的请求头的参数用一些特殊的编号来表示,比如 GET ...
- HTTP协议之内容协商
一个URL常常需要代表若干不同的资源.例如那种需要以多种语言提供其内容的网站站点.如果某个站点有说法语的和说英语的两种用户,它可能想用这两种语言提供网站站点信息.理想情况下,服务器应当向英语用户发送英 ...
- Dubbo安装及其实战1
一.Dubbo安装 (1)安装zk和tomcat yum 安装tomcat 默认路径为 /usr/share/tomcat zookeeper 我这里采用的是使用zookeeper管理的.所以要安装z ...
- Eclipse环境开发Teamcenter RAC
外包发过来的RAC程序老是报错,导致测试走不下去.Bug修复响应太慢,用jad看了下代码也不是很复杂,决定自己调试.在Eclipse 环境下开发Teamcenter RAC一般是用Eclipse,在做 ...
- CSS 样式初始化
去除浏览器对html的附加样式,避免不同浏览器之间的样式差异,给前端开发提供统一的样式基础.附加样式: .clearfix - 清除浮动 .wordsBreak - 允许文本在任意位置的换行 .ell ...
- oracle 用户系统权限
conn sys as sysdba; create user test identified by test; grant create session to test; grant create ...
- 如何进行 Python性能分析,你才能如鱼得水?
[编者按]本文作者为 Bryan Helmig,主要介绍 Python 应用性能分析的三种进阶方案.文章系国内 ITOM 管理平台 OneAPM 编译呈现. 我们应该忽略一些微小的效率提升,几乎在 9 ...
- ansible 一键部署
start install: rpm -Uvh https://mirrors.aliyun.com/epel/epel-release-latest-7.noarch.rpm yum in ...
- Jboss Jmx-Console和 Jboss web-console安全设置
1.介绍 如果你暴露你的JBoss服务器通过网络(如通过启动服务器使用选项B 0.0.0.0或者通过改变jboss.bind.address首次出现0.0.0.0在.../jboss/server/d ...