
elasticsearch之python备份
一:elasticsearch原理
Elasticsearch是一个基于Apache Lucene(TM)的开源搜索引擎。无论在开源还是专有领域,Lucene可以被认为是迄今为止最先进、性能最好的、功能最全的搜索引擎库。
但是,Lucene只是一个库。想要使用它,你必须使用Java来作为开发语言并将其直接集成到你的应用中,更糟糕的是,Lucene非常复杂,你需要深入了解检索的相关知识来理解它是如何工作的。
Elasticsearch也使用Java开发并使用Lucene作为其核心来实现所有索引和搜索的功能,但是它的目的是通过简单的RESTful API来隐藏Lucene的复杂性,从而让全文搜索变得简单。
不过,Elasticsearch不仅仅是Lucene和全文搜索,我们还能这样去描述它:
- 分布式的实时文件存储,每个字段都被索引并可被搜索
- 分布式的实时分析搜索引擎
- 可以扩展到上百台服务器,处理PB级结构化或非结构化数据
而且,所有的这些功能被集成到一个服务里面,你的应用可以通过简单的RESTful API、各种语言的客户端甚至命令行与之交互。
二:概念
索引(Index)
ES将数据存储于一个或多个索引中,索引是具有类似特性的文档的集合。类比传统的关系型数据库领域来说,索引相当于SQL中的一个数据库,或者一个数据存储方案(schema)。
索引由其名称(必须为全小写字符)进行标识,并通过引用此名称完成文档的创建、搜索、更新及删除操作。一个ES集群中可以按需创建任意数目的索引。
类型(Type)
类型是索引内部的逻辑分区(category/partition),然而其意义完全取决于用户需求。因此,一个索引内部可定义一个或多个类型(type)。一般来说,类型就是为那些拥有相同的域的文档做的预定义。
例如,在索引中,可以定义一个用于存储用户数据的类型,一个存储日志数据的类型,以及一个存储评论数据的类型。类比传统的关系型数据库领域来说,类型相当于“表”。
文档(Document)
文档是Lucene索引和搜索的原子单位,它是包含了一个或多个域的容器,基于JSON格式进行表示。
文档由一个或多个域组成,每个域拥有一个名字及一个或多个值,有多个值的域通常称为“多值域”。每个文档可以存储不同的域集,但同一类型下的文档至应该有某种程度上的相似之处。
映射(Mapping)
ES中,所有的文档在存储之前都要首先进行分析。用户可根据需要定义如何将文本分割成token、哪些token应该被过滤掉,以及哪些文本需要进行额外处理等等。
另外,ES还提供了额外功能,例如将域中的内容按需排序。事实上,ES也能自动根据其值确定域的类型。
接下去再说说ES Cluster相关的一些概念。
集群(Cluster)
ES集群是一个或多个节点的集合,它们共同存储了整个数据集,并提供了联合索引以及可跨所有节点的搜索能力。
多节点组成的集群拥有冗余能力,它可以在一个或几个节点出现故障时保证服务的整体可用性。
集群靠其独有的名称进行标识,默认名称为“elasticsearch”。节点靠其集群名称来决定加入哪个ES集群,一个节点只能属一个集群。
如果不考虑冗余能力等特性,仅有一个节点的ES集群一样可以实现所有的存储及搜索功能。
节点(Node)
运行了单个实例的ES主机称为节点,它是集群的一个成员,可以存储数据、参与集群索引及搜索操作。
类似于集群,节点靠其名称进行标识,默认为启动时自动生成的随机Marvel字符名称。
用户可以按需要自定义任何希望使用的名称,但出于管理的目的,此名称应该尽可能有较好的识别性。
节点通过为其配置的ES集群名称确定其所要加入的集群。
分片(Shard)和副本(Replica)
ES的“分片(shard)”机制可将一个索引内部的数据分布地存储于多个节点,它通过将一个索引切分为多个底层物理的Lucene索引完成索引数据的分割存储功能,这每一个物理的Lucene索引称为一个分片(shard)。
每个分片其内部都是一个全功能且独立的索引,因此可由集群中的任何主机存储。创建索引时,用户可指定其分片的数量,默认数量为5个。
Shard有两种类型:primary和replica,即主shard及副本shard。
Primary shard用于文档存储,每个新的索引会自动创建5个Primary shard,当然此数量可在索引创建之前通过配置自行定义,不过,一旦创建完成,其Primary shard的数量将不可更改。
Replica shard是Primary Shard的副本,用于冗余数据及提高搜索性能。
每个Primary shard默认配置了一个Replica shard,但也可以配置多个,且其数量可动态更改。ES会根据需要自动增加或减少这些Replica shard的数量。
ES集群可由多个节点组成,各Shard分布式地存储于这些节点上。
ES可自动在节点间按需要移动shard,例如增加节点或节点故障时。简而言之,分片实现了集群的分布式存储,而副本实现了其分布式处理及冗余功能。
下面说说ES系统及插件。
ES依赖于JDK,使用Oracke JDK或OpenJDK均可。
JDK在不同平台的安装方式各异,具体方法这里不再介绍。ES的安装也非常容易,通常只需要简单修改其配置文件中的集群名称,并启动服务即可,这里不再赘述。
ElasticSearch在设计上支持插件式体系结构,用户可根据需要通过插件来增强ElasticSearch的功能。
目前,常用的通过插件扩展的功能包括添加自定义映射类型、自定义分析器、本地脚本、自定义发现方式等等。
安装及移除插件
插件的安装有两种方式:直接将插件放置于plugins目录中,或通过plugin脚本进行安装。
Marvel、BigDesk及Head这三个是较为常用的插件。
ElasticSearch提供了易用但功能强大的RESTful API以用于与集群进行交互,这些API大体可分为如下四类:
(1) 检查集群、节点、索引等健康与否,以及获取其相关状态与统计信息;
(2) 管理集群、节点、索引数据及元数据;
(3) 执行CRUD操作及搜索操作;
(4) 执行高级搜索操作,例如paging、filtering、scripting、faceting、aggregations及其它操作;
下面简单说一说ES中的数据查询。
Query API是ElasticSearch的API中较大的一部分,基于Query DSL(JSON based language for building complex queries),可完成诸多类型查询操作,例如simple term query, phrase, range, boolean, fuzzy, span, wildcard, spatial等简单类型查询、组合简单查询类型为复杂类型查询,以及文档过滤等。
另外,查询执行过程通常要分成两个阶段,分散阶段及合并阶段。
分散阶段是向所查询的索引中的所有shard发起执行查询的过程,合并阶段是将各shard返回的结果合并、排序并响应给客户端的过程。
向ElasticSearch发起查询操作有两种方式:一是通过RESTful request API传递查询参数,也称“query-string”;另一个是通过发送REST request body,也称作JSON格式。
了解原理之后,so ....备份开始
迁移注意事项
- 保证ES集群不再接受新的数据(如果是备份的话,这一点可以不考虑,但是做数据迁移的话,建议这样做).
- 不建议直接在生产环境做这些操作,最好是先在本地搭建一个和生产环境一样的集群环境,创建一些测试数据,把整个过程先跑一遍,然后再到生产环境操作。
注册快照仓库
ES是通过快照的方式来实现数据备份,并且是以增量的方式,所以一般第一次做的话会花费较长的时间。为了做快照,那么就需要注册一个快照仓库,告诉ES我们的快照应该如何保存以及将快照保存到哪里.
curl -XPUT 192.168.1.2:9200/_snapshot/backup -d '

> {

> "type":"fs",

> "settings":{"location":"/data/elasticsearch_backup/data"}

> }'

{"acknowledged":true}
注:/data/elasticsearch_backup/data需有写入权限,并需挂着到节点服务器中,并需创建/data/elasticsearch_data/zip目录,存放备份压缩
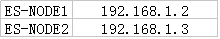
例如:192.168.1.2安装nfs并挂载(步骤略)
192.168.1.3node2执行挂载目录mount 192.168.1.2:/data/elasticsearch_backup/data /data/elasticsearch_backup/data
开始备份
 #!/usr/bin/python

 # -*- coding:UTF-8 -*- #

 #_author_: patrick

 """

 自动备份ElaticSearch

 """

 import sys,requests

 import simplejson

 import time,os

 import zipfile

 URL="http://192.168.1.2:9200/_snapshot/backup?$filename?pretty"

 BAK_DIR="/data/elasticsearch_backup/data"

 ZIP_DIR="/data/elasticsearch_backup/zip"

 if __name__=='__main__':

     date=time.strftime('%Y.%m.%d',time.localtime(time.time()-86400))

     index='logstash-sec-'+date

     url=URL+'/'+index+'?wait_for_completion=true'

     #开始备份指定INDEX

     r2=requests.post(url)

     print "----------->",r2.text

     #查询备份状态

     r3=requests.get(url)

     dic=simplejson.loads(r3.text)

     print dic

     while  (dic['snapshots'][0]['state']=='IN_PROGRESS'):

         print "%s Backup is IN_PROGRESS..." % index

         time.sleep(10)

         r3=requests.get(url)

         dic=simplejson.loads(r3.text)

     if dic['snapshots'][0]['state']=='SUCCESS':

         print '%s 备份成功' % index

         try:

             #压缩文件

             zfile=ZIP_DIR+'/'+index+'.zip'

             z = zipfile.ZipFile(zfile,'w',zipfile.ZIP_DEFLATED,allowZip64=True)

             print "开始压缩文件..."

             for dirpath, dirnames, filenames in os.walk(BAK_DIR):

                 for filename in filenames:

                     z.write(os.path.join(dirpath,filename))

             z.close()

             #os.system('rm -rf '+BAK_DIR) #删除原文件目录

             print "备份结束"

         except Exception,e:

             print e

         print "开始删除index: %s" % index

         os.system('curl -XDELETE "http://192.168.31.8:9200/_snapshot/backup/%s"' % index)

     else:

         print '%s 备份失败' % index
python备份ES
恢复备份
curl -XPOST http://192.168.1.2:9200/_snapshot/backup/logstash-sec-2016.10.22/_restore
elasticsearch之python备份的更多相关文章
- 将Elasticsearch的快照备份到HDFS
1.安装Elasticsearch插件repository-hdfs 下载地址:https://artifacts.elastic.co/downloads/elasticsearch-plugins ...
- Elasticsearch for python API模块化封装
Elasticsearch for python API模块化封装 模块的具体功能 检测Elasticsearch节点是否畅通 查询Elasticsearch节点健康状态 查询包含的关键字的日志(展示 ...
- Elasticsearch系列---生产数据备份恢复方案
前言 生产环境中运行的组件,只要有数据存储,定时备份.灾难恢复是必修课,mysql数据库的备份方案已经非常成熟,Elasticsearch也同样有成熟的数据备份.恢复方案,我们来了解一下. 概要 本篇 ...
- Elasticsearch的快照备份
该文档适用于备份使用NAS的仓库类型.所有Elasticsearch集群中的服务通过挂载NAS目录来存放备份快照数据. 1.创建备份仓库 创建一个仓库名称:backup curl -H "C ...
- elasticsearch,python包pyes进行的处理
elasticsearch:高性能搜索引擎,官网:https://www.elastic.co/products/elasticsearch/ 对于它相信大家都不陌生,es的使用已经广泛存在 各大网站 ...
- python 备份压缩传输
# -*- coding:utf-8 -*-__author__ = 'colin' #!/usr/bin/env python#-*- coding:utf-8 -*-import os,comma ...
- Python备份MySQL数据库【转】
#!/usr/bin/env python # coding: utf- import os import time ''' defined variable ''' databases=['hch' ...
- elasticsearch的python增删查改实例分析
Reference: http://bigg.top/2015/11/29/elasticsearch%E7%9A%84python%E5%A2%9E%E5%88%A0%E6%9F%A5%E6%94 ...
- elasticsearch snapshot快照备份和恢复
环境:mac 使用brew 安装elasticsearch 1.在 /usr/local/etc/elasticsearch/elasticsearch.yml 文件中配置快照地址 p ...
随机推荐
- 【7集iCore3基础视频】7-2 iCore3原理图介绍
iCore3原理图介绍: 高清源视频:http://pan.baidu.com/s/1hsPkifM 密码:ei8ciCore3 购买链接:https://item.taobao.com/item.h ...
- Tomcat负载均衡配置-未完成
集群技术是目前非常流行的提高系统服务能力与高可靠性( HA- High Availability )的手段,通过把多个独立的服务器组成一个集群可以实现失效无缝转移.也就是说当有某一台集群中的服务器当机 ...
- 使用 Grafana、collectd 和 InfluxDB 打造现代监控系统
想打造 New Relic 那样漂亮的实时监控系统我们只需要 InfluxDB/collectd/Grafana 这三个工具,这三个工具的关系是这样的: 采集数据(collectd)-> 存储数 ...
- Java 隐藏和覆盖
我们知道,在JAVA中,子类可以继承父类,如果子类声明的方法与父类有重名的情况怎么办,大伙儿都知道要是重写,但是实际上这又分为两种情况,就是方法和变量在继承时的覆盖和隐藏问题,这些概念性的东西看似无聊 ...
- mysql笔记(存储引擎)
读写锁:. 表级锁:开销小,加锁快:不会出现死锁:锁定粒度大,发生锁冲突的概率最高,并发度最低. 行级锁:开销大,加锁慢:会出现死锁:锁定粒度最小,发生锁冲突的概率最低,并发度也最高. 页面锁:开销和 ...
- App 打包并跳过 AppStore 的发布下载
一.App 打包 (编译 -> 链接 -> 打包) 1) 下载发布版的证书并安装. 2)Target -> Build Setting,改为发布版本的 profile 3) Targ ...
- redis 自启动
第一步: 在/etc/init.d/目录下建立一个名字为 redis 的启动脚本 cd /etc/init.d touch redis 然后在这个脚本中添加如下脚本 <注意修改自己的PIDFI ...
- ASP.NET 大文件上传
一 web.config 配置: 1). <system.webServer> <security> <requestFiltering> <!-- maxA ...
- openfire二次开发eclipse环境搭建
转自:http://blog.csdn.net/daigua245/article/details/7918243 1.将openfire源码项目解压到(如果是从SVN CO下来的则不用)eclips ...
- LeetCode 3Sum Smaller
原题链接在这里:https://leetcode.com/problems/3sum-smaller/ 题目: Given an array of n integers nums and a targ ...