
Hadoop MapReduce编程 API入门系列之挖掘气象数据版本3(九)
不多说,直接上干货!
下面,是版本1。
Hadoop MapReduce编程 API入门系列之挖掘气象数据版本1(一)
下面是版本2。
Hadoop MapReduce编程 API入门系列之挖掘气象数据版本2(九)
这篇博客,给大家,体会不一样的版本编程。

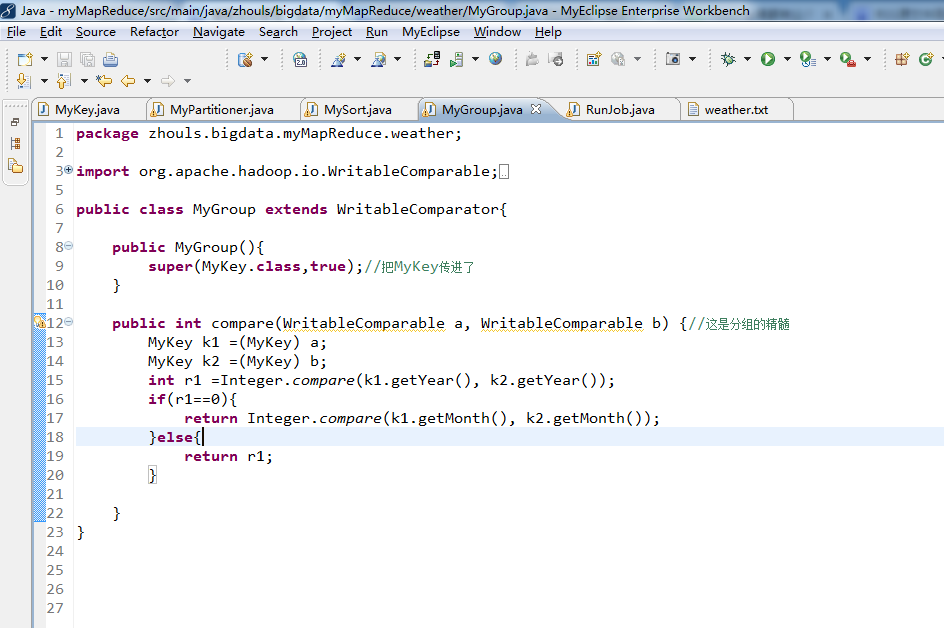
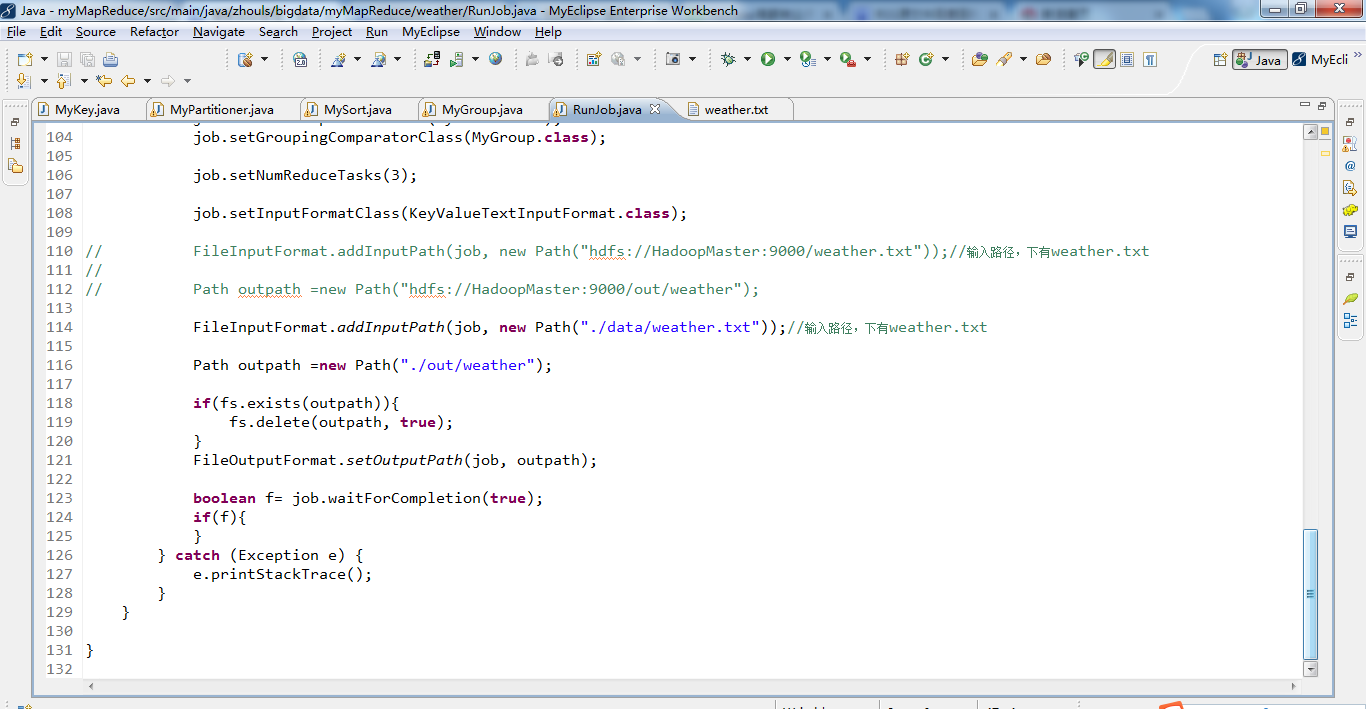
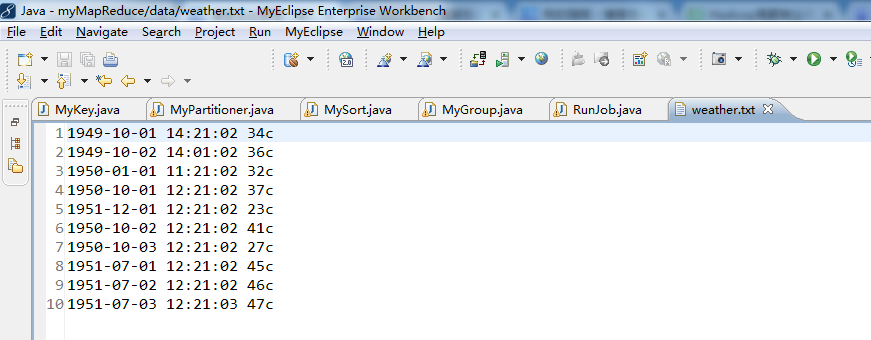
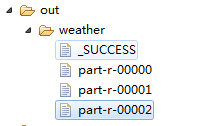
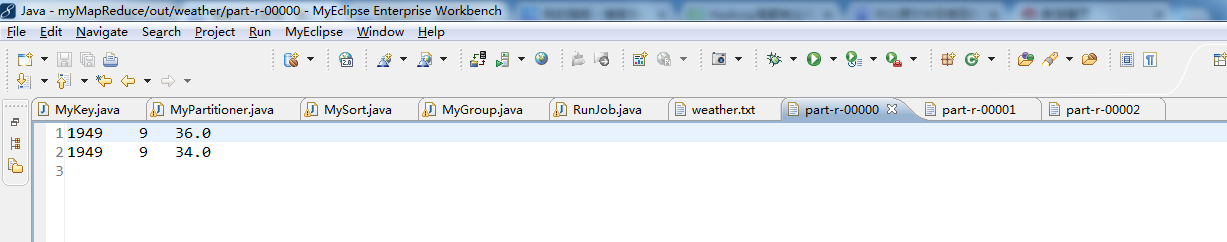
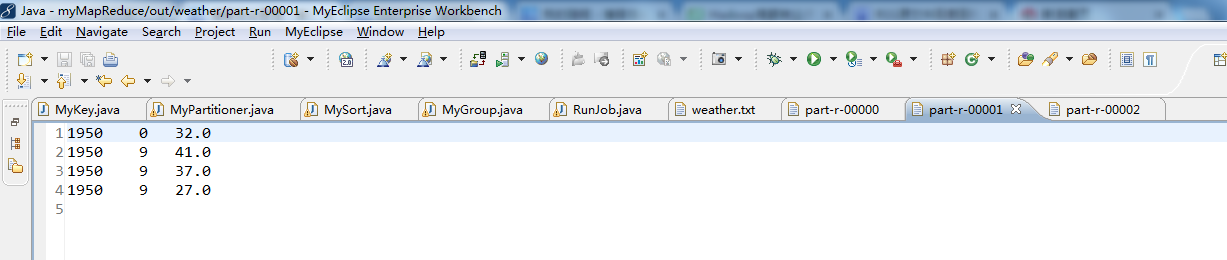
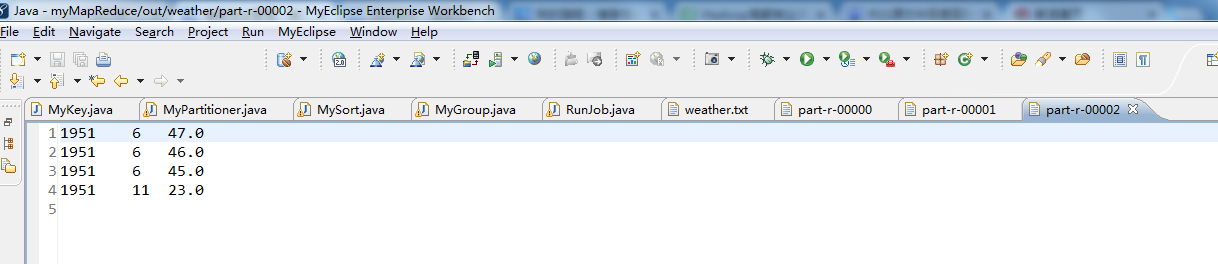
代码
package zhouls.bigdata.myMapReduce.weather;

import java.io.DataInput;

import java.io.DataOutput;

import java.io.IOException;

import org.apache.hadoop.io.WritableComparable;

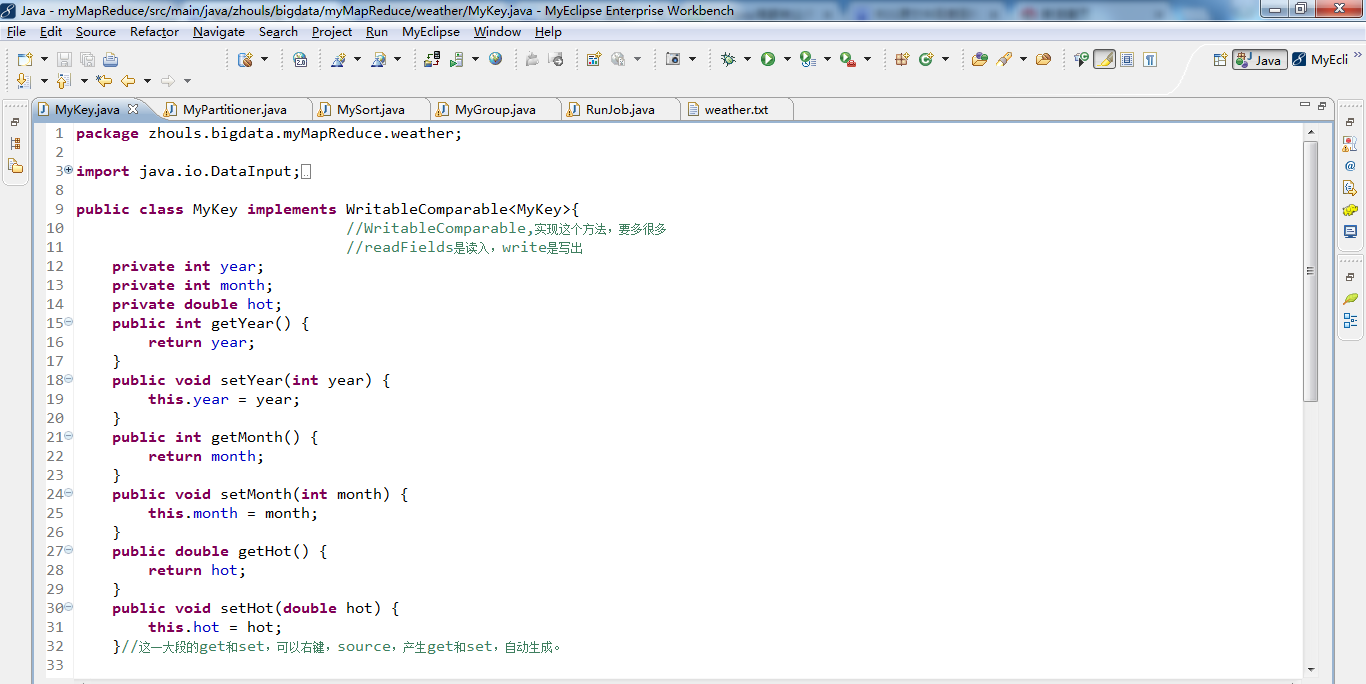
public class MyKey implements WritableComparable<MyKey>{

    //WritableComparable,实现这个方法,要多很多

    //readFields是读入,write是写出

    private int year;

    private int month;

    private double hot;

    public int getYear() {

    return year;

}

    public void setYear(int year) {

        this.year = year;

    }

    public int getMonth() {

        return month;

    }

    public void setMonth(int month) {

        this.month = month;

    }

    public double getHot() {

        return hot;

    }

    public void setHot(double hot) {

        this.hot = hot;

        }//这一大段的get和set,可以右键,source,产生get和set,自动生成。

    public void readFields(DataInput arg0) throws IOException { //反序列化

        this.year=arg0.readInt();

        this.month=arg0.readInt();

        this.hot=arg0.readDouble();

    }

    public void write(DataOutput arg0) throws IOException { //序列化

        arg0.writeInt(year);

        arg0.writeInt(month);

        arg0.writeDouble(hot);

    }

    //判断对象是否是同一个对象,当该对象作为输出的key

    public int compareTo(MyKey o) {

        int r1 =Integer.compare(this.year, o.getYear());//比较当前的年和你传过来的年

        if(r1==){

        int r2 =Integer.compare(this.month, o.getMonth());

        if(r2==){

            return Double.compare(this.hot, o.getHot());

        }else{

            return r2;

        }

        }else{

            return r1;

        }

    }

}
package zhouls.bigdata.myMapReduce.weather;

import org.apache.hadoop.io.DoubleWritable;

import org.apache.hadoop.io.NullWritable;

import org.apache.hadoop.mapreduce.lib.partition.HashPartitioner;

public class MyPartitioner extends HashPartitioner<MyKey, DoubleWritable>{//这里就是洗牌

    //执行时间越短越好

    public int getPartition(MyKey key, DoubleWritable value, int numReduceTasks) {

        return (key.getYear()-)%numReduceTasks;//对于一个数据集,找到最小,1949

    }

}

//1949-10-01 14:21:02    34c

//1949-10-02 14:01:02    36c

//1950-01-01 11:21:02    32c

//1950-10-01 12:21:02    37c

//1951-12-01 12:21:02    23c

//1950-10-02 12:21:02    41c

//1950-10-03 12:21:02    27c

//1951-07-01 12:21:02    45c

//1951-07-02 12:21:02    46c

//1951-07-03 12:21:03    47c
package zhouls.bigdata.myMapReduce.weather;

import org.apache.hadoop.io.WritableComparable;

import org.apache.hadoop.io.WritableComparator;

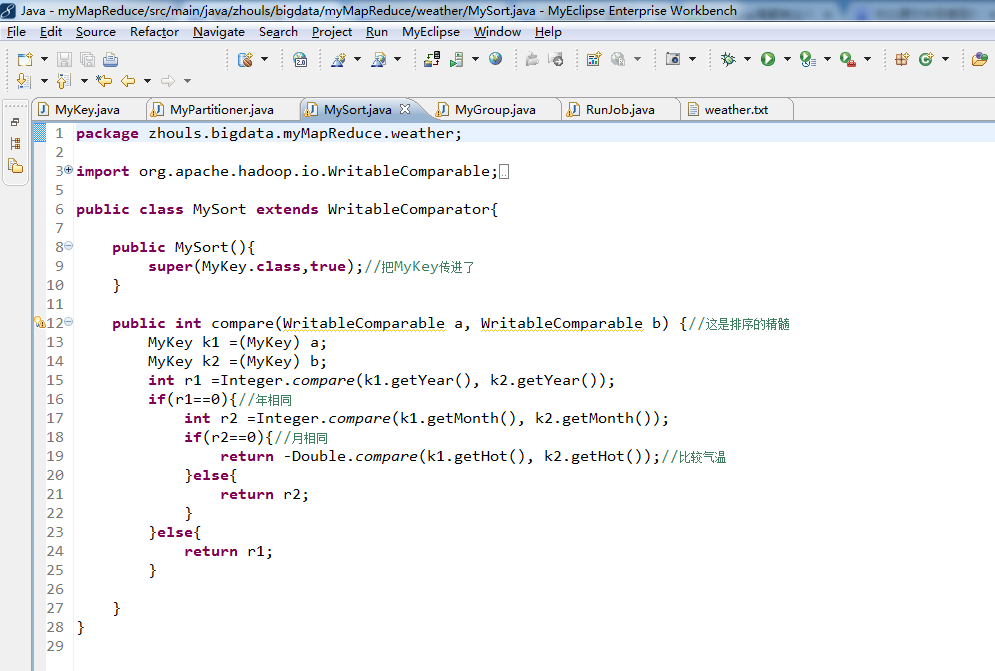
public class MySort extends WritableComparator{

    public MySort(){

        super(MyKey.class,true);//把MyKey传进了

    }

    public int compare(WritableComparable a, WritableComparable b) {//这是排序的精髓

        MyKey k1 =(MyKey) a;

        MyKey k2 =(MyKey) b;

        int r1 =Integer.compare(k1.getYear(), k2.getYear());

        if(r1==){//年相同

        int r2 =Integer.compare(k1.getMonth(), k2.getMonth());

        if(r2==){//月相同

            return -Double.compare(k1.getHot(), k2.getHot());//比较气温

        }else{

            return r2;

        }

        }else{

            return r1;

        }

    }

}
package zhouls.bigdata.myMapReduce.weather;

import org.apache.hadoop.io.WritableComparable;

import org.apache.hadoop.io.WritableComparator;

public class MyGroup extends WritableComparator{

    public MyGroup(){

        super(MyKey.class,true);//把MyKey传进了

}

    public int compare(WritableComparable a, WritableComparable b) {//这是分组的精髓

        MyKey k1 =(MyKey) a;

        MyKey k2 =(MyKey) b;

        int r1 =Integer.compare(k1.getYear(), k2.getYear());

    if(r1==){

        return Integer.compare(k1.getMonth(), k2.getMonth());

    }else{

        return r1;

    }

    }

}
package zhouls.bigdata.myMapReduce.weather;

import java.io.IOException;

import java.text.ParseException;

import java.text.SimpleDateFormat;

import java.util.Calendar;

import java.util.Date;

import org.apache.hadoop.conf.Configuration;

import org.apache.hadoop.fs.FileSystem;

import org.apache.hadoop.fs.Path;

import org.apache.hadoop.io.DoubleWritable;

import org.apache.hadoop.io.NullWritable;

import org.apache.hadoop.io.Text;

import org.apache.hadoop.mapreduce.Job;

import org.apache.hadoop.mapreduce.Mapper;

import org.apache.hadoop.mapreduce.Reducer;

import org.apache.hadoop.mapreduce.lib.input.FileInputFormat;

import org.apache.hadoop.mapreduce.lib.input.KeyValueTextInputFormat;

import org.apache.hadoop.mapreduce.lib.output.FileOutputFormat;

public class RunJob {

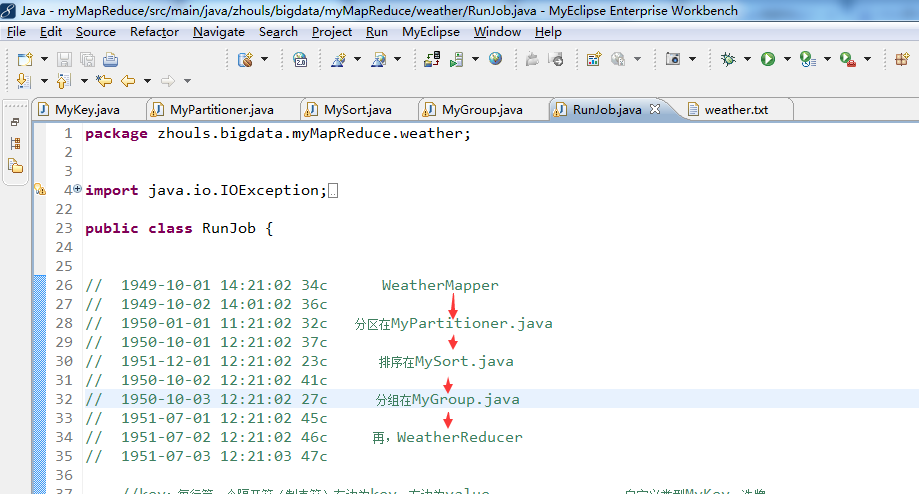
//    1949-10-01 14:21:02    34c WeatherMapper

//    1949-10-02 14:01:02    36c

//    1950-01-01 11:21:02    32c    分区在MyPartitioner.java

//    1950-10-01 12:21:02    37c

//    1951-12-01 12:21:02    23c    排序在MySort.java

//    1950-10-02 12:21:02    41c

//    1950-10-03 12:21:02    27c    分组在MyGroup.java

//    1951-07-01 12:21:02    45c

//    1951-07-02 12:21:02    46c    再,WeatherReducer

//    1951-07-03 12:21:03    47c

//key:每行第一个隔开符(制表符)左边为key,右边为value    自定义类型MyKey,洗牌,

    static class WeatherMapper extends Mapper<Text, Text, MyKey, DoubleWritable>{

    SimpleDateFormat sdf =new SimpleDateFormat("yyyy-MM-dd HH:mm:ss");

    NullWritable v =NullWritable.get();

//    1949-10-01 14:21:02是自定义类型MyKey,即key

//    34c是DoubleWritable,即value

    protected void map(Text key, Text value,Context context) throws IOException, InterruptedException {

    try {

        Date date =sdf.parse(key.toString());

        Calendar c =Calendar.getInstance();

        //Calendar 类是一个抽象类,可以通过调用 getInstance() 静态方法获取一个 Calendar 对象,

        //此对象已由当前日期时间初始化,即默认代表当前时间,如 Calendar c = Calendar.getInstance();

        c.setTime(date);

        int year =c.get(Calendar.YEAR);

        int month =c.get(Calendar.MONTH);

        double hot =Double.parseDouble(value.toString().substring(, value.toString().lastIndexOf("c")));

        MyKey k =new MyKey();

        k.setYear(year);

        k.setMonth(month);

        k.setHot(hot);

        context.write(k, new DoubleWritable(hot));

    } catch (Exception e) {

        e.printStackTrace();

    }

    }

}

    static class WeatherReducer extends Reducer<MyKey, DoubleWritable, Text, NullWritable>{

    protected void reduce(MyKey arg0, Iterable<DoubleWritable> arg1,Context arg2)throws IOException, InterruptedException {

        int i=;

        for(DoubleWritable v :arg1){

        i++;

        String msg =arg0.getYear()+"\t"+arg0.getMonth()+"\t"+v.get();//"\t"是制表符

        arg2.write(new Text(msg), NullWritable.get());

                if(i==){

                    break;

                }

        }

    }

}

public static void main(String[] args) {

    Configuration config =new Configuration();

//    config.set("fs.defaultFS", "hdfs://HadoopMaster:9000");

//    config.set("yarn.resourcemanager.hostname", "HadoopMaster");

//    config.set("mapred.jar", "C:\\Users\\Administrator\\Desktop\\wc.jar");

//    config.set("mapreduce.input.keyvaluelinerecordreader.key.value.separator", ",");//默认分隔符是制表符"\t",这里自定义,如","

    try {

        FileSystem fs =FileSystem.get(config);

        Job job =Job.getInstance(config);

        job.setJarByClass(RunJob.class);

        job.setJobName("weather");

        job.setMapperClass(WeatherMapper.class);

        job.setReducerClass(WeatherReducer.class);

        job.setMapOutputKeyClass(MyKey.class);

        job.setMapOutputValueClass(DoubleWritable.class);

        job.setPartitionerClass(MyPartitioner.class);

        job.setSortComparatorClass(MySort.class);

        job.setGroupingComparatorClass(MyGroup.class);

        job.setNumReduceTasks();

        job.setInputFormatClass(KeyValueTextInputFormat.class);

//    FileInputFormat.addInputPath(job, new Path("hdfs://HadoopMaster:9000/weather.txt"));//输入路径,下有weather.txt

//

//    Path outpath =new Path("hdfs://HadoopMaster:9000/out/weather");

        FileInputFormat.addInputPath(job, new Path("./data/weather.txt"));//输入路径,下有weather.txt

    Path outpath =new Path("./out/weather");

    if(fs.exists(outpath)){

        fs.delete(outpath, true);

    }

    FileOutputFormat.setOutputPath(job, outpath);

        boolean f= job.waitForCompletion(true);

        if(f){

        }

    } catch (Exception e) {

        e.printStackTrace();

    }

    }

}
同时,大家可以关注我的个人博客:
http://www.cnblogs.com/zlslch/ 和 http://www.cnblogs.com/lchzls/
以及对应本平台的QQ群:161156071(大数据躺过的坑)
Hadoop MapReduce编程 API入门系列之挖掘气象数据版本3(九)的更多相关文章
- Hadoop MapReduce编程 API入门系列之挖掘气象数据版本2(十)
下面,是版本1. Hadoop MapReduce编程 API入门系列之挖掘气象数据版本1(一) 这篇博文,包括了,实际生产开发非常重要的,单元测试和调试代码.这里不多赘述,直接送上代码. MRUni ...
- Hadoop MapReduce编程 API入门系列之统计学生成绩版本2(十八)
不多说,直接上代码. 统计出每个年龄段的 男.女 学生的最高分 这里,为了空格符的差错,直接,我们有时候,像如下这样的来排数据. 代码 package zhouls.bigdata.myMapRedu ...
- Hadoop MapReduce编程 API入门系列之压缩和计数器(三十)
不多说,直接上代码. Hadoop MapReduce编程 API入门系列之小文件合并(二十九) 生成的结果,作为输入源. 代码 package zhouls.bigdata.myMapReduce. ...
- Hadoop MapReduce编程 API入门系列之join(二十六)(未完)
不多说,直接上代码. 天气记录数据库 Station ID Timestamp Temperature 气象站数据库 Station ID Station Name 气象站和天气记录合并之后的示意图如 ...
- Hadoop MapReduce编程 API入门系列之MapReduce多种输入格式(十七)
不多说,直接上代码. 代码 package zhouls.bigdata.myMapReduce.ScoreCount; import java.io.DataInput; import java.i ...
- Hadoop MapReduce编程 API入门系列之自定义多种输入格式数据类型和排序多种输出格式(十一)
推荐 MapReduce分析明星微博数据 http://git.oschina.net/ljc520313/codeexample/tree/master/bigdata/hadoop/mapredu ...
- Hadoop MapReduce编程 API入门系列之wordcount版本1(五)
这个很简单哈,编程的版本很多种. 代码版本1 package zhouls.bigdata.myMapReduce.wordcount5; import java.io.IOException; im ...
- Hadoop MapReduce编程 API入门系列之薪水统计(三十一)
不多说,直接上代码. 代码 package zhouls.bigdata.myMapReduce.SalaryCount; import java.io.IOException; import jav ...
- Hadoop MapReduce编程 API入门系列之Crime数据分析(二十五)(未完)
不多说,直接上代码. 一共12列,我们只需提取有用的列:第二列(犯罪类型).第四列(一周的哪一天).第五列(具体时间)和第七列(犯罪场所). 思路分析 基于项目的需求,我们通过以下几步完成: 1.首先 ...
随机推荐
- Ubuntu 16.04安装和卸载软件命令
安装软件 apt-get install softname1 softname2 softname3…… 卸载软件 apt-get remove softname1 softname2 softnam ...
- 记录:Ubuntu下安装SQL Developer
安装JDK. 用的Ubuntu18.04,已经自带JDK了. 下载SQL Developer. 官网链接:http://www.oracle.com/technetwork/developer-too ...
- [luogu1034] 矩形覆盖 (暴力)
传送门 Description 给n(n<=50)个点(x,y),要求用k(1<=k<=4)个没有联系的矩形覆盖住求矩形最小面积 Solution 感觉不是很可做,结果看TJ后发现数 ...
- 【ABCD组】Scrum meeting 2
前言 第2次会议在6月14日由组长在教9 405召开. 主要对下一步的工作进行说明安排,时长90min. 主要内容 经会议讨论,由于一些对知识掌握的原因,决定放弃java语言实现系统,改用c#完成此系 ...
- java 反射之获取泛型对象的所有字段与对应的值(包括父类的)
上代码: public static void main(String[] args) throws IntrospectionException { SysUser obj = new SysUse ...
- 【hihocoder 1475】 数组分拆
[题目链接]:http://hihocoder.com/problemset/problem/1475 [题意] _< [题解] /* 别人的题解 首先对于每个位置预处理数组的前缀和,即s[i] ...
- lucene_07_solr使用IK分词器
使用IKAnalyzer 中文分析器.. 第一步: 把,IKAnalyzer2012FF_u1j 添加到sol/WEB-INF/lib 目录下. 第二步: 复制IKAnalyzer 的配置文件和自定义 ...
- 服务器监控(包括性能指标与web应用程序)
http://blog.csdn.net/yao123long/article/details/53142029 http://blog.csdn.net/heyongluoyao8/article/ ...
- CODEVS——T 1004 四子连棋
http://codevs.cn/problem/1004/ 时间限制: 1 s 空间限制: 128000 KB 题目等级 : 黄金 Gold 题解 查看运行结果 题目描述 Descr ...
- hadoop1.0.4升级到hadoop2.2 具体流程步骤
hadoop1.x 升级到hadoop2.2 本文參考了博客:http://blog.csdn.net/ajax_jquery/article/details/27311671,对一些地方做了改动. ...