
Hadoop- MapReduce分布式计算框架原理
分布式计算:
原则:移动计算而尽可能减少移动数据(减少网络开销)
分布式计算其实就是将单台机器上的计算拓展到多台机器上并行计算。
MapReduce分布式计算框架体系结构
首先理解几个概念:
Job&Task:在hadoop mapreduce中,一个 Job 它是一个任务,主业务。一个Job 可以拆分成多个Task,map Task与reduce Task。
JobTracker:JobTracker是一个后台服务进程,启动之后,会一直监听并接收来自各个TaskTracker发送的心跳信息,包括资源使用情况和任务运行情况等信息
MapReduce体系结构里有两类节点,第一个是JobTracker,它是一个master管理节点,另一个是TaskTracker。客户端(Client)提交一个任务(Job),JobTracker把他提交到候选列队里,将Job拆分成map任务(Task)和reduce任务(Task),把map任务和reduce任务分给TaskTracker执行。在mapreduce编程模型里,Task一般起在和DataNode所在的同一台物理机上。如下图(图片来自网络):
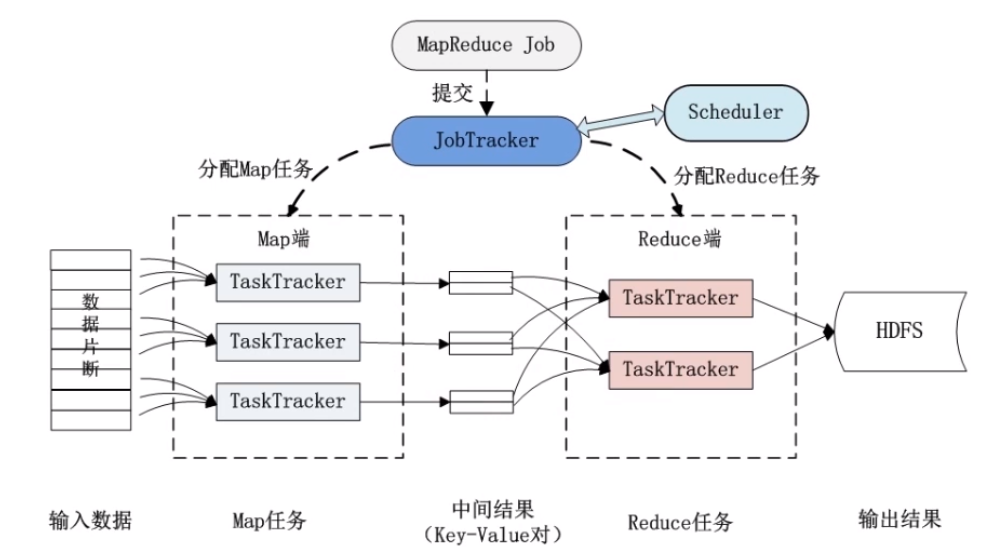
MapReduce分布式工作流程
1.分布式的运算程序往往需要分成至少2个阶段
MapReduce的第一阶段是Map,运行的实例叫Map Task,第二阶段是Reduce,运行的实例叫Reduce Task。每个Task只需要完成后把文件输出到自己的工作目录即可。
2.第一阶段的Task并发实例各司其职,各自为政,互不相干,完全并行
3.第二阶段的Task并发实例互不相干,但是他们的数据以来于上一阶段的所有Task并发实例的输出
4.MapReduce编程模型,只能包含一个Map阶段和一个Reduce阶段,如果用户的业务逻辑非常复杂,那就只能来多个mapreduce程序,串行运行
MapReduce容错机制
总结
以上知识体系基本能解决一下几个问题了:
Hadoop- MapReduce分布式计算框架原理的更多相关文章
- 【hadoop】MapReduce分布式计算框架原理
PS:实操部分就省略了哈,准备最近好好看下理论这块,其实我是比较懒得哈!!! <?>MapReduce的概述 MapReduce是一种计算模型,进行大数据量的离线计算.MapReduce实 ...
- hadoop MapReduce Yarn运行机制
原 Hadoop MapReduce 框架的问题 原hadoop的MapReduce框架图 从上图中可以清楚的看出原 MapReduce 程序的流程及设计思路: 首先用户程序 (JobClient) ...
- [转载] Hadoop MapReduce
转载自http://blog.csdn.net/yfkiss/article/details/6387613和http://blog.csdn.net/yfkiss/article/details/6 ...
- python - hadoop,mapreduce demo
Hadoop,mapreduce 介绍 59888745@qq.com 大数据工程师是在Linux系统下搭建Hadoop生态系统(cloudera是最大的输出者类似于Linux的红帽), 把用户的交易 ...
- Hadoop mapreduce框架简介
传统hadoop MapReduce架构(老架构) 从上图中可以清楚的看出原 MapReduce 程序的流程及设计思路: 1.首先用户程序 (JobClient) 提交了一个 job,job ...
- 简述MapReduce计算框架原理
1. MapReduce基本编程模型和框架 1.1 MapReduce抽象模型 大数据计算的核心思想是:分而治之.如下图所示.把大量的数据划分开来,分配给各个子任务来完成.再将结果合并到一起输出.注: ...
- [转] hadoop MapReduce实例解析-非常不错,讲解清晰
来源:http://blog.csdn.net/liuxiaochen123/article/details/8786715?utm_source=tuicool 2013-04-11 10:15 4 ...
- Hadoop MapReduce 一文详解MapReduce及工作机制
@ 目录 前言-MR概述 1.Hadoop MapReduce设计思想及优缺点 设计思想 优点: 缺点: 2. Hadoop MapReduce核心思想 3.MapReduce工作机制 剖析MapRe ...
- Hadoop MapReduce 保姆级吐血宝典,学习与面试必读此文!
Hadoop 涉及的知识点如下图所示,本文将逐一讲解: 本文档参考了关于 Hadoop 的官网及其他众多资料整理而成,为了整洁的排版及舒适的阅读,对于模糊不清晰的图片及黑白图片进行重新绘制成了高清彩图 ...
随机推荐
- Spring boot Security Disable security
When I use security.basic.enabled=false to disable security on a Spring Boot project that has the fo ...
- 使用yum方式在centOS上安装mysql
1.操作系统及MySQL版本 1.1 操作系统版本 CentOS release 6.5 (Final) 1.2 MySQL版本 mysql-5.1.73-3.el6_5.x86_64mysql-li ...
- mongodb副本集的基础概念和各种机制
从一开始我们就在讲如何使用一台服务器.一个mongod服务器进程,如果只用做学习和开发,这是可以的,但如果在生产环境中,这是很危险的,如果服务器崩溃了怎么办?数据库至少要一段时间不可用,如果 ...
- 【MVC2】发布到IIS上User.Identity.Name变成空
VS中运行时通过User.Identity.Name能取到用户名,发布到IIS上后,该值为空. 调查后发现在网站设定→[认证]中同时打开了[Windows认证]和[匿名认证], 关掉[匿名认证]后就能 ...
- 【转载】IIS与asp.net管道
阅读目录 asp.net是什么 HTTP协议 IIS与asp.net asp.net管道 参考资料 我们在基于asp.net开发web程序,基本上都是发布部署到安装了IIS的windows服务器上,然 ...
- xcode常见报错调试【原创】
BMKGeoCodeSearch 反向地理编码一直失败 Location 申请的key的安全码与代码中build id不一样,修改成一样就OK了 新建一个类,将百度地图的定位功能封装起来以后,定位的代 ...
- ASP.NET机制详细的管道事件流程(转)
ASP.NET机制详细的管道事件流程 第一:浏览器向服务器发送请求. 1)浏览器向iis服务器发送请求网址的域名,根据http协议封装成请求报文,通过dns解析请求的ip地址,接着通过socket与i ...
- 现在有一个城市销售经理,需要从公司出发,去拜访市内的商家,已知他的位置以及商家的位置,但是由于城市道路交通的原因,他只能在左右中选择一个方向,在上下中选择一个方向,现在问他有多少种方案到达商家地址。给定一个地图map及它的长宽n和m,其中1代表经理位置,2代表商家位置,-1代表不能经过的地区,0代表可以经过的地区,请返回方案数,保证一定存在合法路径。保证矩阵的长宽都小于等于10。
include "stdafx.h" #include<iostream> #include<vector> #include<algorithm&g ...
- LeetCode222——Count Complete Tree Nodes
Given a complete binary tree, count the number of nodes. Definition of a complete binary tree from W ...
- programming review (c++): (2)binary tree, BFS, DFS, recursive, non-recursive
1.二叉树定义 // Definition for a binary tree node. struct TreeNode { int val; TreeNode *left; TreeNode *r ...