
基于 Keras 用深度学习预测时间序列
本文主要参考了 Jason Brownlee 的博文 Time Series Prediction With Deep Learning in Keras
原文使用 python 实现模型,这里是用 R
基于 Keras 用深度学习预测时间序列
时间序列预测一直以来是机器学习中的一个难题。
在本篇文章中,将介绍如何在 R 中使用 keras 深度学习包构建神经网络模型实现时间序列预测。
文章的主要内容:
- 如何将时间序列预测问题表示成为一个回归问题,并建立对应的神经网络模型。
- 如何使用滞后时间的数据实现时间序列预测,并建立对应的神经网络模型。
问题描述
“航班旅客数据”是一个常用的时间序列数据集,该数据包含了 1949 至 1960 年 12 年间的月度旅客数据,共有 144 个观测值。
下载链接:international-airline-passengers.csv
多层感知机回归
时间序列预测中最简单的思路之一便是寻找当前和过去数据(\(X_t, X_{t-1}, \dots\))与未来数据($ X_{t+1}$)之间的关系,这种关系通常会表示成为一个回归问题。
下面着手将时间序列预测问题表示成一个回归问题,并建立神经网络模型用于预测。
首先,加载相关 R 包。
library(keras)

library(dplyr)

library(ggplot2)

library(ggthemes)

library(lubridate)
神经网络模型在训练时存在一定的随机性,所以要为计算统一随机数环境
set.seed(7)
画出整体数据的曲线图,对问题有一个直观的认识。
dataframe <- read.csv(

    'international-airline-passengers.csv')

dataframe$Month <- paste0(dataframe$Month,'-01') %>%

    ymd()

ggplot(

    data = dataframe,

    mapping = aes(

        x = Month,

        y = passengers)) +

    geom_line() +

    geom_point() +

    theme_economist() +

    scale_color_economist()
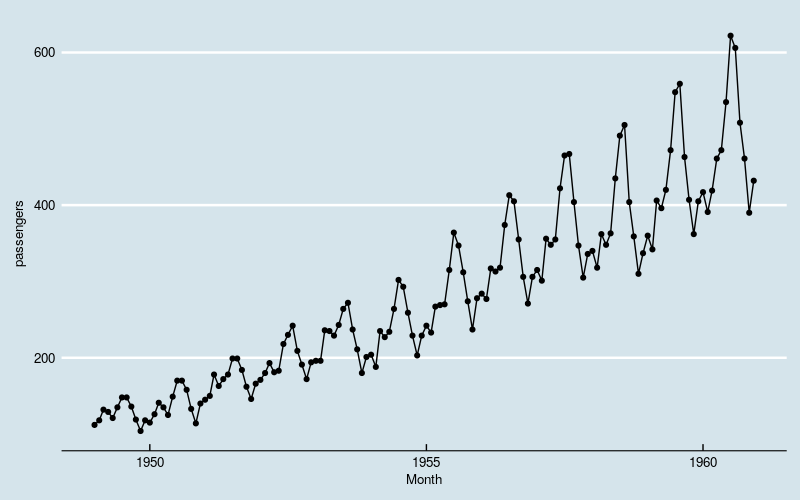
图1
很显然,数据体现出“季节性”,同时存在线性增长和波动水平增大的趋势。
将数据集分成两部分:训练集和测试集,比例分别占数据集的 2/3 和 1/3。
dataset <- dataframe$passengers

train_size <- as.integer(length(dataset) * 0.67)

test_size <- length(dataset) - train_size

train <- dataset[1:train_size]

test <- dataset[(train_size + 1):length(dataset)]

cat(length(train), length(test))
96 48
为训练神经网络对数据做预处理,用数据构造出两个矩阵,分别是“历史数据”(作为预测因子)和“未来数据”(作为预测目标)。这里用最近一个月的历史数据做预测。
create_dataset <- function(dataset,

                           look_back = 1)

{

    l <- length(dataset)

    dataX <- matrix(nrow = l - look_back, ncol = look_back)

    for (i in 1:ncol(dataX))

    {

        dataX[, i] <- dataset[i:(l - look_back + i - 1)]

    }

    dataY <- matrix(

        data = dataset[(look_back + 1):l],

        ncol = 1)

    return(

        list(

            dataX = dataX,

            dataY = dataY))

}

look_back <- 1

trainXY <- create_dataset(train, look_back)

testXY <-  create_dataset(test, look_back)
下面构造神经网络的框架结构并用处理过的训练数据训练。
model <- keras_model_sequential()

model %>%

    layer_dense(

        units = 8,

        input_shape = c(look_back),

        activation = 'relu') %>%

    layer_dense(units = 1) %>%

    compile(

        loss = 'mean_squared_error',

        optimizer = 'adam') %>%

    fit(

        trainXY$dataX,

        trainXY$dataY,

        epochs = 200,

        batch_size = 2,

        verbose = 2)
训练结果如下。
trainScore <- model %>%

    evaluate(

        trainXY$dataX,

        trainXY$dataY,

        verbose = 0)

testScore <- model %>%

    evaluate(

        testXY$dataX,

        testXY$dataY,

        verbose = 0)

sprintf(

    'Train Score: %.2f MSE (%.2f RMSE)',

    trainScore,

    sqrt(trainScore))

sprintf(

    'Test Score: %.2f MSE (%.2f RMSE)',

    testScore,

    sqrt(testScore))
[1] "Train Score: 538.50 MSE (23.21 RMSE)"

[1] "Test Score: 2342.33 MSE (48.40 RMSE)"
把训练数据的拟合值、测试数据的预测值和原始数据画在一起。
trainPredict <- model %>%

    predict(trainXY$dataX)

testPredict <- model %>%

    predict(testXY$dataX)

df <- data.frame(

    index = 1:length(dataset),

    value = dataset,

    type = 'raw') %>%

    rbind(

        data.frame(

            index = 1:length(trainPredict) + look_back,

            value = trainPredict,

            type = 'train')) %>%

    rbind(

        data.frame(

            index = 1:length(testPredict) + look_back + length(train),

            value = testPredict,

            type = 'test'))

ggplot(data = df) +

    geom_line(

        mapping = aes(

            x = index,

            y = value,

            color = type)) +

    geom_point(

        mapping = aes(

            x = index,

            y = value,

            color = type)) +

    geom_vline(

        xintercept = length(train) + 0.5) +

    theme_economist() +

    scale_color_economist()
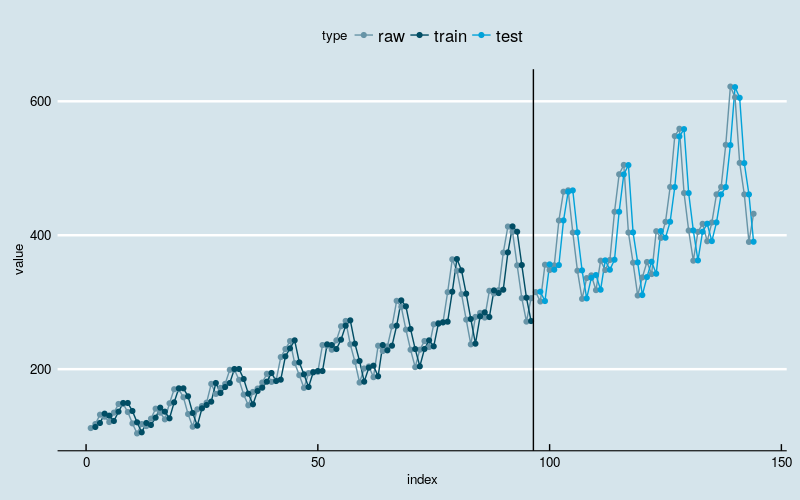
图2
黑线左边是训练部分,右边是测试部分。
从图中可以看出,神经网络模型抓住了数据线性增长和波动率逐渐增加的两大趋势,在不做数据转换的前提下,这是经典的时间序列分析模型不容易做到的;但是很可能没有识别出“季节性”的结构特点,因为训练和预测结果和原始数据之间存在“平移错位”。
多层感知机回归结合“窗口法”
前面的例子可以看出,如果仅使用\(X_{t-1}\)来预测\(X_t\),很难让神经网络模型识别出“季节性”的结构特征,因此有必要尝试增加“窗口”宽度,使用更多的历史数据(包含一个完整的周期)训练模型。
下面将数 create_dataset 中的参数 look_back 设置为 12,用来包含过去 1 年的历史数据,重新训练模型。
look_back <- 12

trainXY <- create_dataset(train, look_back)

testXY <-  create_dataset(test, look_back)

model <- keras_model_sequential()

model %>%

    layer_dense(

        units = 8,

        input_shape = c(look_back),

        activation = 'relu') %>%

    layer_dense(units = 1) %>%

    compile(

        loss = 'mean_squared_error',

        optimizer = 'adam') %>%

    fit(

        trainXY$dataX,

        trainXY$dataY,

        epochs = 200,

        batch_size = 2,

        verbose = 2)

trainScore <- model %>%

    evaluate(

        trainXY$dataX,

        trainXY$dataY,

        verbose = 0)

testScore <- model %>%

    evaluate(

        testXY$dataX,

        testXY$dataY,

        verbose = 0)

sprintf(

    'Train Score: %.2f MSE (%.2f RMSE)',

    trainScore,

    sqrt(trainScore))

sprintf(

    'Test Score: %.2f MSE (%.2f RMSE)',

    testScore,

    sqrt(testScore))

trainPredict <- model %>%

    predict(trainXY$dataX)

testPredict <- model %>%

    predict(testXY$dataX)

df <- data.frame(

    index = 1:length(dataset),

    value = dataset,

    type = 'raw') %>%

    rbind(

        data.frame(

            index = 1:length(trainPredict) + look_back,

            value = trainPredict,

            type = 'train')) %>%

    rbind(

        data.frame(

            index = 1:length(testPredict) + look_back + length(train),

            value = testPredict,

            type = 'test'))

ggplot(data = df) +

    geom_line(

        mapping = aes(

            x = index,

            y = value,

            color = type)) +

    geom_point(

        mapping = aes(

            x = index,

            y = value,

            color = type)) +

    geom_vline(

        xintercept = length(train) + 0.5) +

    theme_economist() +

    scale_color_economist()
[1] "Train Score: 157.17 MSE (12.54 RMSE)"

[1] "Test Score: 690.69 MSE (26.28 RMSE)"
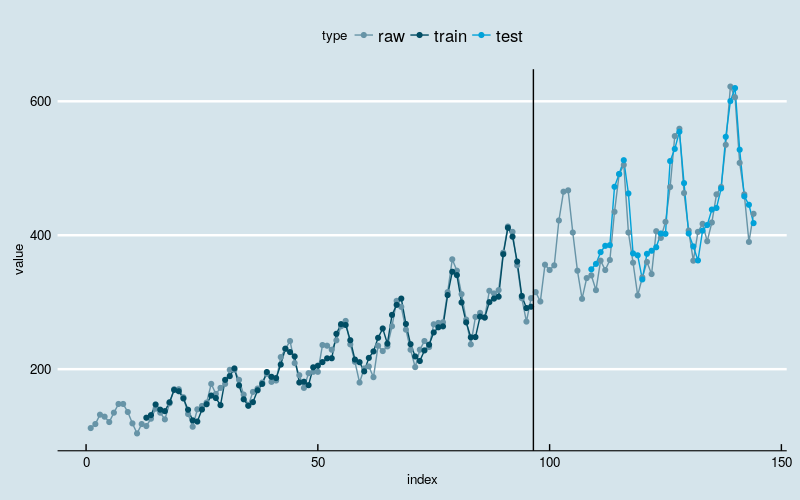
图3
新的模型基本上克服了“平移错位”的现象,同时依然能够识别出线性增长和波动率逐渐增加的两大趋势。
改进方向
- 目前对“季节性”的识别是靠增加历史数据实现的,能否从神经网络结构的方向入手。
- 目前的模型中几乎没有用到“特征工程”,如何用特征工程表示数据中存在的主要趋势和结构化特征。
- DNN + ARIMA:一方作为另外一方的“特征工程”手段。
扩展阅读
基于 Keras 用深度学习预测时间序列的更多相关文章
- [AI开发]centOS7.5上基于keras/tensorflow深度学习环境搭建
这篇文章详细介绍在centOS7.5上搭建基于keras/tensorflow的深度学习环境,该环境可用于实际生产.本人现在非常熟练linux(Ubuntu/centOS/openSUSE).wind ...
- 基于 Keras 用 LSTM 网络做时间序列预测
目录 基于 Keras 用 LSTM 网络做时间序列预测 问题描述 长短记忆网络 LSTM 网络回归 LSTM 网络回归结合窗口法 基于时间步的 LSTM 网络回归 在批量训练之间保持 LSTM 的记 ...
- 学习Keras:《Keras快速上手基于Python的深度学习实战》PDF代码+mobi
有一定Python和TensorFlow基础的人看应该很容易,各领域的应用,但比较广泛,不深刻,讲硬件的部分可以作为入门人的参考. <Keras快速上手基于Python的深度学习实战>系统 ...
- (转) 基于Theano的深度学习(Deep Learning)框架Keras学习随笔-01-FAQ
特别棒的一篇文章,仍不住转一下,留着以后需要时阅读 基于Theano的深度学习(Deep Learning)框架Keras学习随笔-01-FAQ
- 从Theano到Lasagne:基于Python的深度学习的框架和库
从Theano到Lasagne:基于Python的深度学习的框架和库 摘要:最近,深度神经网络以“Deep Dreams”形式在网站中如雨后春笋般出现,或是像谷歌研究原创论文中描述的那样:Incept ...
- 基于OpenCL的深度学习工具:AMD MLP及其使用详解
基于OpenCL的深度学习工具:AMD MLP及其使用详解 http://www.csdn.net/article/2015-08-05/2825390 发表于2015-08-05 16:33| 59 ...
- 基于TensorFlow的深度学习系列教程 2——常量Constant
前面介绍过了Tensorflow的基本概念,比如如何使用tensorboard查看计算图.本篇则着重介绍和整理下Constant相关的内容. 基于TensorFlow的深度学习系列教程 1--Hell ...
- 基于pythpn的深度学习 - 记录
[基于pythpn的深度学习] 环境: windows/linux-ubuntu Tensorflow (基于anaconda) *安装 (python3.5以上不支持) ...
- 使用Keras进行深度学习:(七)GRU讲解及实践
####欢迎大家关注我们的网站和系列教程:http://www.tensorflownews.com/,学习更多的机器学习.深度学习的知识! 介绍 GRU(Gated Recurrent Unit) ...
随机推荐
- Pig order by用法举例
sorted = order data by $0; 数值类型按照数值大小比较 chararray类型按照字符的字典顺序比较 bytearray按照字节的字典顺序比较 复杂类型(map.tuple ...
- 指令-Directive
restrict:'A'用作设定用那种方式使用指令. 可组合使用如restrict:'AE' E - 元素名称: <my-directive></my-directive> A ...
- [翻译] AFSoundManager
AFSoundManager iOS audio playing (both local and streaming) and recording made easy through a comple ...
- Mycat分片规则详解
1.分片枚举 通过在配置文件中配置可能的枚举 id,自己配置分片,本规则适用于特定的场景,比如有些业务需要按照省份或区县来做保存,而全国省份区县固定的,这类业务使用本条规则,配置如下: <tab ...
- 一、TCL事务控制语言 二、MySQL中的约束 三、多表查询(重点) 四、用户的创建和授权 五、MySQL中的索引
一.TCL事务控制语言###<1>事务的概念 事务是访问并可能更新数据库中各种数据项的执行单元. 事务是一条SQL语句,一组SQL语句,或者整个程序. 事务是恢复和并发控制的基本单位. 事 ...
- November 25th 2016 Week 48th Friday
People will fall for its appearance while driving passionately. 观者倾心,驭者动魄. This is an advertisement ...
- 18年10月31日 NOIP模拟赛
T1.exercise 题解 数据很小直接模拟 代码 #include<iostream> #include<cstdio> #include<cmath> #in ...
- Alpha 冲刺报告
Alpha 冲刺报告(4/10) 队名:洛基小队 峻雄(组长) 已完成:继续行动脚本的编写 明日计划:尽量完成角色的移动 剩余任务:物品背包交互代码 困难:具体编码进展比较缓慢 ----------- ...
- Git学习文档——文件状态git status
1.已经跟踪的文件有三种状态 已跟踪的文件,即被纳入版本控制的文件,又分为未修改(unmodified).已修改(modified).已暂存(staged)三种状态. 如图: 当在工作目录中新加入一个 ...
- 使用Linux进行缓冲区溢出实验的配置记录
在基础的软件安全实验中,缓冲区溢出是一个基础而又经典的问题.最基本的缓冲区溢出即通过合理的构造输入数据,使得输入数据量超过原始缓冲区的大小,从而覆盖数据输入缓冲区之外的数据,达到诸如修改函数返回地址等 ...