
ELK学习之Logstash+Kafka篇
上一篇介绍了一下Logstash的数据处理过程以及一些基本的配置功能,同时也提到了Logstash作为一个数据采集端,支持对接多种输入数据源,其中就包括Kafka。那么这次的学习不妨研究一下Logstash如何接收Kafka输入的数据,并与日志中的数据进行统一的处理。
首先在Logstash的配置文件中配置Kafka的数据源(因为篇幅原因,Kafka和ZooKeeper的安装部署就不做介绍了):
input {

    file {

        path => "D:/logstash-7.14.1/test-log/test.log"

        start_position => beginning

    }

    kafka {

        bootstrap_servers => "localhost:9092"

        topics => "test_topic"

    }

}
如上方所示,我们在上一篇的配置文件中追加了Kafka的地址以及主题用来订阅与消费,input插件中kafka项的详细信息也如上一篇所说,可以在官网上进行查看,https://www.elastic.co/guide/en/logstash/current/plugins-inputs-kafka.html#plugins-inputs-kafka-topics
接下来需要一个生产者往Kafka推送数据以供Logstash端采集,那么新增一个Kafka的测试工程来实现,代码如下:
String server = "127.0.0.1:9092";

String topic = "test_topic";

Properties props = new Properties();

props.put("bootstrap.servers", server);

props.put("transactional.id", "my-transactional-id");

KafkaCallback callback = new KafkaCallback();

Producer<String, String> producer = new KafkaProducer<>(props, new StringSerializer(), new StringSerializer());

producer.initTransactions();

try {

    producer.beginTransaction();

    for (int i = 0; i < 5; i++) {

        producer.send(new ProducerRecord<String, String>("test_topic", Integer.toString(i), "093124." + (597 + i) + "[0][28412]:[5]FindResponseByPage[fund_account=900010328]"), callback);

    }

    producer.commitTransaction();

} catch (KafkaException e) {

    producer.abortTransaction();

}

producer.close();
回调类KafkaCallback的代码也贴一下,主要就是接收一下应答并打印分配的偏移量以及存储的分区信息:
public class KafkaCallback implements Callback {

    public void onCompletion(RecordMetadata metadata, Exception e) {

        if (e != null)

            e.printStackTrace();

        SimpleDateFormat df = new SimpleDateFormat("HH:mm:ss.SSS");

        System.out.println("[" + df.format(new Date()) + "]partition: " + metadata.partition() + ", offset: " + metadata.offset());

    }

}
启动Logstash后也把Kafka的生产者小程序给run起来:
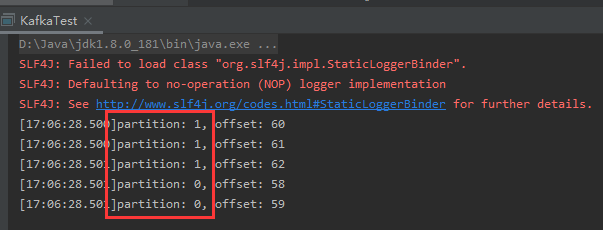
看到消息已经成功推送到Kafka,那么再看下Logstash是否成功收到:
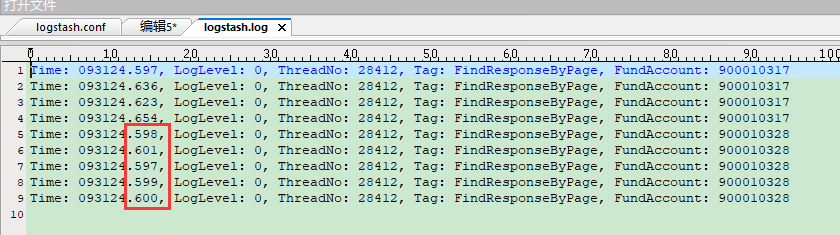
从输出日志中可以看到Logstash从Kafka消费成功,并且来自两个数据源的信息统一进行了输出。不过从上方的两张截图来看,Kafka的消息被发送到了不同的分区,因此Logstash消费时出现了乱序。
这时就引入了两个问题:
1. 从Kafka拉取的数据格式和日志中的数据格式不统一怎么办?
2. Kafka仅在分区内保证顺序,Logstash如果对顺序有着严格要求,怎么办?
首先我们来看第一个问题,不同的数据源数据格式不统一其实是个大概率的事情。那么是否可以针对不同的数据源进行不同的grok分析呢?没找到相关的资料能够支持这种区分的配置,只能通过grok的多match规则顺序执行(第一条失败了会执行第二条)来勉强达到要求。不过进一步考虑下来,架构上可以采用多个Logstash分别来进行不同数据源的信息采集,进行一个数据的初步整理后再分发到下游的ElasticSearch。这样部署上更加灵活,在对各个Logstash的节点进行配置时的限制也会更少。
要回答第二个问题,首先需要了解Kafka为什么会有分区的概念。Kafka对同一个topic支持设置多个分区,主要是为了能够将一个topic的数据处理水平扩展到位于多台服务器的broker中以此提升性能。那么如果说需要对接的系统仅仅是从侵入性考虑不愿意让日志采集直接对接日志或者数据库,而是通过Kafka这种消息中间件来进行解耦,那么专门用来进行日志采集的主题可以设置为只有1个分区。
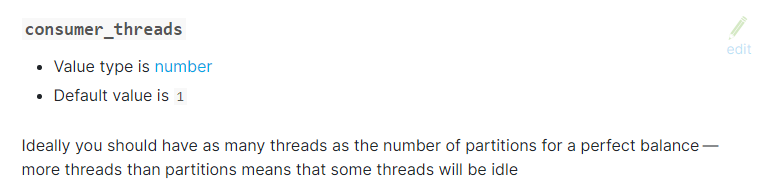
查看官网,发现input-kafka插件有一个配置项叫做consumer_threads,也就是消费者线程数。那么即便是Kafka的对应主题配置了1个分区,还需要将消费者线程数配置为1,否则同一个消费者组内的多个消费者来拉取同一分区内的数据也没有办法做到顺序。不过该配置项默认值就是1,不太容易踩到这个坑。
综上所述,如果对于消费的数据有严格的顺序要求,消息中间件不妨选用RabbiMQ,Logstash本身也提供了对接RabbitMQ的插件。另外,在对接不同数据源时可以采用多Logstash服务进行区分采集的部署方式。
ELK学习之Logstash+Kafka篇的更多相关文章
- ELK学习之Logstash篇
Logstash在ELK这一整套解决方案中作为数据采集终端,支持对接Kafka.数据库(MySQL.Oracle).文件等等. 而在Logstash内部的数据流转,主要经过三个环节:input -&g ...
- ELK学习笔记之Logstash详解
0x00 Logstash概述 官方介绍:Logstash is an open source data collection engine with real-time pipelining cap ...
- ELK 性能(1) — Logstash 性能及其替代方案
ELK 性能(1) - Logstash 性能及其替代方案 介绍 当谈及集中日志到 Elasticsearch 时,首先想到的日志传输(log shipper)就是 Logstash.开发者听说过它, ...
- ELK stack elasticsearch/logstash/kibana 关系和介绍
ELK stack elasticsearch 后续简称ES logstack 简称LS kibana 简称K 日志分析利器 elasticsearch 是索引集群系统 logstash 是日志归集集 ...
- kafka学习2:kafka集群安装与配置
在前一篇:kafka学习1:kafka安装 中,我们安装了单机版的Kafka,而在实际应用中,不可能是单机版的应用,必定是以集群的方式出现.本篇介绍Kafka集群的安装过程: 一.准备工作 1.开通Z ...
- Java工程师学习指南(中级篇)
Java工程师学习指南 中级篇 最近有很多小伙伴来问我,Java小白如何入门,如何安排学习路线,每一步应该怎么走比较好.原本我以为之前的几篇文章已经可以解决大家的问题了,其实不然,因为我写的文章都是站 ...
- 从零开始学习jQuery (一) 入门篇
本系列文章导航 从零开始学习jQuery (一) 入门篇 一.摘要 本系列文章将带您进入jQuery的精彩世界, 其中有很多作者具体的使用经验和解决方案, 即使你会使用jQuery也能在阅读中发现些 ...
- RabbitMQ学习总结 第三篇:工作队列Work Queue
目录 RabbitMQ学习总结 第一篇:理论篇 RabbitMQ学习总结 第二篇:快速入门HelloWorld RabbitMQ学习总结 第三篇:工作队列Work Queue RabbitMQ学习总结 ...
- [原]零基础学习视频解码之android篇系列文章
截止今天,<零基础学习视频解码系列文章>.<零基础学习在Android进行SDL开发系列文章>以及<零基础学习视频解码之android篇>系列文章基本算是告一段落了 ...
随机推荐
- GitHub秘钥(SSH Key)
一.公钥的作用 公钥一般给服务器,别人权限中加入我给的公钥,当我们从远地仓库中下载项目(git clone xxx)的时 那个服务器通过他的绑定的公钥来匹配我的私钥,如果匹配,则就可以正常下载,如果不 ...
- CF466C 题解
Description 给定一个数组,求有多少组 \(i,j\) 将整个数组分成和相等的三个数组. Solution 从左往右看一遍,记录每一个 \(i\) 使得 \(\sum_{k=1}^i a_k ...
- 2021大厂Android面试高频100题最新汇总(附答案详解)
前言 现在越来越多的人应聘工作时都得先刷个几十百来道题,不刷题感觉都过不了面试. 无论是前后端.移动开发,好像都得刷题,这么多人通过刷题过了面试,说明刷题对于找工作还是有帮助的. 不过这其中有一个问题 ...
- 『Java』Collection接口 Collections类
接口Collection public interface Collection<E>定义了所有单列集合中共性的方法,所有的单列集合都可以使用共性方法. Collection的常用子接口有 ...
- centos7 更新源
centos7 yum源更新 先进入到yum源文件cd /etc/yum.repo.d/ 1.创建一个repo_bak目录,用于保存系统中原来yum的repo文件. sudo mkdir rep ...
- STM32—串口通讯详解
串口通讯目录 物理层 协议层 USART简介 开发板与上位机的连接 代码讲解: 一.初始化结构体 二.NVIC配置中断优先级 三.USART配置函数讲解 四.传输数据的函数: 1.发送一个字节 2.发 ...
- Python小白的数学建模课-17.条件最短路径
条件最短路径问题,指带有约束条件.限制条件的最短路径问题.例如: 顶点约束,包括必经点或禁止点的限制: 边的约束,包括必经路段.禁行路段和单向路段:无权路径长度的限制,如要求经过几步或不超过几步到达终 ...
- NOIP 模拟 $26\; \rm 神炎皇$
题解 \(by\;zj\varphi\) 一道 \(\varphi()\) 的题. 对于一个合法的数对,设它为 \((a*m,b*m)\) 则 \(((a+b)*m)|a*b*m^2\),所以 \(( ...
- NOIP 模拟 $17\; \rm weight$
题解 \(by\;zj\varphi\) 一道树剖的题 先对于原图求出一棵最小生成树,求出来的这棵树中的边定为树边,其它边叫非树边 那么对于一条非树边,它要成为最小生成树上的边,权值只能为连接它两个端 ...
- NOIP 模拟 $14\; \text{队长快跑}$
题解 \(by\;zj\varphi\) 一道很妙的 \(dp\) 题,方程状态不好设置,细节也不少 看到数据范围,直接想离散化 设 \(f_{i,j}\) 表示处理完前 \(i\) 个水晶,其中摧毁 ...