
Spark基础:(七)Spark Streaming入门
介绍
1、是spark core的扩展,针对实时数据流处理,具有可扩展、高吞吐量、容错.
数据可以是来自于kafka,flume,tcpsocket,使用高级函数(map reduce filter ,join , windows),
处理的数据可以推送到database,hdfs,针对数据流处理可以应用到机器学习和图计算中。
内部,spark接受实时数据流,分成batch(分批次)进行处理,最终在每个batch终产生结果stream.
2.discretized stream or DStream,
离散流,表示的是连续的数据流。
通过kafka、flume等输入数据流产生,也可以通过对其他DStream进行高阶变换产生。
在内部,DStream是表现为RDD序列。
体验
依赖
<dependency>

            <groupId>org.apache.spark</groupId>

            <artifactId>spark-streaming_2.11</artifactId>

            <version>2.1.0</version>

        </dependency>
scalaDeno
import org.apache.spark._

        import org.apache.spark.streaming._

        import org.apache.spark.streaming.StreamingContext._

        object SparkStreamingDemo {

            def main(args: Array[String]): Unit = {

                //local[n] n > 1

                val conf = new SparkConf().setMaster("local[2]").setAppName("NetworkWordCount")

                //创建Spark流上下文,批次时长是1s

                val ssc = new StreamingContext(conf, Seconds(1))

                //创建socket文本流

                val lines = ssc.socketTextStream("localhost", 9999)

                //压扁

                val words = lines.flatMap(_.split(" "))

                //变换成对偶

                val pairs = words.map((_,1));

                val count = pairs.reduceByKey(_+_) ;

                count.print()

                //启动

                ssc.start()

                //等待结束

                ssc.awaitTermination()

            }

        }
1.启动nc服务器
[win7]
cmd>nc -lL -p 9999
2.启动spark Streaming程序
3.在nc的命令行输入单词.
hello world
4.观察spark计算结果。
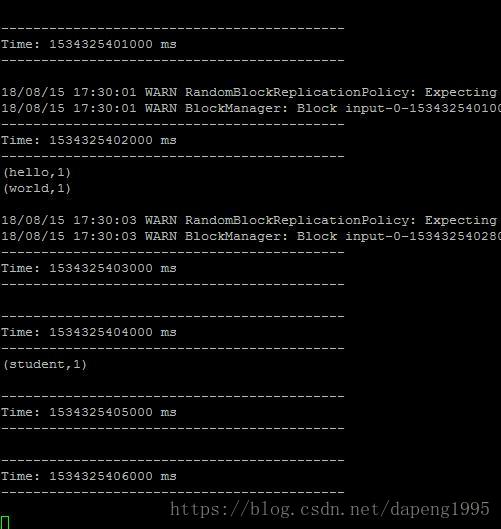
同样的丢到
Spark基础:(七)Spark Streaming入门的更多相关文章
- Spark 基础操作
1. Spark 基础 2. Spark Core 3. Spark SQL 4. Spark Streaming 5. Spark 内核机制 6. Spark 性能调优 1. Spark 基础 1. ...
- 【原创 Hadoop&Spark 动手实践 5】Spark 基础入门,集群搭建以及Spark Shell
Spark 基础入门,集群搭建以及Spark Shell 主要借助Spark基础的PPT,再加上实际的动手操作来加强概念的理解和实践. Spark 安装部署 理论已经了解的差不多了,接下来是实际动手实 ...
- spark streaming 入门例子
spark streaming 入门例子: spark shell import org.apache.spark._ import org.apache.spark.streaming._ sc.g ...
- Spark基础脚本入门实践3:Pair RDD开发
Pair RDD转化操作 val rdd = sc.parallelize(List((1,2),(3,4),(3,6))) //reduceByKey,通过key来做合并val r1 = rdd.r ...
- Spark基础脚本入门实践1
1.创建数据框架 Creating DataFrames val df = spark.read.json("file:///usr/local/spark/examples/src/mai ...
- spark基础知识(1)
一.大数据架构 并发计算: 并行计算: 很少会说并发计算,一般都是说并行计算,但是并行计算用的是并发技术.并发更偏向于底层.并发通常指的是单机上的并发运行,通过多线程来实现.而并行计算的范围更广,他是 ...
- 初步了解Spark生态系统及Spark Streaming
一. 场景 ◆ Spark[4]: Scope: a MapReduce-like cluster computing framework designed for low-laten ...
- spark基础知识介绍2
dataframe以RDD为基础的分布式数据集,与RDD的区别是,带有Schema元数据,即DF所表示的二维表数据集的每一列带有名称和类型,好处:精简代码:提升执行效率:减少数据读取; 如果不配置sp ...
- 最全的spark基础知识解答
原文:http://www.36dsj.com/archives/61155 一. Spark基础知识 1.Spark是什么? UCBerkeley AMPlab所开源的类HadoopMapReduc ...
- Spark基础学习精髓——第一篇
Spark基础学习精髓 1 Spark与大数据 1.1 大数据基础 1.1.1 大数据特点 存储空间大 数据量大 计算量大 1.1.2 大数据开发通用步骤及其对应的技术 大数据采集->大数据预处 ...
随机推荐
- linux job
通常运行的进程 ctrl-z之后会暂停到后台 bash test.sh Linux-4.15.0-36-generic-x86_64-with-Ubuntu-16.04-xenial #39~16.0 ...
- Mysql 5.7 集群部署,keepalived
参考文章: https://blog.csdn.net/f18770366447/article/details/80703347 https://www.cnblogs.com/benjamin77 ...
- elasticsearch中query_string的隐藏坑
elasticsearch查询中使用filter查询添加query_string格式为: { "query_string": { ...
- 1个月连载30个设计模式真实案例(附源码),挑战年薪60W不是梦
本文所有内容均节选自<设计模式就该这样学> 本文自2012年10月29日起持续连载,请大家持续关注.... 序言 Design Patterns: Elements of Reusable ...
- Java String 转成 二位数组
... package str; import java.util.ArrayList; import java.util.Arrays; import java.util.HashMap; impo ...
- etcd install & configuration
目录 概述 先决条件 相关术语 ETCD 部署 源码安装 其他方式 安装报错 配置文件详解 etcdctl 使用 日志独立 概述 etcd 是兼具一致性和高可用性的键值数据库,为云原生架构中重要的基础 ...
- uni-app 微信小程序全局分享
实际使用中,经常需要小程序分享到好友或者朋友圈,一般而言是一个个页面去设置. 官网分享介绍:https://uniapp.dcloud.io/api/plugins/share?id=onsharea ...
- [loj3146]路灯
显然,能从$l$到$r$当且仅当$[l,r)$中的灯全部都亮,以下不妨令询问的$r$全部减1 当修改节点$x$时,找到包含$x$的极大的灯(除$x$以外)全部都亮的区间$[l,r]$,即令$l_{0} ...
- [luogu1438]无聊的数列
考虑令$b_{i}=a_{i+1}-a_{i}$,那么1操作相当于对L加上K,对(L,R]区间加上D,对R+1减去K+(R-L)*D,然后询问区间和即可 1 #include<bits/stdc ...
- [noi707]LP
(以下用$Sa=\sum_{j=1}^{i}xi\cdot ai$,Sb和Sc同理)令f[i][x]表示前i个数,$Sa\le x\le Sb$时最小的Sc考虑第i个数是否选择,可以得到递推式$f[i ...