
Scrapy爬虫框架第三讲(linux环境)
下面我们来学习下Spider的具体使用:

我们已上节的百度阅读爬虫为例来进行分析:
  1 # -*- coding: utf-8 -*-

  2 import scrapy

  3 from scrapy.linkextractors import LinkExtractor

  4 from ..items import BookItem

  5

  6 class BookSpider(scrapy.Spider):

  7     name = 'book'

  8     allowed_domains = ['yuedu.baidu.com']

  9     #定义起始爬取点

 10     start_urls = ['https://yuedu.baidu.com/rank/newbook?pn=0']

 11

 12     #提取书籍列表页面

 13     def parse(self, response):

 14         #提取每本书点书籍页面链接

 15         le = LinkExtractor(restrict_css = 'a.al.title-link')

 16         le.extract_links(response)

 17         for link in le.extract_links(response):

 18             yield scrapy.Request(link.url,callback = self.parse_book)

 19

 20         #提取下个页面的列表页面

 21         url = url = response.css('div.pager a.next::attr(href)').extract_first()

 22         if url:

 23             url = response.urljoin(url)

 24             yield scrapy.Request(url,callback = self.parse)

 25

 26     #解析每本书的页面

 27     def parse_book(self,response):

 28         sel = response.css('div.content-block')

 29

 30         item = BookItem()

 31         item['name'] = sel.css('h1.book-title::attr(title)').extract_first()

 32         item['rating'] = sel.css('div.doc-info-score span.doc-info-score-value::text')    .extract_first()

 33         item['authors'] = sel.css('li.doc-info-field.doc-info-author a::text').extract    _first()

 34         item['publisher'] = sel.css('li.doc-info-field a::text').extract_first()

 35         item['price'] = sel.css('div.doc-info-price span.numeric::text').extract_first    ()

 36

 37         yield item
1、继承scrap.Spider

摘自官方文档
意思如下:scrapy框架为我们提供了一个Spider基类,我们编写的spider要继承它,如上面我们编写了一个BookSpider类,而这个类是继承于scrapy.Spider的
name属性:顾名思义就是命名,如上面我们将其命名为BookSpider,这是识别Spider的唯一标志(相当于你叫什么),供后面我们执行scrapy crawl 时使用,告诉spider 使用哪个Spider 去爬取
allowed_domains属性:顾名思义就是定义爬取的域名(也就是在哪个网站开始我们的爬虫)
start_urls属性:顾名思义就是定义起始爬取点【通常被实现为一个列表】
start_requests属性:
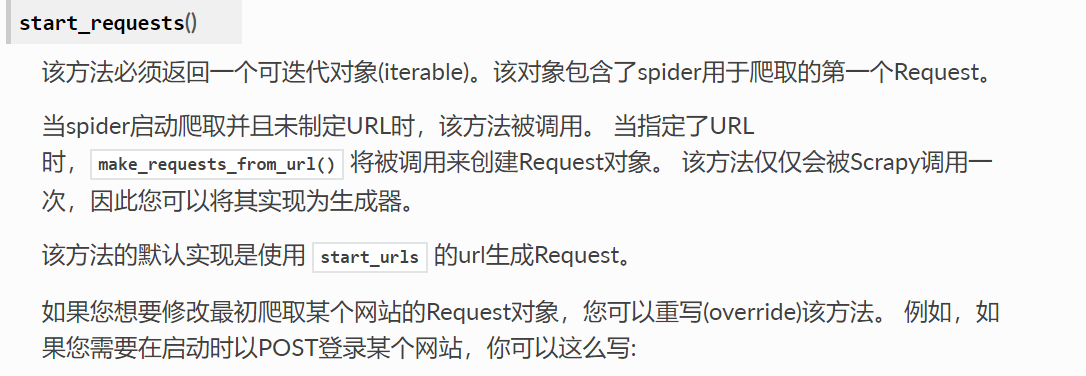
摘自官网
我们来解读下:
上面我们声明了start_urls通常为一个列表对象,实际上对于起始爬取点的请求是由Scrapy引擎调用Spider中的start_requests提交的,通过分析源码我们知道start_requests通过调用start_urls中的每一个u'r'l来构造Request请求
这里就提供给各位小伙伴一个重新定义起始爬取点的方法,即修改start_requests方法【它需要返回一个可迭代对象(列表、生成器等)】
示例如下:
def start_requests(self):
yield scrapy.Request('https://yuedu.baidu.com/rank/newbook?pn=20',callback = self.parse_book,headers = {User-Agent:'........'},dont_filter =True)
我们来分析下:
我们重新定义的起始爬取点为百度阅读新书榜第二页,并指定了回调函数为parse_book(如不指定会自动回调parse函数),设置了请求头字段,并更改了dont_filter为True (这里该字段默认为False 即对同一个url多次提交下载请求时,后面的请求会被去重过滤器过滤,这里我们设定了避免被过滤,进行强制下载!)--针对Request和Response对象小伙伴们我会单独列一篇文章与大家一起学习!
parse属性:顾名思义就是指定页面解析函数它的作用如下:
1、使用选择器提取页面中的信息,将数据封装后传个Scrapy引擎
2、使用选择器或者LinkExtractor提取页面中的链接,构造新的Request对象给Scrapy引擎

摘自官网
总结:
本文我们学习了spider的使用,它有四大基本属性name ; allowed_domains ; start_urls ;start_requests (其他的小伙伴们参见官网http://scrapy-chs.readthedocs.io/zh_CN/1.0/topics/spiders.html),并学了构造起始爬取点的两种方法和整个spider的工作流程定义Spider类---命名爬虫---定义爬取的域名---定义起始爬取点--传递给页面解析函数进行解析
最后小伙伴DO YOU UNDERSTAND?明白了我们继续往下一起学习吧!
Scrapy爬虫框架第三讲(linux环境)的更多相关文章
- Scrapy爬虫框架第一讲(Linux环境)
1.What is Scrapy? 答:Scrapy是一个使用python语言(基于Twistec框架)编写的开源网络爬虫框架,其结构清晰.模块之间的耦合程度低,具有较强的扩张性,能满足各种需求.(前 ...
- Python之Scrapy爬虫框架安装及简单使用
题记:早已听闻python爬虫框架的大名.近些天学习了下其中的Scrapy爬虫框架,将自己理解的跟大家分享.有表述不当之处,望大神们斧正. 一.初窥Scrapy Scrapy是一个为了爬取网站数据,提 ...
- scrapy爬虫框架教程(二)-- 爬取豆瓣电影TOP250
scrapy爬虫框架教程(二)-- 爬取豆瓣电影TOP250 前言 经过上一篇教程我们已经大致了解了Scrapy的基本情况,并写了一个简单的小demo.这次我会以爬取豆瓣电影TOP250为例进一步为大 ...
- Python爬虫教程-31-创建 Scrapy 爬虫框架项目
本篇是介绍在 Anaconda 环境下,创建 Scrapy 爬虫框架项目的步骤,且介绍比较详细 Python爬虫教程-31-创建 Scrapy 爬虫框架项目 首先说一下,本篇是在 Anaconda 环 ...
- 手把手教你如何新建scrapy爬虫框架的第一个项目(上)
前几天给大家分享了如何在Windows下创建网络爬虫虚拟环境及如何安装Scrapy,还有Scrapy安装过程中常见的问题总结及其对应的解决方法,感兴趣的小伙伴可以戳链接进去查看.关于Scrapy的介绍 ...
- python3.7.1安装Scrapy爬虫框架
python3.7.1安装Scrapy爬虫框架 环境:win7(64位), Python3.7.1(64位) 一.安装pyhthon 详见Python环境搭建:http://www.runoob.co ...
- 安装scrapy 爬虫框架
安装scrapy 爬虫框架 个人根据学习需要,在Windows搭建scrapy爬虫框架,搭建过程种遇到个别问题,共享出来作为记录. 1.安装python 2.7 1.1下载 下载地址 1.2配置环境变 ...
- scrapy爬虫框架教程(二)-- 爬取豆瓣电影
前言 经过上一篇教程我们已经大致了解了Scrapy的基本情况,并写了一个简单的小demo.这次我会以爬取豆瓣电影TOP250为例进一步为大家讲解一个完整爬虫的流程. 工具和环境 语言:python 2 ...
- Scrapy爬虫框架(实战篇)【Scrapy框架对接Splash抓取javaScript动态渲染页面】
(1).前言 动态页面:HTML文档中的部分是由客户端运行JS脚本生成的,即服务器生成部分HTML文档内容,其余的再由客户端生成 静态页面:整个HTML文档是在服务器端生成的,即服务器生成好了,再发送 ...
随机推荐
- SpringMVC提供两种校验机制
本文不讲如何使用SpringMVC提供的两种校验机制,只是简单的说明一下其中的差别而已: 1.创建一个Bean,在Bean的属性中添加校验信息,通过配置LocalValidatorFactoryBea ...
- 《java入门第一季》StringBuffer类小案例
/* * 把数组拼接成一个字符串 */ public class StringBufferTest2 { public static void main(String[] args) { // 定义一 ...
- 目前调试移动设备程序只能通过USB线缆
就像iOS,转移(到设备上)并调试App不可能通过WiFi或蓝牙连接. 一个有线的USB线缆连接现今主要用来调试. 确保你直接将Android设备插入Mac的USB接口,避免使用USB hubs和扩展 ...
- FFMPEG结构体分析:AVStream
注:写了一系列的结构体的分析的文章,在这里列一个列表: FFMPEG结构体分析:AVFrame FFMPEG结构体分析:AVFormatContext FFMPEG结构体分析:AVCodecConte ...
- LDA
2 Latent Dirichlet Allocation Introduction LDA是给文本建模的一种方法,它属于生成模型.生成模型是指该模型可以随机生成可观测的数据,LDA可以随机生成一篇由 ...
- LeetCode(62)-Two Sum
题目: Given an array of integers, return indices of the two numbers such that they add up to a specifi ...
- ubuntu12.04:Mysql数据库:自动安装
打开终端,输入下面命令: 1 sudo apt-get install mysql-server 2 sudo apt-get install mysql-client 一旦安装完成,MySQL 服务 ...
- masm的一些常用编译选项
ml命令行选项: /Dsymbol[=value] 定义给定名称的文本宏 /Fl 生成lst文件 /Sn lst文件中关闭符号表 /I 设置include文件的路径 /link 发送给link的连接器 ...
- ruby用来发送互联网邮件
其实只要你任性的可以,用telnet也是可以发邮件的哦.不过本猫没那么任性,还是用KISS原则来发邮件吧.本篇博文只介绍了如何发邮件,但没涉及收邮件的事,以后如有机会会单独开一篇博文介绍. ruby通 ...
- seo建站需要注意哪些
seo建站是搜索引擎优化的意思,通过seo建站技术,我们可以为站点带来可观的流量.那么,要怎样才能做好seo建站?seo建站优化过程中应该注意的事项有哪些?这些问题,是每一个站长都关心的.鉴于此,笔者 ...