
requests库爬取猫眼电影“最受期待榜”榜单 --网络爬虫
# coding:utf8

import requests, re, json

from requests.exceptions import RequestException

# from multiprocessing import Pool

# 获取页面

def get_one_page(url):

    try:

        resp = requests.get(url)

        if resp.status_code == requests.codes.ok:

            return resp.text

        else:

            return None

    except RequestException:

        return None

# 页面解析

def parse_one_page(html):

    pattern = re.compile('<dd>.*?board-index.*?>(\\d+)</i>.*?data-src="(.*?)"'

                         '.*?name"><a.*?">(.*?)</a>.*?star">(.*?)</p>.*?releasetime">(.*?)</p>'

                         '.*?</dd>', re.S)

    items = re.findall(pattern, html)  # result is a list,made up of tuples

    for item in items:

        # 生成字典

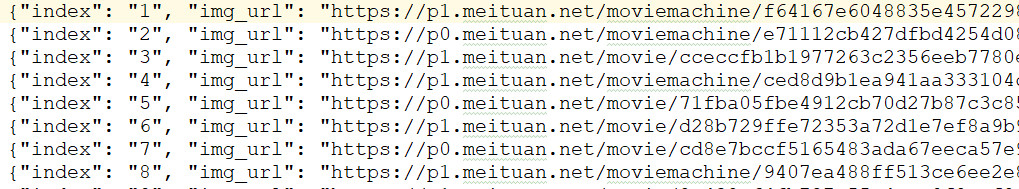
        yield {

            'index': item[0],

            'img_url': item[1],

            'title': item[2],

            'stars': item[3][3:],

            'releasetime': item[4],

        }

# 将爬取到的内容写入到文件中

def write_file(content):

    with open('content.txt', 'a', encoding='utf-8') as f:

        str_content = json.dumps(content, ensure_ascii=False)  # 转换成字符串

        f.write(str_content + '\n')

        f.close()

# 主函数

def main(offset):

    url = "https://maoyan.com/board/6/?offset=" + str(offset)

    html = get_one_page(url)

    for item in parse_one_page(html):

        write_file(item)

        print(item)

if __name__ == "__main__":

    # 请求5次

    for i in range(5):

        main(i * 10)
requests库爬取猫眼电影“最受期待榜”榜单 --网络爬虫的更多相关文章
- Python 爬取猫眼电影最受期待榜
主要爬取猫眼电影最受期待榜的电影排名.图片链接.名称.主演.上映时间. 思路:1.定义一个获取网页源代码的函数: 2.定义一个解析网页源代码的函数: 3.定义一个将解析的数据保存为本地文件的函数: ...
- 用requests库爬取猫眼电影Top100
这里需要注意一下,在爬取猫眼电影Top100时,网站设置了反爬虫机制,因此需要在requests库的get方法中添加headers,伪装成浏览器进行爬取 import requests from re ...
- python学习(23)requests库爬取猫眼电影排行信息
本文介绍如何结合前面讲解的基本知识,采用requests,正则表达式,cookies结合起来,做一次实战,抓取猫眼电影排名信息. 用requests写一个基本的爬虫 排行信息大致如下图 网址链接为ht ...
- PYTHON 爬虫笔记八:利用Requests+正则表达式爬取猫眼电影top100(实战项目一)
利用Requests+正则表达式爬取猫眼电影top100 目标站点分析 流程框架 爬虫实战 使用requests库获取top100首页: import requests def get_one_pag ...
- 一起学爬虫——使用xpath库爬取猫眼电影国内票房榜
之前分享了一篇使用requests库爬取豆瓣电影250的文章,今天继续分享使用xpath爬取猫眼电影热播口碑榜 XPATH语法 XPATH(XML Path Language)是一门用于从XML文件中 ...
- 利用Python3的requests和re库爬取猫眼电影笔记
以下笔记,作为参考借鉴,如有疑问可以联系我进行交流探讨! 代码思路很简单,简单概括为: 首先利用requests的get方法获取页面的html文件,之后对得到的html文件进行相对应的正则处理,然 ...
- Requests+正则表达式爬取猫眼电影
目标 提取出猫眼电影TOP100的电影名称.时间.评分.图片等信息,提取站点的URL为http://maoyan.com/board/4,提取的结果以文本的形式保存下来. 准备工作 请安装好reque ...
- Requests+正则表达式爬取猫眼电影(TOP100榜)
猫眼电影网址:www.maoyan.com 前言:网上一些大神已经对猫眼电影进行过爬取,所用的方法也是各有其优,最终目的是把影片排名.图片.名称.主要演员.上映时间与评分提取出来并保存到文件或者数据库 ...
- Python爬虫学习==>第十章:使用Requests+正则表达式爬取猫眼电影
学习目的: 通过一个一个简单的爬虫应用,初窥门径. 正式步骤 Step1:流程框架 抓取单页内容:利用requests请求目标站点,得到单个页面的html代码,返回结果: 正则表达式分析:根据html ...
随机推荐
- vue中上传文件之multipart/form-data
首先在项目里用了拦截器的,由于拦截器会将传递的参数转成对象,所以你i提交的时候会发现multipart/form-data或转变成application/json 其次关于input的文件上传是需要一 ...
- 《linux就该这么学》第十六节课:第16,17章,Squid服务和iscsi网络存储
第十六章 squid总结: 正向代理:yum 安装后清空防火墙即可正常使用,客户端设置浏览器 透明正向代理:vim /etc/squid/squid.conf 59行:http_port 312 ...
- Mac vs code 快捷键
control + shift + L 选中所有匹配的所有单词,光标选中
- spring boot 整合 百度ueditor富文本
百度的富文本没有提供Java版本的,只给提供了jsp版本,但是呢spring boot 如果是使用内置tomcat启动的话整合jsp是非常困难得,今天小编给大家带来spring boot整合百度富文本 ...
- 设置和获取cookie
通过make_response(“响应体”)创建response响应对象. 然后返回. 与直接return “响应体” 是一样的. 但是这里我们需要用到response响应对象,去设置cookie @ ...
- 关于MySQL数据库的安装和卸载
0.官网下载 https://www.mysql.com/ 选择需要的版本下载 两种安装方式,选择需要的安装包 下载 1.MySQL 5.6 for Windows 解压缩版配置安装 https:// ...
- 在userMapper.xml文件中模糊查询的常用的3种方法
在userMapper.xml文件中新建映射sql的标签 <!-- ******************** 模糊查询的常用的3种方式:********************* --> ...
- Java -- 基于JDK1.8的LinkedList源码分析
1,上周末我们一起分析了ArrayList的源码并进行了一些总结,因为最近在看Collection这一块的东西,下面的图也是大致的总结了Collection里面重要的接口和类,如果没有意外的话后面基本 ...
- vue-cli@2的原理解析
作为一个菜鸟,我有一颗好奇的心,每当vue init 的时候,看到那流畅的进度和神奇的结果,心里都充满一窥其本质的期望…… 以下就是我不断的console,大致理出来的一个流程心得,纪录在此,以作备忘 ...
- ECMAScript6 入门教程记录 变量的解构赋值
(1)变量的解构赋值 基本用法:ES6 允许按照一定模式,从数组和对象中提取值,对变量进行赋值,这被称为解构(Destructuring). let a = 1; let b = 2; let c = ...