
Scrapy教程--豆瓣电影图片爬取
一、先上效果

二、安装Scrapy和使用
官方网址:https://scrapy.org/。
安装命令:pip install Scrapy
安装完成,使用默认模板新建一个项目,命令:scrapy startproject xx
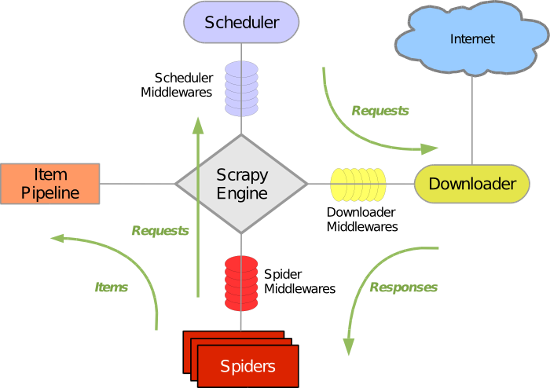
上图很形象的说明了,scrapy的运行机制。具体各部分的含义和作用,可自行百度,这里不再赘述。我们一般,需要做的是以下步骤。
1)配置settings,其他配置可根据自己的要求查看文档配置。
DEFAULT_REQUEST_HEADERS = {

    'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/60.0.3112.10 Safari/537.36'

}

DOWNLOAD_TIMEOUT = 30

IMAGES_STORE = 'Images'
2)定义items类,相当于Model类。如:
class CnblogImageItem(scrapy.Item):

    image = scrapy.Field()

    imagePath = scrapy.Field()

    name = scrapy.Field()
3)配置下载中间件,下载中间件的作用是自定义,怎么发请求。一般有处理代理的中间件、PhantomJs的中间件等。这里,我们只用到代理中间件。
class GaoxiaoSpiderMiddleware(object):

    def process_request(self, request, spider):

        if len(request.flags) > 0 and request.flags[0] == 'img':

            return None

        driver = webdriver.PhantomJS()

        # 设置全屏

        driver.maximize_window()

        driver.get(request.url)

        content = driver.page_source

        driver.quit()

        return HtmlResponse(request.url, encoding='utf-8', body=content)

class ProxyMiddleWare(object):

    def process_request(self, request, spider):

        request.meta['proxy'] = 'http://175.155.24.103:808'
4)编写pipeline,作用是处理从Spider中传过来的item,保存excel、数据库、下载图片等。这里给出我的下载图片代码,使用的是官方的下载图片框架。
class CnblogImagesPipeline(ImagesPipeline):

    IMAGES_STORE = get_project_settings().get("IMAGES_STORE")

    def get_media_requests(self, item, info):

        image_url = item['image']

        if image_url != '':

            yield scrapy.Request(str(image_url), flags=['img'])

    def item_completed(self, result, item, info):

        image_path = [x["path"] for ok, x in result if ok]

        if image_path:

            # 重命名

            if item['name'] != None and item['name'] != '':

                ext = os.path.splitext(image_path[0])[1]

                os.rename(self.IMAGES_STORE + '/' +

                          image_path[0], self.IMAGES_STORE + '/' + item['name'] + ext)

            item["imagePath"] = image_path

        else:

            item['imagePath'] = ''

        return item
5)编写自己的Spider类,Spider的作用是配置一些信息、起始url请求、处理响应数据。这里的下载中间件配置、pipeline,可以放在settings文件中。这里我放在,各自的Spider中,因为项目中包含多个Spider,相互之间用的下载中间件不同,因此分开配置了。
# coding=utf-8

import sys

import scrapy

import gaoxiao.items

import json

reload(sys)

sys.setdefaultencoding('utf-8')

class doubanSpider(scrapy.Spider):

    name = 'douban'

    allowed_domains = ['movie.douban.com']

    baseUrl = 'https://movie.douban.com/j/search_subjects?type=movie&tag=%E7%83%AD%E9%97%A8&sort=recommend&page_limit=20&page_start='

    start = 0

    start_urls = [baseUrl + str(start)]

    custom_settings = {

        'DOWNLOADER_MIDDLEWARES': {

            'gaoxiao.middlewares.ProxyMiddleWare': 1,

            #             'gaoxiao.middlewares.GaoxiaoSpiderMiddleware': 544

        },

        'ITEM_PIPELINES': {

            'gaoxiao.pipelines.CnblogImagesPipeline': 1,

        }

    }

    def parse(self, response):

        data = json.loads(response.text)['subjects']

        for i in data:

            item = gaoxiao.items.CnblogImageItem()

            if i['cover'] != '':

                item['image'] = i['cover']

                item['name'] = i['title']

            else:

                item['image'] = ''

            yield item

        if self.start < 400:

            self.start += 20

            yield scrapy.Request(self.baseUrl + str(self.start), callback=self.parse)
Scrapy教程--豆瓣电影图片爬取的更多相关文章
- 豆瓣电影信息爬取(json)
豆瓣电影信息爬取(json) # a = "hello world" # 字符串数据类型# b = {"name":"python"} # ...
- Python爬虫入门教程 8-100 蜂鸟网图片爬取之三
蜂鸟网图片--啰嗦两句 前几天的教程内容量都比较大,今天写一个相对简单的,爬取的还是蜂鸟,依旧采用aiohttp 希望你喜欢 爬取页面https://tu.fengniao.com/15/ 本篇教程还 ...
- Python爬虫入门教程 6-100 蜂鸟网图片爬取之一
1. 蜂鸟网图片--简介 国庆假日结束了,新的工作又开始了,今天我们继续爬取一个网站,这个网站为 http://image.fengniao.com/ ,蜂鸟一个摄影大牛聚集的地方,本教程请用来学习, ...
- Python爬虫入门教程 7-100 蜂鸟网图片爬取之二
蜂鸟网图片--简介 今天玩点新鲜的,使用一个新库 aiohttp ,利用它提高咱爬虫的爬取速度. 安装模块常规套路 pip install aiohttp 运行之后等待,安装完毕,想要深造,那么官方文 ...
- Python爬虫入门教程 5-100 27270图片爬取
27270图片----获取待爬取页面 今天继续爬取一个网站,http://www.27270.com/ent/meinvtupian/ 这个网站具备反爬,so我们下载的代码有些地方处理的也不是很到位, ...
- Python爬虫入门教程: 27270图片爬取
今天继续爬取一个网站,http://www.27270.com/ent/meinvtupian/ 这个网站具备反爬,so我们下载的代码有些地方处理的也不是很到位,大家重点学习思路,有啥建议可以在评论的 ...
- 豆瓣电影top250爬取并保存在MongoDB里
首先回顾一下MongoDB的基本操作: 数据库,集合,文档 db,show dbs,use 数据库名,drop 数据库 db.集合名.insert({}) db.集合名.update({条件},{$s ...
- scrapy爬虫框架教程(二)-- 爬取豆瓣电影TOP250
scrapy爬虫框架教程(二)-- 爬取豆瓣电影TOP250 前言 经过上一篇教程我们已经大致了解了Scrapy的基本情况,并写了一个简单的小demo.这次我会以爬取豆瓣电影TOP250为例进一步为大 ...
- 第一个nodejs爬虫:爬取豆瓣电影图片
第一个nodejs爬虫:爬取豆瓣电影图片存入本地: 首先在命令行下 npm install request cheerio express -save; 代码: var http = require( ...
随机推荐
- 什么是NoSQL
NoSQL = Not Only SQL 不仅仅是SQL NoSQL,指的是非关系型的数据库(没有声明性查询语言,没有预定义的模式,可以为键 - 值对存储,列存储,文档存储,图形数据库).不同于传统的 ...
- bigdecimal更精确的浮点处理方式
Java在java.math包中提供的API类BigDecimal,用来对超过16位有效位的数进行精确的运算.双精度浮点型变量double可以处理16位内有效数,超过16位,double可能会出现内存 ...
- 谈谈一些有趣的CSS题目(十五)-- 谈谈 CSS 关键字 initial、inherit 和 unset
开本系列,谈谈一些有趣的 CSS 题目,题目类型天马行空,想到什么说什么,不仅为了拓宽一下解决问题的思路,更涉及一些容易忽视的 CSS 细节. 解题不考虑兼容性,题目天马行空,想到什么说什么,如果解题 ...
- Linux配置tomcat (centos配置java环境 tomcat配置篇 总结三)
♣下载安装tomcat7 ♣设置启动和关闭 ♣设置用户名和密码 ♣发布java web项目 声明:这篇教程是建立在前两篇教程的基础上的,所以,还没安装工具和jdk,可以先看这个系列的前面两篇(去到文末 ...
- Java 别名(Aliasing)
别名 (Aliasing) 别名,顾名思义,是有别于现在名字的另一个名字,但指的是不是同一个人或事物呢?比如,你上学的时候同学有没有给你起什么外号?如果有的话,你的名字和同学给你起的外号是不是都指的是 ...
- [No0000E9]Microsoft Help Viewer 2.3绿色版
今天没事,提取了一下2017的Microsoft Help Viewer 2.3绿色版,自测没发现什么问题,有问题请后补. 下载地址:http://files.cnblogs.com/files/Ch ...
- java上转型和下转型(对象的多态性)
/*上转型和下转型(对象的多态性) *上转型:是子类对象由父类引用,格式:parent p=new son *也就是说,想要上转型的前提必须是有继承关系的两个类. *在调用方法的时候,上转型对象只能调 ...
- LVS+Keepalived实现DBProxy的高可用
背景 在上一篇文章美团点评DBProxy读写分离使用说明实现了读写分离,但在最后提了二个问题:一是代理不管MySQL主从的复制状态,二是DBProxy本身是一个单点的存在.对于第一个可以通过自己定义的 ...
- js小数处理
js中的小数处理 先说说Math的几个方法: 1.Math.floor(x) 返回不大于当前数的最大整数. 我的记法:floor 直译 地板 也就是不大于的的意思 (x-0.5 四舍五入取整 ...
- Jmeter察看结果树的响应数据中的中文显示乱码问题处理
1.Jmeter的察看结果树的响应数据有中文时会显示乱码,如图,我访问百度HTTP请求,响应数据中的title处是一串乱码 2.我们需要改一个设置,打开jmeter\bin\jmeter.proper ...