
Python Pandas库 初步使用
作业要求:用pandas+numpy读取UCI iris数据集中鸢尾花的萼片、花瓣长度数据,进行数据清理,去重,排序,并求出和、累积和、均值、标准差、方差、最大值、最小值
学习网站:Runoob
Pandas官方文档:pandas-docs
总共用时:1.5小时 (代码在最后面)
学习内容:pandas库基础
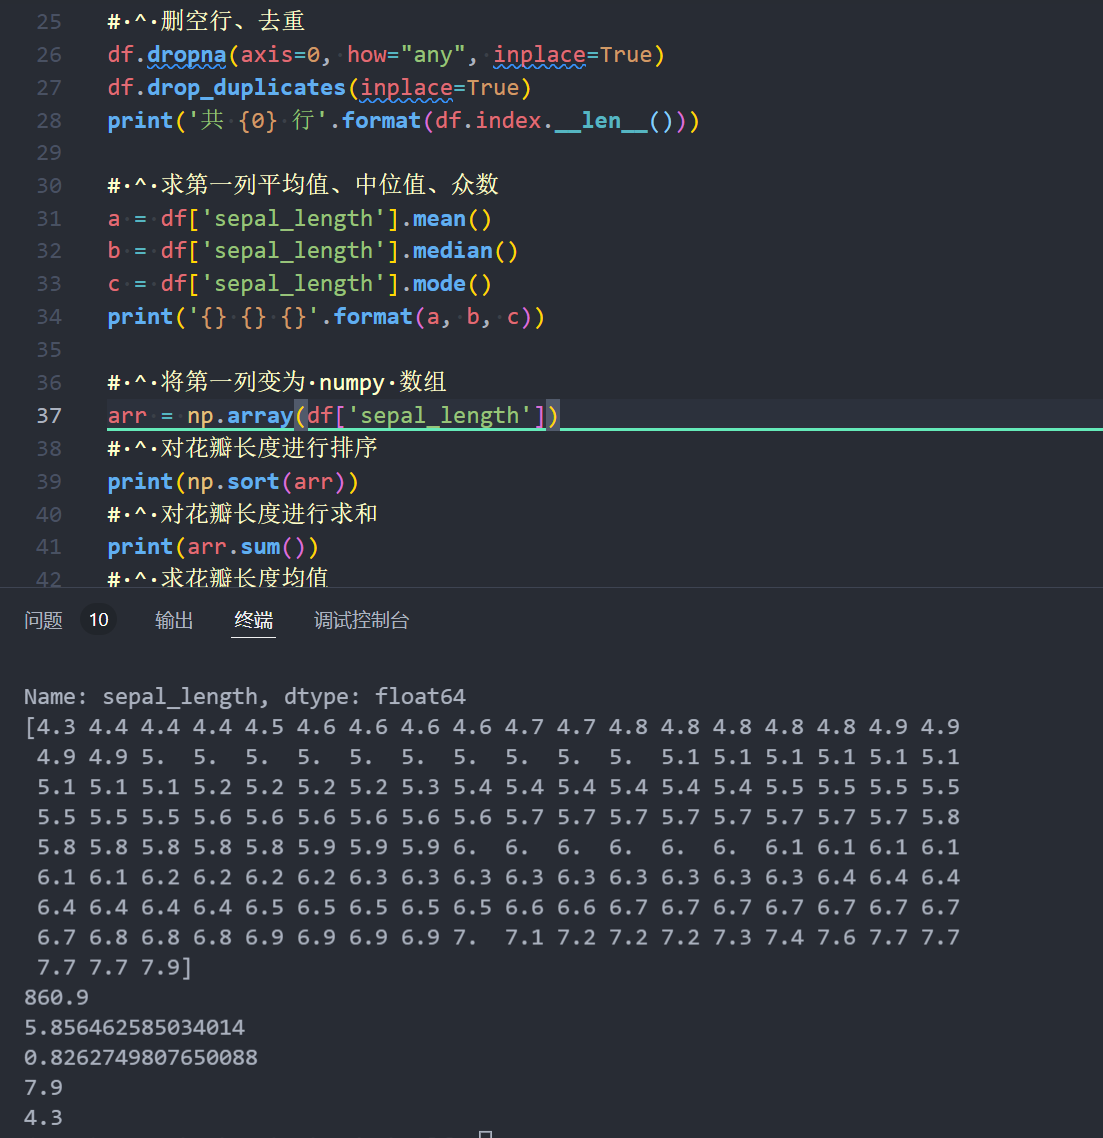
踩过的坑
1、关于Python pandas模块输出每行中间省略号问题
关于Python pandas模块输出每行中间省略号问题 - James·Sean - 博客园 (cnblogs.com)
pd.set_option('display.width', None)

pd.set_option('display.max_rows', None)
我的代码
work.py
import pandas as pd

import numpy as np

import requests

import sys

import os

path = os.path.dirname(__file__)

# ^ 阿里云OSS读取数据集文件

content = requests.get("https://xiaonenglife.oss-cn-hangzhou.aliyuncs.com/static/cnblogs/2020_3/iris.data")

if content.status_code != 200:

    print("不成功")

    sys.exit()  # ^ 退出程序

f = open(path+'iris.csv', 'w')

f.write(content.text)

f.close()

df = pd.read_csv(path+'iris.csv', names=['sepal_length', 'sepal_width', 'petal_length', 'petal_width', 'class'])

print(df)

print('共 {0} 行'.format(df.index.__len__()))

# ^ 删空行、去重

df.dropna(axis=0, how="any", inplace=True)

df.drop_duplicates(inplace=True)

print('共 {0} 行'.format(df.index.__len__()))

# ^ 求第一列平均值、中位值、众数

a = df['sepal_length'].mean()

b = df['sepal_length'].median()

c = df['sepal_length'].mode()

print('{} {} {}'.format(a, b, c))

# ^ 将第一列变为 numpy 数组

arr = np.array(df['sepal_length'])

# ^ 对花瓣长度进行排序

print(np.sort(arr))

# ^ 对花瓣长度进行求和

print(arr.sum())

# ^ 求花瓣长度均值

print(np.mean(arr))

# ^ 求花瓣长度标准差

print(np.std(arr))

# ^ 求花瓣长度最大值

print(np.max(arr))

# ^ 求花瓣长度最小值

print(np.min(arr))
study.py
# pip install pandas -i https://pypi.tuna.tsinghua.edu.cn/simple

import pandas as pd

import json

import os

path = os.path.dirname(__file__)

# f = open(path+'/data.json', 'r', encoding="utf-8")

# data = f.read()

# data = json.loads(data)

# pd.set_option('display.width', None)

# pd.set_option('display.max_rows', None)

# ^ 测试pandas

print(pd.__version__)

data = pd.read_json(path+'/data.json')

print(data)

# ^ Series

a = ["Google", "Runoob", "Wiki"]  # @ 数组

myvar = pd.Series(a, index=["x", "y", "z"])

print(myvar)

a = {1: "Google", 2: "Runoob", 3: "Wiki"}  # @ 字典

myvar = pd.Series(a)

print(myvar)

# ^ DataFrame

data = {

    "calories": [420, 380, 390],

    "duration": [50, 40, 45]

}

df = pd.DataFrame(data, index=["day1", "day2", "day3"])

print(df.loc["day2"])

data2 = [{'C': 'Google', 'A': 10, 'B': 93.5}, {'C': 'Runoob', 'A': 12, 'B': 89}]

df2 = pd.DataFrame(data2)

print(df2)

# ^ 打开 CSV 文件

df = pd.read_csv(path+'/iris.csv')

print(df.info())

# @ 返回前后 n 行,默认5行

print(df.head())

print(df.tail())
点赞是一种积极的生活态度,喵喵喵!(疯狂暗示)
Python Pandas库 初步使用的更多相关文章
- python pandas库——pivot使用心得
python pandas库——pivot使用心得 2017年12月14日 17:07:06 阅读数:364 最近在做基于python的数据分析工作,引用第三方数据分析库——pandas(versio ...
- Python Pandas库的学习(三)
今天我们来继续讲解Python中的Pandas库的基本用法 那么我们如何使用pandas对数据进行排序操作呢? food.sort_values("Sodium_(mg)",inp ...
- Python——Pandas库入门
一.Pandas库介绍 Pandas是Python第三方库,提供高性能易用数据类型和分析工具 import pandas as pd Pandas基于NumPy实现,常与NumPy和Matplotli ...
- Python pandas库159个常用方法使用说明
Pandas库专为数据分析而设计,它是使Python成为强大而高效的数据分析环境的重要因素. 一.Pandas数据结构 1.import pandas as pd import numpy as np ...
- Python Pandas库的学习(一)
今天我们来学习一下Pandas库,前面我们讲了Numpy库的学习 接下来我们学习一下比较重要的库Pandas库,这个库比Numpy库还重要 Pandas库是在Numpy库上进行了封装,相当于高级Num ...
- Python Pandas库的学习(二)
今天我们继续讲下Python中一款数据分析很好的库.Pandas的学习 接着上回讲到的,如果有人听不懂,麻烦去翻阅一下我前面讲到的Pandas学习(一) 如果我们在数据中,想去3,4,5这几行数据,那 ...
- Python Pandas 库的使用例子
主要在jupyter notebook里面熟悉这个库的使用,它的安装方法与实现,可自行搜索. Pandas是一个优秀的数据分析工具,官网:http://pandas.pydata.org/ 相关的库使 ...
- python pandas库的基本内容
pandas主要为数据预处理 DataFrame import pandas food_info = pandas.read_csv("路径") #绝对路径和相对路径都可以 ty ...
- Python之使用Pandas库实现MySQL数据库的读写
本次分享将介绍如何在Python中使用Pandas库实现MySQL数据库的读写.首先我们需要了解点ORM方面的知识. ORM技术 对象关系映射技术,即ORM(Object-Relational ...
随机推荐
- 面试官:Redis中的缓冲区了解吗
hello 大家好,我是七淅(xī). Redis 大家肯定不陌生,但在使用层面看不到的地方,就容易被忽略.今天想和大家分享的内容是 Redis 各个缓冲区的作用.溢出的后果及优化方向. 在开始正文前 ...
- Sobel算子 Scharr算子 Laplacian算子
图像梯度处理 Sobel算子 水平方向: 对于线条A和线条B,右侧像素值与左侧像素值的差值不为零,因此是边界 上下像素值差值为0,左右素值的差值不为零,分布为正负, 离的近的为2,离的远的为1 P5= ...
- spring——使用注解开发
注意:spring4之后,使用注解开发需要导入AOP包org.springframework:spring-aop:5.2.5.RELEASE以及context约束,增加注解的支持 <?xml ...
- python发送邮件之宝藏库yagmail
之前使用email模块+smtplib模块发送邮件,虽然可以实现功能,但过程比较繁琐,今天发现一个宝藏库(yagmail),可以说是炒鸡好用啦!!! 贴上实现代码,大家细品 yagmail安装 pip ...
- S2-045(RCE远程代码执行)
环境搭建: https://blog.csdn.net/qq_36374896/article/details/84145020 漏洞复现 进入漏洞环境 (048和045一样) cd vulhub-m ...
- python练习册 每天一个小程序 第0006题
1 # -*-coding:utf-8-*- 2 __author__ = 'Deen' 3 ''' 4 题目描述: 5 你有一个目录,放了你一个月的日记,都是 txt,为了避免分词的问题,假设内容都 ...
- 使用 Mosh 来优化 SSH 连接
1.什么是Mosh Mosh表示移动Shell(Mobile Shell),是一个用于从客户端跨互联网连接远程服务器的命令行工具.它能用于SSH连接,但是比Secure Shell功能更多.它是一个类 ...
- windows配置jdk环境变量、mysql环境变量、tomcat环境变量、maven环境变量、git环境变量、node环境变量
一.windows配置各种环境变量后 path 路径下的目录: 二.windows 配置各种环境变量的目的: 为windows系统添加上各种环境对应的命令 举例,为什么要添加jdk的bin目录,是因为 ...
- 【技术干货】华为云FusionInsight MRS的自研超级调度器Superior Scheduler
Superior Scheduler是一个专门为Hadoop YARN分布式资源管理系统设计的调度引擎,是针对企业客户融合资源池,多租户的业务诉求而设计的高性能企业级调度器. Superior Sch ...
- Spring cache源码分析
Spring cache是一个缓存API层,封装了对多种缓存的通用操作,可以借助注解方便地为程序添加缓存功能. 常见的注解有@Cacheable.@CachePut.@CacheEvict,有没有想过 ...